分页 KV Cache
推理引擎要解决的第一个工程问题是:成百上千个请求的 KV Cache 长短不一、随时增长、随时释放,怎样在固定大小的显存里放下它们。vLLM 的答案是 PagedAttention:像操作系统管理内存一样,把 KV Cache 切成固定大小的块,按需分配。这一章实现块池、按块存放的 K/V 张量、slot mapping 和一个分页注意力的参考实现,后面几章的迷你引擎都建立在它上面。
自测:能答上来就可以跳过本章
- 如果给每个请求按最大长度预留 KV Cache,显存利用率大约是多少?分页之后呢?
- 块表(block table)和 slot mapping 分别是什么?一个 token 的 K/V 写到哪里是怎么算出来的?
- 分页之后,注意力 kernel 需要多拿哪些输入?
- 块大小取 1、16、256 各有什么利弊?
自测参考答案(先自己答,再展开对照)
- 取决于请求长度的分布,本章的例子里按最大长度预留只有约 46% 的利用率;分页之后浪费只剩每个请求最后一个块的空余部分,块大小 16 时利用率约 99.6%。
- 块表把一个请求的逻辑块号映射到物理块号;slot mapping 给出本步每个新 token 的 K / V 要写到 KV 池的哪个位置:slot = 物理块号 × 块大小 + 块内偏移(位置 ÷ 块大小查块表,位置 % 块大小是偏移)。
- 每个请求的块表(逻辑块 → 物理块)、每个请求的上下文长度,以及区分各请求 query 的
cu_seqlens(和写 KV 用的 slot mapping)。 - 块大小 1:没有内部碎片、前缀缓存的粒度最细,但块表最长、元数据和 kernel 的间接寻址开销最大;16:常用的折中(vLLM 默认);256:块表短、kernel 访存连续,但内部碎片多、前缀只能按大块命中、传输和交换的粒度也粗。
先看一个六格小剧场,再读正文:
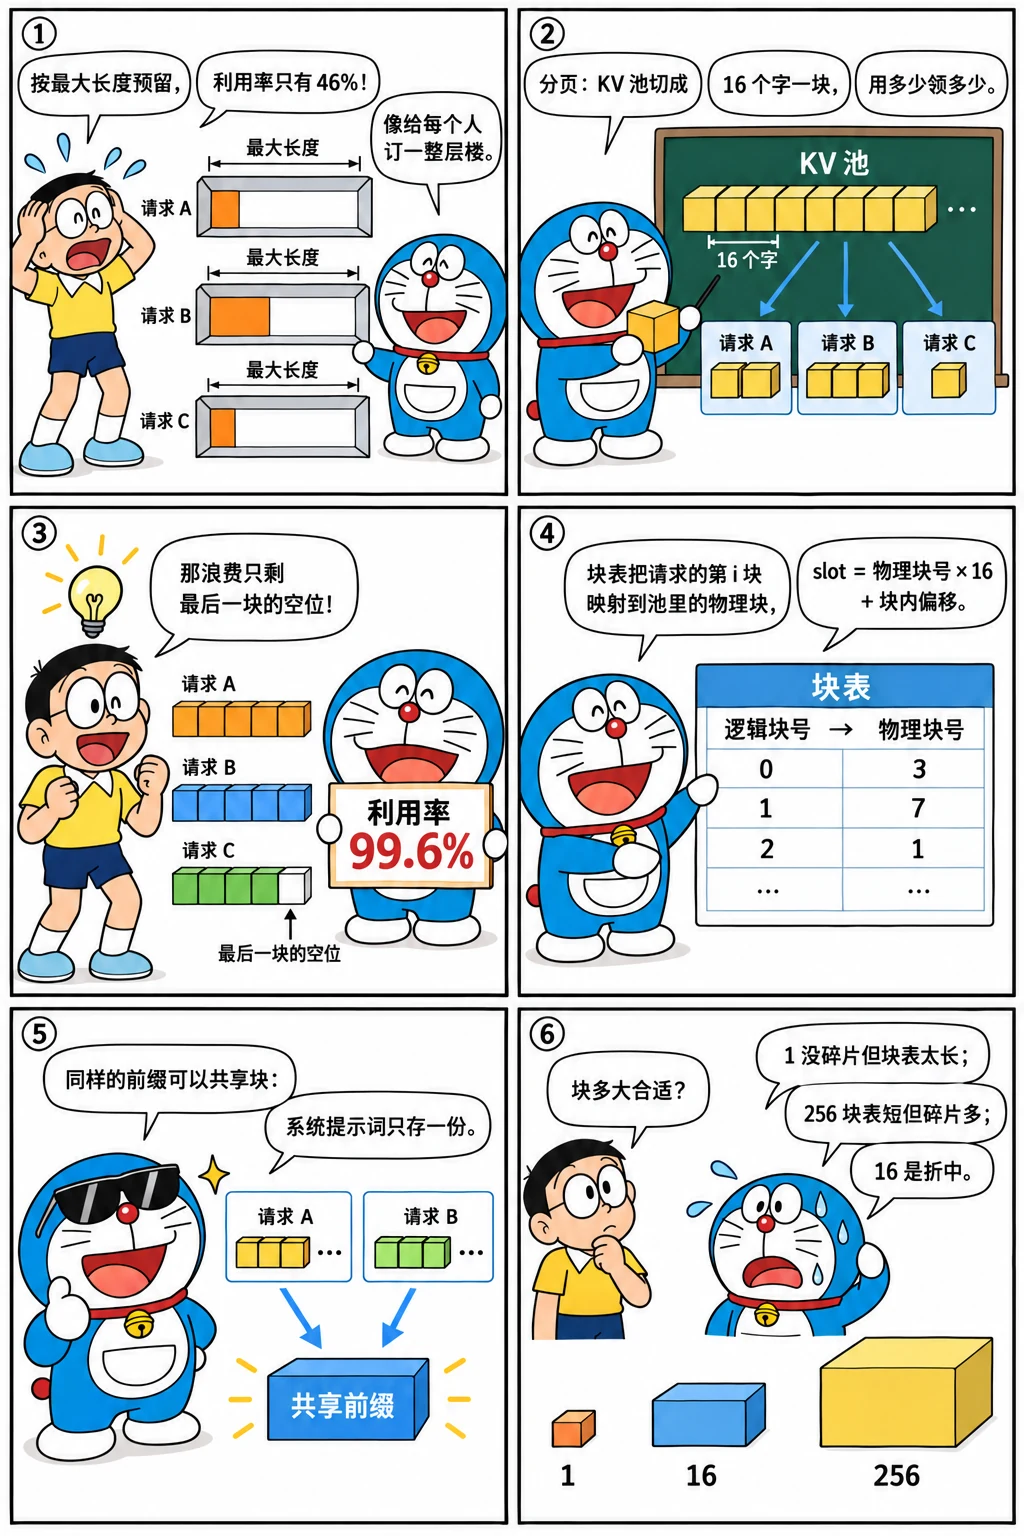
为什么要分页
最朴素的做法是给每个请求预留一段连续的显存,大小等于最大上下文长度。问题有三个:
- 预留浪费:请求实际用多长事先不知道,只能按最大值预留;
- 内部碎片:即使知道最终长度,生成过程中后面的空间也一直空着;
- 外部碎片:请求来来去去,空闲显存被切成大小不一的小段,放不下新的长请求。
用一个简单的负载估算一下:
import math
import random

random.seed(0)
max_len = 4096
reqs = [(random.randint(100, 2000), random.randint(20, 1500)) for _ in range(200)]   # (提示词长度, 输出长度)
used = sum(p + o for p, o in reqs)
print(f"按最大长度预留:利用率 {used / (len(reqs) * max_len):.1%}")
for block_size in (1, 16, 64, 256):
    allocated = sum(math.ceil((p + o) / block_size) * block_size for p, o in reqs)
    print(f"分页,块大小 {block_size:3d}:利用率 {used / allocated:.1%}")
拖一拖块大小和请求数,看浪费掉的到底是哪一部分:
按最大长度预留时,一半以上的显存都浪费了;分页之后,浪费只剩每个请求最后一个块里没用满的部分,平均半个块。vLLM 论文报告的数字是:已有系统有 60%~80% 的 KV Cache 显存被浪费,而 PagedAttention 的浪费不到 4%。省下来的显存可以容纳更多并发请求,吞吐几乎随 batch 线性增长,所以分页直接转化为吞吐。
实现
整个分页 KV Cache 由三部分组成:
- 块池:管理固定数量的物理块,记录哪些空闲、每个块被几个请求引用;
- KV 存储:每层一对形状为
[num_blocks, block_size, num_kv_heads, head_dim]的 K、V 张量; - 块表:每个请求一张表,第 i 项是它的第 i 个逻辑块所在的物理块号。
"""paged.py —— 分页 KV Cache:块池、按块存放的 K/V 张量、slot mapping,以及分页注意力的参考实现。

布局与 vLLM 的 FlashAttention 后端一致:每层一个 [num_blocks, block_size, num_kv_heads, head_dim] 的 K 和 V。
"""

import math
from collections import deque

import torch


class BlockPool:
    """管理固定数量的物理块:空闲队列 + 引用计数。"""

    def __init__(self, num_blocks: int):
        self.num_blocks = num_blocks
        self.ref_cnt = [0] * num_blocks
        self.free_queue = deque(range(num_blocks))

    def num_free(self) -> int:
        return len(self.free_queue)

    def allocate(self, n: int) -> list[int] | None:
        """取 n 个空闲块;不够就返回 None(由调度器决定是否抢占)。"""
        if n > len(self.free_queue):
            return None
        blocks = [self.free_queue.popleft() for _ in range(n)]
        for b in blocks:
            self.ref_cnt[b] = 1
        return blocks

    def free(self, blocks: list[int]) -> None:
        for b in blocks:
            self.ref_cnt[b] -= 1
            if self.ref_cnt[b] == 0:
                self.free_queue.append(b)


class PagedKVCache:
    """所有层的 K/V 存储。一个 token 的"地址"是 slot = 块号 × block_size + 块内偏移。"""

    def __init__(self, num_layers, num_blocks, block_size, num_kv_heads, head_dim, dtype=torch.float32):
        shape = (num_blocks, block_size, num_kv_heads, head_dim)
        self.k = [torch.zeros(shape, dtype=dtype) for _ in range(num_layers)]
        self.v = [torch.zeros(shape, dtype=dtype) for _ in range(num_layers)]
        self.block_size = block_size

    def write(self, layer: int, slot_mapping: torch.Tensor, k: torch.Tensor, v: torch.Tensor) -> None:
        """k, v: [N, num_kv_heads, head_dim],第 i 个 token 写到 slot_mapping[i]。"""
        self.k[layer].view(-1, *k.shape[1:])[slot_mapping] = k
        self.v[layer].view(-1, *v.shape[1:])[slot_mapping] = v

    def gather(self, layer: int, block_table: list[int], seq_len: int):
        """按块表取出一个序列的前 seq_len 个 token 的 K、V:[seq_len, num_kv_heads, head_dim]。"""
        blocks = torch.tensor(block_table[: math.ceil(seq_len / self.block_size)])
        k = self.k[layer][blocks].flatten(0, 1)[:seq_len]
        v = self.v[layer][blocks].flatten(0, 1)[:seq_len]
        return k, v


def slot_mapping_for(block_table: list[int], positions, block_size: int) -> list[int]:
    """位置 p 的 token 存在第 p // block_size 个逻辑块、块内偏移 p % block_size。"""
    return [block_table[p // block_size] * block_size + p % block_size for p in positions]


def paged_attention(q, kv: PagedKVCache, layer: int, block_tables, seq_lens, query_start_loc, scale: float):
    """变长、分页的因果注意力(参考实现,逐个请求计算)。

    q: [N, num_heads, head_dim],N 个新 token 来自 B 个请求,第 i 个请求的新 token 是
    q[query_start_loc[i]:query_start_loc[i+1]],它们是该请求上下文的最后几个 token(上下文总长 seq_lens[i])。
    """
    out = torch.empty_like(q)
    num_heads = q.shape[1]
    for i, (table, seq_len) in enumerate(zip(block_tables, seq_lens)):
        start, end = query_start_loc[i], query_start_loc[i + 1]
        num_new = end - start
        k, v = kv.gather(layer, table, seq_len)                        # [S, n_kv, hd]
        rep = num_heads // k.shape[1]                                  # GQA:每个 KV 头服务 rep 个 query 头
        k, v = k.repeat_interleave(rep, dim=1), v.repeat_interleave(rep, dim=1)
        scores = torch.einsum("thd,shd->hts", q[start:end], k) * scale  # [H, T, S]
        # 第 j 个新 token 的位置是 seq_len - num_new + j,只能看到不超过它的位置
        mask = torch.ones(num_new, seq_len, dtype=torch.bool).tril(diagonal=seq_len - num_new)
        probs = scores.masked_fill(~mask, float("-inf")).float().softmax(-1).to(q.dtype)
        out[start:end] = torch.einsum("hts,shd->thd", probs, v)
    return out
块表与 slot mapping
一个 token 在序列中的位置是 p,它属于第 p // block_size 个逻辑块,块内偏移 p % block_size;查块表得到物理块号 b,它的 K/V 就存在 slot b × block_size + p % block_size。每一步前向之前,引擎为本步所有新 token 算出一个 slot mapping 数组,注意力层按它把新的 K/V 写进缓存:
>>> from paged import BlockPool, slot_mapping_for
>>> pool = BlockPool(num_blocks=8)
>>> table = pool.allocate(3)            # 一个请求需要 3 个块
>>> table, pool.num_free()
([0, 1, 2], 5)
>>> other = pool.allocate(2)            # 另一个请求
>>> pool.free(table)                    # 第一个请求结束,块回到空闲队列末尾
>>> pool.allocate(4)                    # 新请求拿到的物理块不连续
[5, 6, 7, 0]
>>> slot_mapping_for([5, 6, 7, 0], positions=range(14), block_size=4)
[20, 21, 22, 23, 24, 25, 26, 27, 28, 29, 30, 31, 0, 1]
逻辑上连续的 14 个 token,物理上分散在 4 个不相邻的块里。这正是分页的意义:物理块可以任意分配,不需要连续的大段显存。
分页注意力
注意力计算时,每个请求要读到自己全部上下文的 K/V,而它们散落在多个物理块中。所以分页注意力 kernel 比普通注意力多三类输入:
| 输入 | 含义 |
|---|---|
block_tables |
每个请求的块表 |
seq_lens |
每个请求的上下文总长度(本步计算完之后) |
query_start_loc |
所有请求的新 token 首尾相接排成一维,第 i 个请求的 query 是 q[qsl[i]:qsl[i+1]](FlashAttention 里叫 cu_seqlens_q) |
上面的 paged_attention 是逐请求的参考实现:按块表把 K/V 收集成连续张量,再做普通的因果注意力。真实的 kernel 不会先收集再计算,而是在 kernel 内部按块表寻址、边读边算(参见 CUDA 手册的分页 decode attention),但数学上完全相同。
验证:三个请求处于不同阶段(decode 1 个 token、完整 prefill、分块 prefill 的后半段),物理块交错分配,把它们的 K/V 写进分页缓存,再和"连续存放 + 标准注意力"的结果比较:
import torch
import torch.nn.functional as F
from paged import BlockPool, PagedKVCache, paged_attention, slot_mapping_for

torch.manual_seed(0)
num_heads, num_kv_heads, head_dim, block_size = 8, 2, 64, 4
seq_lens, query_lens = [37, 5, 20], [1, 5, 8]          # decode、完整 prefill、分块 prefill 的后 8 个 token
pool = BlockPool(num_blocks=32)
kv = PagedKVCache(num_layers=1, num_blocks=32, block_size=block_size, num_kv_heads=num_kv_heads, head_dim=head_dim)

# 轮流给三个请求每次分一个块,让它们的物理块交错排列
tables = [[] for _ in seq_lens]
while any(len(t) * block_size < s for t, s in zip(tables, seq_lens)):
    for t, s in zip(tables, seq_lens):
        if len(t) * block_size < s:
            t += pool.allocate(1)
print("块表:", tables)

ks = [torch.randn(s, num_kv_heads, head_dim) for s in seq_lens]
vs = [torch.randn(s, num_kv_heads, head_dim) for s in seq_lens]
for t, k, v in zip(tables, ks, vs):
    kv.write(0, torch.tensor(slot_mapping_for(t, range(len(k)), block_size)), k, v)

qs = [torch.randn(n, num_heads, head_dim) for n in query_lens]
qsl = [0]
for n in query_lens:
    qsl.append(qsl[-1] + n)
out = paged_attention(torch.cat(qs), kv, 0, tables, seq_lens, qsl, scale=head_dim ** -0.5)

for i, (q, k, v, s, n) in enumerate(zip(qs, ks, vs, seq_lens, query_lens)):
    rep = num_heads // num_kv_heads
    mask = torch.ones(n, s, dtype=torch.bool).tril(diagonal=s - n)   # 新 token 位于序列末尾
    ref = F.scaled_dot_product_attention(q.transpose(0, 1), k.repeat_interleave(rep, 1).transpose(0, 1),
                                         v.repeat_interleave(rep, 1).transpose(0, 1), attn_mask=mask)
    err = (out[qsl[i]:qsl[i + 1]] - ref.transpose(0, 1)).abs().max().item()
    print(f"请求 {i}:上下文 {s},新 token {n},与连续存放的最大误差 {err:.1e}")
    assert err < 1e-5
块表: [[0, 3, 6, 8, 10, 12, 13, 14, 15, 16], [1, 4], [2, 5, 7, 9, 11]]
请求 0:上下文 37,新 token 1,与连续存放的最大误差 2.1e-07
请求 1:上下文 5,新 token 5,与连续存放的最大误差 2.4e-07
请求 2:上下文 20,新 token 8,与连续存放的最大误差 4.2e-07
块大小怎么选
| 块大小 | 优点 | 缺点 |
|---|---|---|
| 小(1~8) | 几乎没有内部碎片;前缀缓存可以精确到 token | 块表很长、元数据多;kernel 每次只能连续读很少的数据,访存效率低 |
| 中(16~64) | 两者兼顾,vLLM 默认 16 | 平均每个请求浪费半个块 |
| 大(128 以上) | 连续读取,kernel 效率高;块表短 | 碎片多;前缀缓存的粒度粗,短前缀无法共享 |
实际的块大小还受 kernel 约束:FlashAttention 的分页 KV 要求块大小是 16 的倍数,FlashMLA 使用 64,FlashInfer 支持任意页大小(包括 1)。SGLang 历史上默认页大小为 1(按 token 管理),配合它的基数树实现 token 粒度的前缀共享。
源码对照
- vLLM:块池是
vllm/v1/core/block_pool.py中的BlockPool。空闲块放在一个双向链表FreeKVCacheBlockQueue(kv_cache_utils.py)中,便于 O(1) 地从中间摘除被前缀缓存命中的块。块 0 被保留为null_block,给 padding 使用。每个请求的块由KVCacheManager.allocate_slots分配。worker 端的vllm/v1/worker/block_table.py维护块表,并用一个 Triton kernel 计算 slot mapping(compute_slot_mapping)。 - vLLM 0.30 中,FlashAttention 后端的 KV 张量形状是
[num_blocks, num_kv_heads, block_size, 2 * head_size](K、V 拼在最后一维)。所有后端的逻辑布局统一描述为[L, B, H, N, C],物理排列由KVCacheLayout(vllm/v1/kv_cache_layout.py)决定。不同的注意力后端要求不同的布局,这也是 PD 分离时传输 KV 需要做布局转换的原因。 - SGLang:两级映射。
ReqToTokenPool(mem_cache/memory_pool.py)记录每个请求第 i 个 token 的 KV 槽位,TokenToKVPoolAllocator家族(mem_cache/allocator/)负责分配槽位,MHATokenToKVPool等类持有真正的 K/V 张量。
怎么讲清楚
讲分页 KV:按最大长度给每个请求预留 KV,大部分显存被"可能用到"的空间占着,利用率很低;分页后按块(vLLM 默认 16 个 token)按需分配,浪费只剩最后一个块的空余。块池管理物理块和引用计数(共享前缀、写时复制),块表把请求的逻辑块映射到物理块,一个 token 写到 slot = 块号 × 块大小 + 块内偏移。注意力 kernel 多拿三类输入:块表、各请求的上下文长度、cu_seqlens,数学上和连续存放完全相同。块大小在碎片、kernel 效率和前缀缓存的粒度之间权衡:块越大元数据越少、访存越连续,但尾部浪费和前缀复用的粒度变差,SGLang 可以用 1。
练习
1. 并发数估算。 Qwen2.5-7B(28 层、4 个 KV 头、head_dim 128,BF16)部署在一张 80 GB 的卡上,权重约 15 GB,预留 10 GB 给激活和其他开销。平均上下文 3000 token 时,分页(块大小 16)能容纳多少并发请求?如果按最大上下文 32K 预留呢?
参考答案
kv_per_token = 2 * 28 * 4 * 128 * 2                     # 57344 字节 = 56 KB
budget = (80 - 15 - 10) * 1024**3
paged = budget // (math.ceil(3000 / 16) * 16 * kv_per_token)
prealloc = budget // (32768 * kv_per_token)
print(f"每 token {kv_per_token // 1024} KB;分页约 {paged} 个并发,按 32K 预留只有 {prealloc} 个")
分页让并发数提高了约 10 倍。这也说明了为什么 GQA 这类减少 KV 的结构对服务如此重要。
2. 写时复制。 并行采样(n > 1)时,同一个提示词要生成多个回答。怎样利用块池的引用计数,让它们共享提示词的 KV Cache?当某个回答要往一个共享块里写新 token 时,怎么办?
参考答案
提示词的块只计算一次,每个回答的块表都指向这些物理块,引用计数等于回答数。生成时,如果要写入的块引用计数大于 1(被共享),就先分配一个新块、把旧块的内容复制过去,再写入新块,旧块的引用计数减 1。这就是写时复制(copy-on-write)。装满的提示词块永远不会再被写入,所以只有最后一个没装满的块可能需要复制。vLLM V1 的做法更简单:只共享装满的块,每个回答从自己的块开始写。
小结
- 按最大长度预留 KV Cache,显存利用率很低;分页后浪费只剩最后一个块的空余部分。
- 块池管理物理块和引用计数;块表把逻辑块映射到物理块;slot = 块号 × 块大小 + 块内偏移。
- 分页注意力多了块表、上下文长度和
cu_seqlens三类输入,数学上与连续存放完全相同。 - 块大小在碎片、kernel 效率和前缀缓存粒度之间权衡,vLLM 默认 16,SGLang 可以到 1。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题