张量并行:从零实现
一张卡放不下模型、或者单卡太慢时,第一选择通常是张量并行(TP):把每一层的矩阵切开,分给多张卡同时计算。这一章按 Megatron-LM 的方式,从零实现一个张量并行的 Qwen3-0.6B:列切分、行切分、按头切分的注意力、词表切分的嵌入与输出层。用 torchrun 在 CPU 上启动两个进程,验证它与单进程的输出一致,再估算真实部署中通信的代价。
自测:能答上来就可以跳过本章
- MLP 的三个矩阵怎样切分,才能让整个 MLP 只需要一次 all-reduce?
- 注意力为什么按头切分?KV Cache 怎么切?TP 大于 KV 头数时怎么办?
- 一个 Transformer 层在 TP 下有几次通信?通信量和什么成正比?
- 为什么 TP 通常只在一台机器内部使用?
自测参考答案(先自己答,再展开对照)
- gate、up 按输出维(列)切,down 按输入维(行)切:列切分各算一部分中间特征、不需要通信,激活逐元素计算,down 的行切分正好接上自己那部分特征,得到部分和,最后一次 all-reduce。
- 每个头的注意力是独立计算的,按头切分后各卡算自己的头,不需要中间通信;KV Cache 随 KV 头一起切分,每张卡只存自己的头。TP 大于 KV 头数时,KV 头要复制到多张卡上(每张卡至少一个)。
- 两次 all-reduce(注意力的输出投影之后、MLP 之后)。每次的数据量和本步的 token 数 × hidden 成正比;decode 时消息小、受延迟主导,prefill 时消息大、受带宽主导。
- 每层两次 all-reduce 在关键路径上,只有机内的 NVLink(每卡单向约 450 GB/s)够快,跨机的网卡只有约 50 GB/s,而且延迟更高;跨机器通常改用流水线并行、专家并行或数据并行。
先看一个六格小剧场,再读正文:
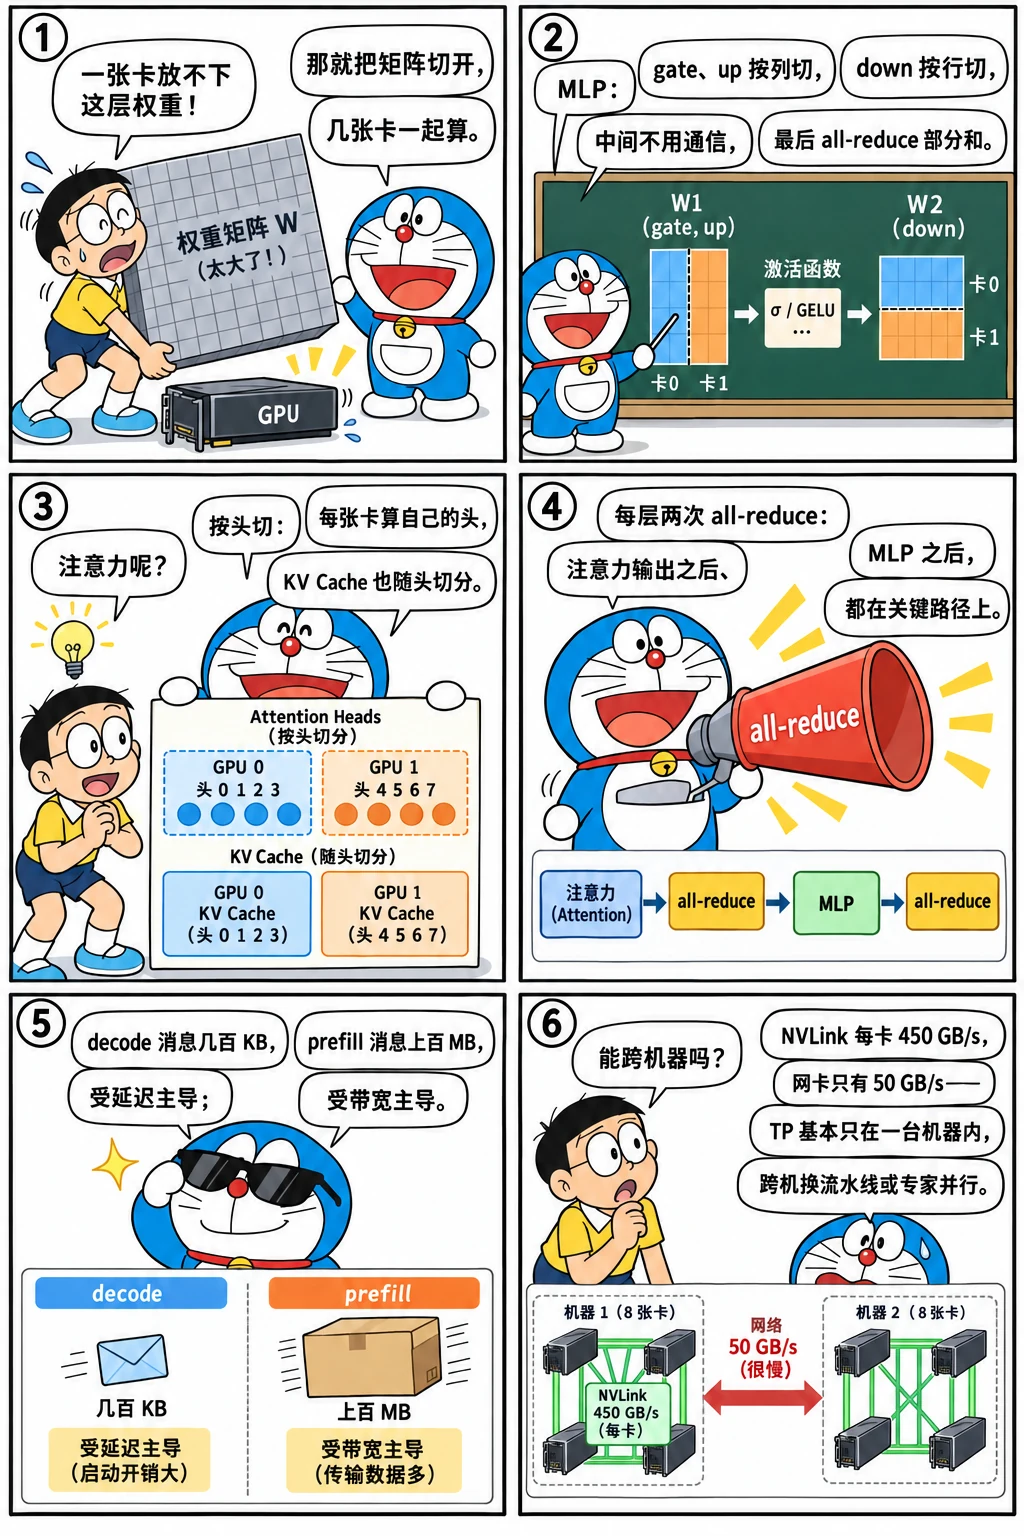
两种切法
一个线性层 \(Y = XW\),\(W\) 的形状是 [输入维, 输出维],有两种切法:
- 列切分(column parallel):把 \(W\) 按输出维切成 \([W_1, W_2]\),第 i 张卡算 \(Y_i = XW_i\)。每张卡得到输出的一段,不需要通信,但每张卡都要有完整的输入 \(X\)。
- 行切分(row parallel):把 \(W\) 按输入维切成 \(\begin{bmatrix}W_1 \\ W_2\end{bmatrix}\),第 i 张卡用输入的第 i 段算 \(X_iW_i\)。每张卡得到的是一个部分和,要 all-reduce(把各卡的结果相加)才是完整的 \(Y\)。
Megatron 的关键观察:列切分之后接行切分,中间不需要通信。列切分的输出恰好是行切分需要的"输入的一段"。于是:
- MLP:
gate_proj、up_proj列切分,silu(gate) * up是逐元素的,在各卡本地完成,down_proj行切分,最后一次 all-reduce; - 注意力:
q/k/v_proj列切分,而且按头切(每张卡拿完整的若干个头),各卡独立计算自己那些头的注意力,o_proj行切分,最后一次 all-reduce。
每层两次 all-reduce,其余全部本地计算。KV Cache 也随之切开:每张卡只存自己负责的 KV 头。
                 x(每张卡都有完整的一份)
        ┌────────────────┴────────────────┐
  卡 0:q/k/v 的第 0~6 个头            卡 1:q/k/v 的第 7~13 个头      ← 列切分,无通信
        │ 注意力(本地 KV Cache:KV 头 0)      │ 注意力(本地 KV Cache:KV 头 1)
  o_proj 的第 0 段输入 → 部分和          o_proj 的第 1 段输入 → 部分和    ← 行切分
        └──────────── all-reduce 求和 ─────┘
                 x + attn(每张卡又都有完整的一份)
嵌入层和输出层按词表切分:每张卡存一段词表;嵌入时,不在本卡词表段内的 token 查出 0,all-reduce 之后得到完整的嵌入;输出层每张卡算出一段 logits,再 all-gather 拼起来。
实现
"""tp.py —— 从零实现张量并行(Megatron 式),在 CPU 上用 gloo 后端跑多进程。

用法:torchrun --nproc-per-node 2 --master-addr 127.0.0.1 --master-port 29500 tp.py
每个进程只持有 1/tp 的权重和 KV Cache,每层两次 all-reduce;rank 0 与单进程的完整模型比较输出。
"""

import os
import time

import torch
import torch.distributed as dist
import torch.nn as nn
import torch.nn.functional as F

from mini_llm import KVCache, RMSNorm, Transformer, apply_rope, rope_cos_sin

NUM_ALL_REDUCE = 0


def all_reduce(x: torch.Tensor) -> torch.Tensor:
    global NUM_ALL_REDUCE
    NUM_ALL_REDUCE += 1
    dist.all_reduce(x)                     # 默认求和:把各 rank 的部分结果加起来
    return x


class ColumnParallelLinear(nn.Module):
    """按输出维切分:每个 rank 算输出的一段,不需要通信。"""

    def __init__(self, full: nn.Linear, rank: int, world: int, rows: torch.Tensor):
        super().__init__()
        self.weight = nn.Parameter(full.weight[rows].clone())
        self.bias = nn.Parameter(full.bias[rows].clone()) if full.bias is not None else None

    def forward(self, x):
        return F.linear(x, self.weight, self.bias)


class RowParallelLinear(nn.Module):
    """按输入维切分:每个 rank 用自己那段输入算出一个"部分和",all-reduce 后才是完整结果。"""

    def __init__(self, full: nn.Linear, rank: int, world: int, cols: torch.Tensor):
        super().__init__()
        self.weight = nn.Parameter(full.weight[:, cols].clone())
        assert full.bias is None

    def forward(self, x):
        return all_reduce(F.linear(x, self.weight))


class VocabParallelEmbedding(nn.Module):
    """词表切分:每个 rank 只存一段词表;不在本段的 token 查出 0,all-reduce 后得到完整的嵌入。"""

    def __init__(self, full: nn.Embedding, rank: int, world: int):
        super().__init__()
        per = (full.num_embeddings + world - 1) // world
        self.start, self.end = rank * per, min((rank + 1) * per, full.num_embeddings)
        self.weight = nn.Parameter(full.weight[self.start:self.end].clone())

    def forward(self, ids):
        mask = (ids < self.start) | (ids >= self.end)
        out = F.embedding((ids - self.start).masked_fill(mask, 0), self.weight)
        return all_reduce(out.masked_fill(mask[..., None], 0.0))


class TPAttention(nn.Module):
    """按头切分:每个 rank 负责 nh/tp 个 query 头和 nkv/tp 个 KV 头,KV Cache 也只存自己的头。"""

    def __init__(self, attn, cfg, rank: int, world: int):
        super().__init__()
        hd = cfg.hd
        self.nh, self.nkv, self.hd = cfg.num_attention_heads // world, cfg.num_key_value_heads // world, hd
        q_rows = torch.arange(rank * self.nh * hd, (rank + 1) * self.nh * hd)
        kv_rows = torch.arange(rank * self.nkv * hd, (rank + 1) * self.nkv * hd)
        self.q_proj = ColumnParallelLinear(attn.q_proj, rank, world, q_rows)
        self.k_proj = ColumnParallelLinear(attn.k_proj, rank, world, kv_rows)
        self.v_proj = ColumnParallelLinear(attn.v_proj, rank, world, kv_rows)
        self.o_proj = RowParallelLinear(attn.o_proj, rank, world, q_rows)
        self.q_norm, self.k_norm = attn.q_norm, attn.k_norm     # QK-Norm 按头做、权重只有 head_dim 维:每个 rank 存完整的一份
        self.layer = attn.layer

    def forward(self, x, cos, sin, cache):
        B, T, _ = x.shape
        q = self.q_proj(x).view(B, T, self.nh, self.hd).transpose(1, 2)
        k = self.k_proj(x).view(B, T, self.nkv, self.hd).transpose(1, 2)
        v = self.v_proj(x).view(B, T, self.nkv, self.hd).transpose(1, 2)
        q, k = self.q_norm(q), self.k_norm(k)
        q, k = apply_rope(q, cos, sin), apply_rope(k, cos, sin)
        k, v = cache.update(self.layer, k, v)
        S = k.shape[2]
        rep = self.nh // self.nkv
        k, v = k.repeat_interleave(rep, dim=1), v.repeat_interleave(rep, dim=1)
        mask = torch.ones(T, S, dtype=torch.bool).tril(diagonal=S - T)
        out = F.scaled_dot_product_attention(q, k, v, attn_mask=mask)
        return self.o_proj(out.transpose(1, 2).reshape(B, T, self.nh * self.hd))


class TPMLP(nn.Module):
    """gate/up 按列切分,down 按行切分:中间的 SiLU × up 在各 rank 本地完成,整个 MLP 只需一次 all-reduce。"""

    def __init__(self, mlp, rank: int, world: int):
        super().__init__()
        n = mlp.gate_proj.out_features // world
        rows = torch.arange(rank * n, (rank + 1) * n)
        self.gate_proj = ColumnParallelLinear(mlp.gate_proj, rank, world, rows)
        self.up_proj = ColumnParallelLinear(mlp.up_proj, rank, world, rows)
        self.down_proj = RowParallelLinear(mlp.down_proj, rank, world, rows)

    def forward(self, x):
        return self.down_proj(F.silu(self.gate_proj(x)) * self.up_proj(x))


class TPTransformer(nn.Module):
    def __init__(self, full: Transformer, rank: int, world: int):
        super().__init__()
        cfg = self.cfg = full.cfg
        assert cfg.num_attention_heads % world == 0 and cfg.num_key_value_heads % world == 0
        self.world = world
        self.embed_tokens = VocabParallelEmbedding(full.embed_tokens, rank, world)
        self.layers = nn.ModuleList()
        for layer in full.layers:
            new = nn.Module()
            new.input_layernorm, new.post_attention_layernorm = layer.input_layernorm, layer.post_attention_layernorm
            new.self_attn = TPAttention(layer.self_attn, cfg, rank, world)
            new.mlp = TPMLP(layer.mlp, rank, world)
            self.layers.append(new)
        self.norm = full.norm
        # 输出层按词表切分(与嵌入共享权重时就是嵌入的那一段),各 rank 算出一段 logits 再 all-gather
        self.lm_head_weight = self.embed_tokens.weight if cfg.tie_word_embeddings else \
            nn.Parameter(full.lm_head.weight[self.embed_tokens.start:self.embed_tokens.end].clone())

    def forward(self, ids, cache):
        start = cache.length
        cos, sin = rope_cos_sin(torch.arange(start, start + ids.shape[1]), self.cfg.hd, self.cfg.rope_theta)
        x = self.embed_tokens(ids)
        for layer in self.layers:
            x = x + layer.self_attn(layer.input_layernorm(x), cos, sin, cache)
            x = x + layer.mlp(layer.post_attention_layernorm(x))
        local = F.linear(self.norm(x[:, -1:]), self.lm_head_weight)       # 只算最后一个位置
        parts = [torch.empty_like(local) for _ in range(self.world)]
        dist.all_gather(parts, local)
        return torch.cat(parts, dim=-1)[..., : self.cfg.vocab_size]


def main():
    dist.init_process_group("gloo")
    rank, world = dist.get_rank(), dist.get_world_size()
    torch.set_num_threads(max(1, int(os.environ.get("THREADS", "8"))))
    full = Transformer.from_pretrained(os.environ.get("MODEL", "models/Qwen3-0.6B"))
    ids = torch.tensor([[151644, 872, 198, 105043, 100165, 11319, 151645, 198, 151644, 77091, 198, 151667, 271, 151668, 271]])  # "你是谁?"的对话模板(关闭思考)
    model = TPTransformer(full, rank, world)
    n_local = sum(p.numel() for p in model.parameters())

    global NUM_ALL_REDUCE
    with torch.no_grad():
        cache, tokens = KVCache(full.cfg.num_hidden_layers), []
        logits = model(ids, cache)
        prefill_all_reduce = NUM_ALL_REDUCE
        for _ in range(20):
            nxt = logits[0, -1].argmax().item()
            tokens.append(nxt)
            logits = model(torch.tensor([[nxt]]), cache)
    kv_heads_local = cache.k[0].shape[1]

    if rank == 0:
        with torch.no_grad():
            ref_cache, ref_tokens = KVCache(full.cfg.num_hidden_layers), []
            ref_logits = full(ids, ref_cache)[:, -1:]
            for _ in range(20):
                nxt = ref_logits[0, -1].argmax().item()
                ref_tokens.append(nxt)
                ref_logits = full(torch.tensor([[nxt]]), ref_cache)[:, -1:]
        n_full = sum(p.numel() for p in full.parameters())
        print(f"TP={world}:每个 rank 持有 {n_local / 1e6:.0f}M 参数(完整模型 {n_full / 1e6:.0f}M),"
              f"每层 KV Cache 存 {kv_heads_local} 个 KV 头(共 {full.cfg.num_key_value_heads} 个)")
        print(f"prefill 一次前向的 all-reduce 次数:{prefill_all_reduce}({full.cfg.num_hidden_layers} 层 × 2 + 嵌入 1)")
        print(f"最后一步 logits 与单进程的最大误差:{(logits[0, -1] - ref_logits[0, -1]).abs().max().item():.1e}")
        print(f"贪心生成 20 个 token 与单进程一致:{tokens == ref_tokens}")
    dist.destroy_process_group()


if __name__ == "__main__":
    main()
权重是直接从完整模型上切下来的:ColumnParallelLinear 取权重矩阵的若干行(PyTorch 的 nn.Linear 权重形状是 [输出维, 输入维],所以按输出维切就是取行),RowParallelLinear 取若干列。RMSNorm 的权重很小,每张卡都存一份完整的。
用 torchrun 启动两个进程(CPU 上用 gloo 通信后端,GPU 上换成 NCCL 即可):
import os
import socket
import subprocess
import sys

with socket.socket() as s:                       # 找一个空闲端口。不用 --standalone:它要做主机名的反向解析,macOS 上常常卡住
    s.bind(("127.0.0.1", 0))
    port = s.getsockname()[1]
env = {**os.environ, "OMP_NUM_THREADS": "8", "THREADS": "8"}
result = subprocess.run([sys.executable, "-m", "torch.distributed.run", "--nproc-per-node", "2",
                         "--master-addr", "127.0.0.1", "--master-port", str(port), "build/code/tp.py"],
                        capture_output=True, text=True, env=env, timeout=1200)
print(result.stdout.strip())
assert "一致:True" in result.stdout
TP=2:每个 rank 持有 298M 参数(完整模型 596M),每层 KV Cache 存 4 个 KV 头(共 8 个)
prefill 一次前向的 all-reduce 次数:57(28 层 × 2 + 嵌入 1)
最后一步 logits 与单进程的最大误差:1.4e-05
贪心生成 20 个 token 与单进程一致:True
每个进程只持有一半的参数和一半的 KV Cache,每层两次 all-reduce,结果与单进程一致(误差来自求和顺序的不同)。
KV 头数与 TP 的上限
按头切分要求头数能被 TP 整除。Qwen3-0.6B 有 16 个 query 头、8 个 KV 头,TP 可以取 2、4、8;再往上,KV 头就不够分了。更一般的情况:
- query 头数必须能被 TP 整除:Qwen2.5-7B 有 28 个头,不能做 TP=8(推理引擎会直接报错);
- TP 大于 KV 头数时,KV 头要复制:比如 8 个 KV 头的模型做 TP=16,每两张卡共用同一个 KV 头,各存一份。KV Cache 的总显存翻倍,这部分显存被浪费了;
- MLA 的潜在向量无法按头切分:每张卡都要存完整的潜在 KV,TP 越大浪费越多,这就是 DeepSeek 类模型更倾向于 DP Attention 的原因。
通信的代价
TP 每层两次 all-reduce,每次的数据量是 token 数 × hidden × 2 字节(BF16)。ring all-reduce 的时间约为 \(\alpha + 2\frac{n-1}{n} \cdot \frac{\text{数据量}}{\text{总线带宽}}\),其中 \(\alpha\) 是启动延迟。估算 LLaMA-3-70B(80 层、hidden 8192)在 8 张 H100 上做 TP 时的通信时间(假设 NVLink 上 all-reduce 的总线带宽约 360 GB/s,每次调用固定延迟约 10 μs):
hidden, layers, tp = 8192, 80, 8
busbw, alpha = 360e9, 10e-6

def comm_ms(tokens):
    size = tokens * hidden * 2
    return 2 * layers * (alpha + 2 * (tp - 1) / tp * size / busbw) * 1e3

decode_compute = 70.55e9 * 2 / tp / 3.35e12 * 1e3                    # 每卡读 1/8 的权重
prefill_compute = 2 * 70.55e9 * 4096 / (tp * 989e12 * 0.5) * 1e3     # MFU 50%
print(f"decode(batch 64):通信约 {comm_ms(64):.1f} ms,读权重的下限 {decode_compute:.1f} ms")
print(f"prefill(4096 token):通信约 {comm_ms(4096):.0f} ms,计算约 {prefill_compute:.0f} ms")
几个结论:
- decode 时通信由延迟主导:每次只传 1 MB,时间主要花在 160 次调用的固定开销上,占到计算时间的近一半。所以推理引擎都实现了针对小消息优化的 all-reduce(vLLM 的 custom all-reduce、SGLang 的 custom all-reduce 与 FlashInfer 的 all-reduce 融合),用 one-shot/two-shot 算法、利用 NVLink 的 P2P 直接读写,把延迟压到几微秒;并把 all-reduce 与下一步的 RMSNorm 融合在一起。
- prefill 时通信由带宽主导:数据量大,通信占计算的三分之一以上。可以用计算与通信重叠来隐藏(把 token 切成两半交替计算和通信),或者减少 TP、改用其他并行方式。
- TP 必须用高带宽、低延迟的互连:跨机器(InfiniBand 每张卡 400 Gb/s,约 50 GB/s)时带宽比 NVLink 低近一个数量级,TP 几乎不可用。所以 TP 通常限制在一台机器内部,跨机器用流水线并行、数据并行或专家并行。
源码对照
- vLLM:并行线性层在
vllm/model_executor/layers/linear.py:ColumnParallelLinear、RowParallelLinear,以及合并版本MergedColumnParallelLinear(gate/up)和QKVParallelLinear(处理 KV 头复制:num_kv_head_replicas);词表切分在vocab_parallel_embedding.py(VocabParallelEmbedding、ParallelLMHead)。通信组在vllm/distributed/parallel_state.py(get_tp_group()),tensor_model_parallel_all_reduce会根据消息大小和硬件选择 custom all-reduce、对称内存(symm_mem.py)、FlashInfer 或 NCCL(device_communicators/cuda_communicator.py)。 - SGLang:
srt/layers/linear.py中同名的并行层,srt/distributed/中的通信组与 custom all-reduce,srt/layers/communicator.py负责各种并行模式下层间的通信编排(例如 all-reduce 与 RMSNorm 的融合、DP Attention 下的 gather/scatter)。
怎么讲清楚
手推 TP 的切法值得练熟。要点:MLP 先列后行,中间无通信,一次 all-reduce;注意力按头切,KV Cache 跟着头切,一次 all-reduce;每层两次 all-reduce,通信量 = token 数 × hidden。然后补充工程细节:头数整除约束、KV 头复制、decode 时小消息的延迟问题与 custom all-reduce、TP 限于机内。如果能写出 RowParallelLinear 的 forward(本地 GEMM + all-reduce),基本就过关了。
练习
1. 序列并行。 TP 中,RMSNorm 和残差相加在每张卡上都是对完整的 [token 数, hidden] 重复计算的。怎样消除这份冗余?
参考思路
把 all-reduce 拆成 reduce-scatter + all-gather:o_proj/down_proj 之后做 reduce-scatter,每张卡只拿到 1/tp 个 token 的完整结果,在这些 token 上做残差相加和 RMSNorm;进入下一个列切分层之前再 all-gather 回完整的 token。通信总量不变(reduce-scatter + all-gather = all-reduce),但 RMSNorm 等逐 token 操作的计算和激活显存都降为 1/tp。这就是 Megatron 的序列并行,推理中在 prefill 长序列时有用。
2. TP 和 DP 怎么选? 一个 8B 模型,8 张 H100。TP=8 部署一个实例,与 DP=8 部署 8 个独立实例,各有什么优缺点?
参考答案
- TP=8:单请求延迟低(每步只读 1/8 的权重),单个实例能容纳的上下文和 batch 更大;但每层两次 all-reduce,通信开销显著,总吞吐通常低于 DP。
- DP=8:没有通信,吞吐最高,实现简单,一张卡坏了只影响 1/8;但单请求延迟就是单卡的延迟,每个实例的 KV Cache 只有一张卡的显存。
8B 模型单卡放得下,追求吞吐时 DP 更划算;有严格的 TPOT 要求或超长上下文时,再考虑 TP=2 或 TP=4 这样的折中(例如 DP=4 × TP=2)。
训练侧的张量并行
训练时还要处理反向:列切分的输入梯度需要 all-reduce,行切分反过来;再加上序列并行,把 all-reduce 拆成 reduce-scatter + all-gather 以切开 LayerNorm 处的激活。分布式训练手册的张量并行与序列并行一章从零实现了带反向的版本,并与单进程的梯度逐项对齐。
小结
- 列切分无需通信,行切分需要 all-reduce;先列后行,一个 MLP 或一个注意力块只需一次 all-reduce。
- 注意力按头切分,KV Cache 随之切分;头数需被 TP 整除,TP 大于 KV 头数时要复制 KV 头。
- 每层两次 all-reduce,通信量正比于 token 数 × hidden;decode 受延迟主导,prefill 受带宽主导。
- TP 依赖 NVLink 这样的机内互连,跨机器通常改用其他并行方式。
本章练习题(2 道)
在浏览器里直接写代码、跑测试;也可以在本地用 python practice/judge.py 判题。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题