确定性推理:让结果与 batch 无关
温度设成 0,同一个请求发两次,结果却可能不一样——很多人以为这是"GPU 的随机性",其实主要原因是batch 在变:同一个请求和不同的请求拼在一个 batch 里时,kernel 会选不同的切分方式,浮点加法的顺序跟着变,结果就差了最后几位;两个候选 token 概率接近时,差一点就会走上不同的路径。这一章讲清楚它从哪里来、怎样做到"与 batch 无关"(batch invariance)、要付出什么代价,以及 vLLM 和 SGLang 的开关。它对强化学习尤其重要:推理端算出的概率要和训练端一致,才能做到真正的 on-policy。
自测:能答上来就可以跳过本章
- 温度为 0 时,同一个请求两次结果不同,最主要的原因是什么?
- 矩阵乘的 split-K、注意力的 split-KV 为什么会让结果依赖 batch?
- 怎样让一个 kernel 与 batch 无关?代价在哪里?
- 除了矩阵乘和注意力,还有哪些地方会影响确定性?
- vLLM 的
VLLM_BATCH_INVARIANT和 SGLang 的--enable-deterministic-inference各做了什么?
自测参考答案(先自己答,再展开对照)
- batch 在变:kernel 会根据 batch 里有多少请求选择不同的切分方式(split-K、split-KV),浮点加法的顺序随之改变,同一个请求的 logits 有微小差异,遇到接近平局的 token 时 argmax 就翻转了。
- 请求少时,kernel 为了用满所有 SM,把矩阵乘的 K 维或注意力的 KV 切成几段并行算、最后再合并;切几段取决于 batch 的大小,合并的顺序也就不同,结果随 batch 变化。
- 让每个请求的归约顺序只由它自己决定:不做 split-K 或固定切分的方式;注意力按固定的长度切 KV(而不是固定的段数);归一化和 softmax 一行由一个线程块按固定顺序归约。代价是小 batch 和长上下文 decode 的并行度下降、延迟变长。
- 分块 prefill 的切分位置和前缀缓存(KV 的来源不同时要逐位相同)、张量并行 all-reduce 的算法和 channel 数、MoE 的分组与排序、融合 kernel 和自动调优的配置、采样的随机数(要由请求自己的种子和位置决定)、CUDA Graph 按补齐后的大小选择 kernel。
- vLLM 的
VLLM_BATCH_INVARIANT=1:用 batch 无关的矩阵乘(SM80 上的 Triton 持久化矩阵乘,Hopper / Blackwell 上关掉 cuBLAS 的 split-K)、batch 无关的注意力后端和 softmax 等算子,NCCL 固定 tree 算法、单 channel。SGLang 的--enable-deterministic-inference:注意力后端按固定长度切分(FlashInfer 的 prefill 4096、decode 2048,FA3 不切),关掉 all-reduce 融合,用按种子的采样;--rl-on-policy-target自动开启它,并用log_softmax与训练端对齐。
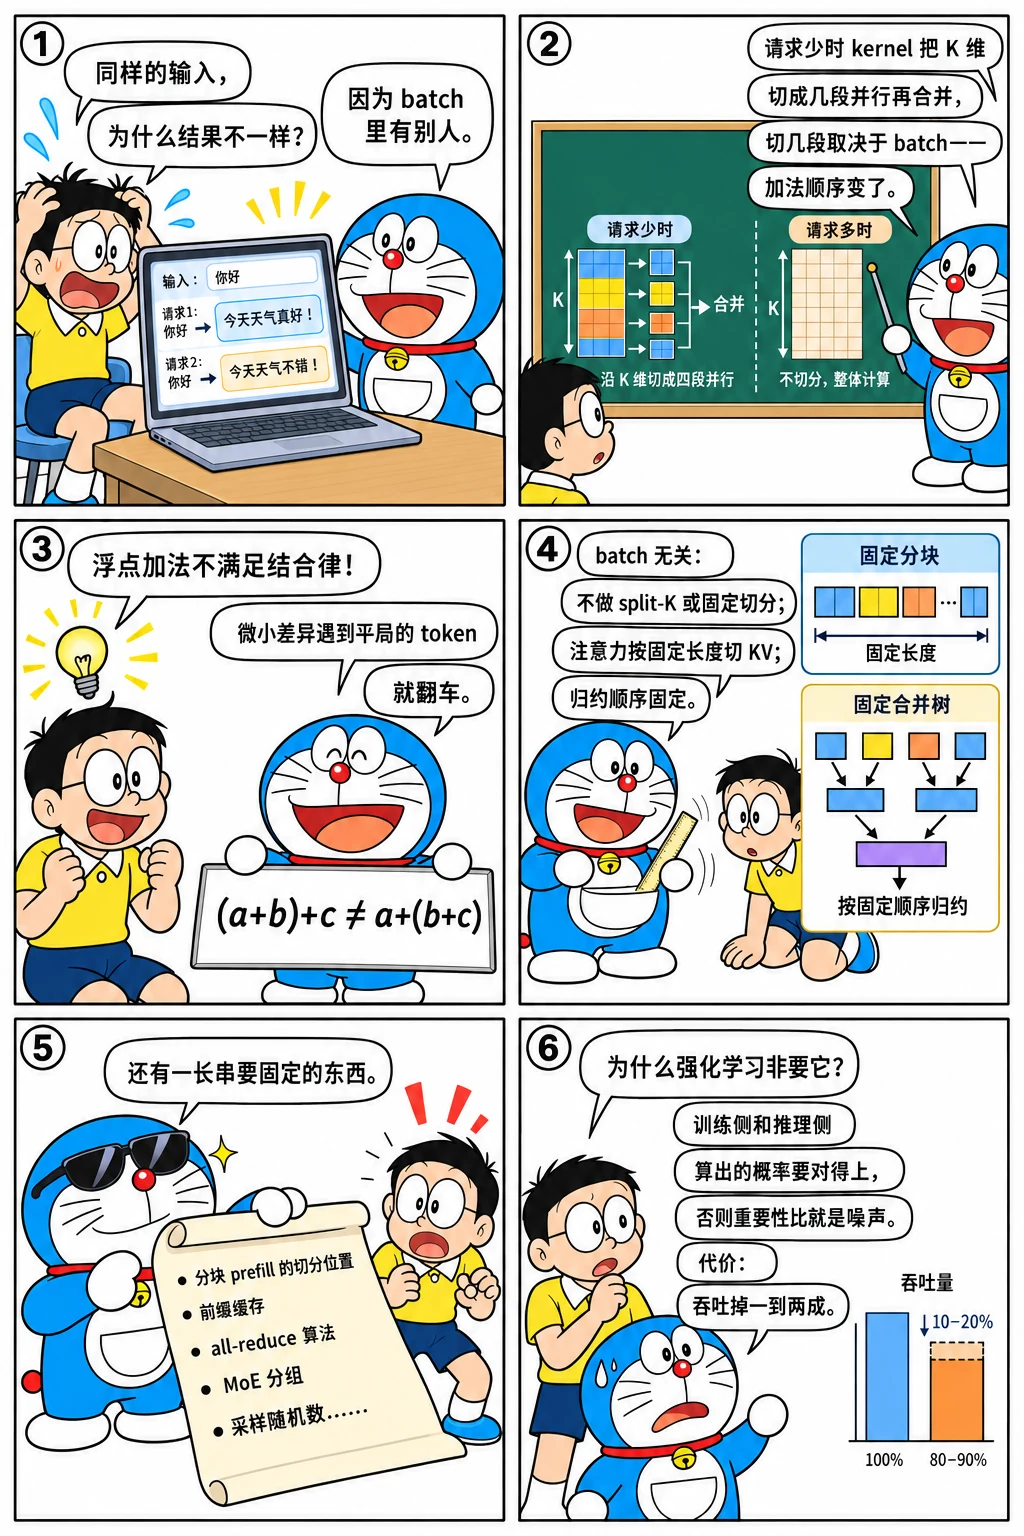
先看一个六格小剧场,再读正文:
根源:浮点加法的顺序
浮点加法不满足结合律,加的顺序不同,结果就可能不同。GPU kernel 为了用满所有 SM,会根据输入的大小选择切分方式:请求少时把矩阵乘的归约维度 K 切成几段并行算(split-K),把长上下文的 KV 切成几段并行做注意力(split-KV,也叫 flash-decoding),最后再合并。切几段取决于 batch 里有多少请求,于是同一个请求的数值取决于它和谁在一个 batch 里:
import torch

a, b, c = torch.tensor(1e8), torch.tensor(-1e8), torch.tensor(1.0)      # float32
print("浮点加法不满足结合律:(a + b) + c =", ((a + b) + c).item(), ";a + (b + c) =", (a + (b + c)).item())

torch.manual_seed(0)
K, N = 4096, 256
W = torch.randn(K, N)


def gemm(x, invariant):
    """模拟 GEMM kernel 的 split-K:请求少(M 小)时把 K 维切成几段并行算、最后再加起来,以便占满所有 SM;
    请求多时不切。切几段决定了加法的顺序——同一行的结果因此取决于 batch 里还有多少别的请求"""
    M = x.shape[0]
    splits = 1 if invariant or M >= 64 else 4
    bounds = torch.linspace(0, K, splits + 1).long().tolist()
    out = torch.empty(M, N)
    for i in range(M):                              # 每一行单独算,排除 BLAS 自己的分块带来的差异
        parts = [x[i, s:e] @ W[s:e] for s, e in zip(bounds, bounds[1:])]
        out[i] = torch.stack(parts).sum(0)
    return out


mine = torch.randn(1, K)
for invariant in (False, True):
    alone = gemm(mine, invariant)[0]
    same = []
    for M in (8, 63, 64, 200):
        batch = torch.cat([mine, torch.randn(M - 1, K)])
        same.append(f"batch {M}:{torch.equal(gemm(batch, invariant)[0], alone)}")
    print("固定切分(batch 无关)" if invariant else "按 batch 大小切分  ", "——和单独跑逐位相同?", ",".join(same))
浮点加法不满足结合律:(a + b) + c = 1.0 ;a + (b + c) = 0.0
按 batch 大小切分   ——和单独跑逐位相同? batch 8:True,batch 63:True,batch 64:False,batch 200:False
固定切分(batch 无关) ——和单独跑逐位相同? batch 8:True,batch 63:True,batch 64:True,batch 200:True
batch 从 63 变到 64 时,启发式换了一种切法,结果就变了——同一个请求的输出在线上会随着负载"随机"变化。注意力也一样:
import torch

torch.manual_seed(0)
D, S = 64, 8192                                     # 头维、上下文长度
q, K, V = torch.randn(D), torch.randn(S, D), torch.randn(S, D)


def decode_attention(q, K, V, splits):
    """flash-decoding:把 KV 切成若干段并行算,每段得到 (最大值, 分母, 加权和),最后按 LSE 合并"""
    parts = []
    for Kc, Vc in zip(K.tensor_split(splits), V.tensor_split(splits)):
        s = (Kc @ q) / D**0.5
        m = s.max()
        p = torch.exp(s - m)
        parts.append((m, p.sum(), p @ Vc))
    M = torch.stack([m for m, _, _ in parts]).max()
    num = sum(torch.exp(m - M) * o for m, _, o in parts)
    den = sum(torch.exp(m - M) * l for m, l, _ in parts)
    return num / den


def splits_by_load(batch, sms=132):
    """常见的启发式:请求越少,每个请求切得越多,好让所有 SM 都有活干"""
    return max(1, min(64, sms // batch))


def splits_fixed(seq_len, tile=2048):
    """与 batch 无关:按固定的长度切(SGLang 确定性模式下 FlashInfer decode 用 2048)"""
    return -(-seq_len // tile)


ref = decode_attention(q, K, V, splits_by_load(1))
print("按负载切分:", ",".join(f"batch {b} 切 {splits_by_load(b)} 段、与 batch 1 逐位相同 {torch.equal(decode_attention(q, K, V, splits_by_load(b)), ref)}"
                          for b in (1, 16, 64, 256)))
fixed = [decode_attention(q, K, V, splits_fixed(S)) for _ in (1, 16, 64, 256)]
print(f"固定按 2048 切:每个 batch 都切 {splits_fixed(S)} 段,结果全部相同 {all(torch.equal(f, fixed[0]) for f in fixed)};"
      f"和不切分的结果只差浮点误差 {torch.allclose(fixed[0], torch.softmax(K @ q / D**0.5, 0) @ V, atol=1e-5)}")
按负载切分: batch 1 切 64 段、与 batch 1 逐位相同 True,batch 16 切 8 段、与 batch 1 逐位相同 False,batch 64 切 2 段、与 batch 1 逐位相同 False,batch 256 切 1 段、与 batch 1 逐位相同 False
固定按 2048 切:每个 batch 都切 4 段,结果全部相同 True;和不切分的结果只差浮点误差 True
真实的库也是这样:大模型手册的一个 token 的旅程一章在 CPU 上测过,同一个请求单独算和放进 batch 里算,logits 差 \(3 \times 10^{-5}\)、逐位不同(CPU 的矩阵乘库同样按矩阵大小选择分块方式)。
与 batch 无关:固定切分,不随负载变
办法说起来简单:每个请求的归约顺序只由它自己决定,不看 batch 里还有谁。具体到各类算子:
- 矩阵乘:不用 split-K,或者 split 的方式固定;每个输出元素的 K 维累加顺序与 M(batch 里的 token 数)无关。vLLM 在 Ampere(SM80)上用一个 Triton 写的持久化矩阵乘替换 PyTorch 的
mm、addmm、matmul、linear;在 Hopper 和 Blackwell 上,cuBLAS 里唯一依赖 batch 的是 split-K,于是把 cuBLAS 的 workspace 设成最小,让它没法做 split-K; - 注意力:split-KV 按固定的长度切(与请求数无关)。SGLang 的确定性模式让 FlashInfer 的 prefill 按 4096、decode 按 2048 个 token 切,FlashAttention 3 干脆不切(
num_splits=1); - 归一化、softmax、求均值:每一行由一个线程块按固定顺序归约,不因为行少就把一行拆给多个块。vLLM 为
softmax、log_softmax、mean注册了对应的 batch 无关实现; - 分块 prefill 与前缀缓存:一个请求的 KV 无论是一次 prefill 算出来的、分几块算出来的、还是从前缀缓存里拿来的,都要逐位相同,所以注意力 kernel 对"query 分块"也要不变;SGLang 为 MLA 模型限定了几种支持前缀缓存的确定性注意力后端;
- 通信:all-reduce 的归约顺序也要固定。vLLM 的 batch 不变模式把 NCCL 固定成 tree 算法、单个 channel、Simple 协议,关掉 NVLS 和对称内存的 all-reduce;SGLang 关掉 all-reduce 与 RMSNorm 的融合;
- 采样:同一个种子、同一个分布要采出同一个 token。SGLang 强制用 PyTorch 的采样实现,随机数由请求的种子和 token 的位置算出来(
multinomial_with_seed),和 batch 里的其他请求无关。
这样得到的是同一套部署内的确定性:同样的模型、同样的并行配置、同样的硬件和软件版本下,一个请求的结果与 batch 组成、到达时间、是否命中前缀缓存都无关。跨硬件、跨 TP 大小的逐位一致是另一个更难的问题,一般不追求。
代价
- 少了并行度:split-K、split-KV 本来就是为"请求少、并行度不够"准备的。固定切分后,小 batch 的矩阵乘和长上下文的 decode 注意力用不满 SM,延迟变长;batch 大时影响小;
- 通信变慢:单 channel、固定算法的 NCCL 用不满带宽,张量并行的 all-reduce 会明显变慢;
- 优化受限:有些融合 kernel、持久化 kernel、自动调优的配置会因为"结果依赖 batch"被关掉。
所以它通常只在需要的地方打开:强化学习的 rollout、需要复现的评测和调试、回归测试。
为什么强化学习需要它
RL 训练中的推理一章讲过,推理端和训练端对同一个序列算出的概率在 BF16 下会差出不少,GRPO 这类算法用推理端采样、用训练端的概率算梯度,两者不一致就变成了 off-policy,需要重要性采样来修正(TIS / MIS)。确定性推理是另一条路:让推理端的计算与 batch 无关、并且和训练端用同样的算子,两边的概率就逐位相同,训练变成真正的 on-policy。SGLang 的 --rl-on-policy-target 就是为此准备的:打开它会自动开启确定性推理,并且用 log_softmax 计算 logprob,和训练端的算法保持一致。
框架里的开关
| vLLM | SGLang | |
|---|---|---|
| 开关 | 环境变量 VLLM_BATCH_INVARIANT=1 |
--enable-deterministic-inference;RL 场景用 --rl-on-policy-target |
| 矩阵乘 | SM80 上用 Triton 持久化矩阵乘替换 mm / addmm / matmul / linear;SM90、SM100 上关掉 cuBLAS 的 split-K;关闭 TF32 和低精度归约 |
各后端选确定性的配置(例如 MoE 的 kernel 配置、关闭融合的 finalize) |
| 注意力 | 注意力后端走 batch 无关的实现 | FlashInfer 按固定长度切分(prefill 4096、decode 2048),FA3 不切分;MLA 模型只允许支持前缀缓存的确定性后端 |
| 通信 | NCCL 固定为 tree 算法、单 channel、Simple 协议,关闭 NVLS 与对称内存 all-reduce | 关闭 all-reduce 融合 |
| 实现位置 | vllm/model_executor/determinism/batch_invariant.py |
srt/batch_invariant_ops/,各处的 enable_deterministic_inference 分支 |
怎么讲清楚
先纠正一个常见的误解:温度为 0 时结果不稳定,主要不是"GPU 并行的随机性",而是batch 不变性的问题——kernel 按请求数选择 split-K、split-KV 等切分方式,浮点加法顺序随之改变,同一个请求的数值取决于它和谁在一个 batch 里。解决办法是让每个请求的归约顺序只由它自己决定:矩阵乘不做 split-K 或固定切分,注意力按固定长度切 KV,归一化和 softmax 一行由一个块归约,分块 prefill 与前缀缓存的结果要一致,NCCL 固定算法和 channel,采样固定随机数。代价是小 batch 和长上下文 decode 的并行度下降、通信变慢。应用场景是 RL 的 on-policy rollout(SGLang 的 --rl-on-policy-target)、可复现的评测和回归测试。
练习
1. 打开 batch 不变模式后,哪类请求变慢得最多?
参考答案
小 batch、长上下文的 decode。decode 时每个请求只有一个 query,矩阵乘的 M 很小,本来要靠 split-K 用满 SM;长上下文的注意力本来要靠 split-KV 把一个请求的 KV 分给很多 SM 并行扫。固定切分之后,这两处的并行度都下降了。batch 大、上下文短时,本来就不怎么切分,影响很小。
2. 只把矩阵乘和注意力换成 batch 无关的实现,还有哪些地方会让同一个请求的结果不同?
参考答案
归一化和 softmax 的归约方式(行少时拆给多个块);分块 prefill 的切分位置和前缀缓存(KV 的来源不同);张量并行 all-reduce 的算法和 channel 数(NCCL 会按消息大小和拓扑选择);MoE 的专家分组和 token 排序方式、融合 kernel 的配置随 batch 自动调优;采样的随机数(要由请求自己的种子和位置决定,而不是从一个全局的随机数流里依次取);CUDA Graph 按补齐后的大小选 kernel。vLLM 和 SGLang 的确定性模式正是逐项处理这些地方。
3. 为什么确定性推理能让 RL 训练更稳定?它能完全取代重要性采样修正吗?
参考答案
GRPO 等算法的梯度假设样本来自当前策略;推理端和训练端的概率不一致时,样本实际上来自一个略有不同的分布,梯度有偏,严重时会让训练不稳定。确定性推理加上"训练端和推理端用同样的算子",可以让两边的概率逐位相同,消除这一部分偏差。但它不能取代所有修正:异步 RL 里样本来自旧版本的权重(策略滞后),部分 rollout 跨越了权重更新,这些是另一种 off-policy,仍然需要重要性采样或限制滞后步数。
小结
- 温度为 0 结果仍不稳定,主要原因是 batch 在变:kernel 按请求数选择切分方式,浮点加法的顺序随之改变。
- 与 batch 无关的做法:矩阵乘不做 split-K 或固定切分、注意力按固定长度切 KV、归一化按固定顺序归约,并让分块 prefill、前缀缓存、通信和采样都保持一致。
- 代价是小 batch 与长上下文 decode 的并行度下降、通信变慢,所以只在 RL rollout、可复现评测和回归测试时打开。
- vLLM 用
VLLM_BATCH_INVARIANT=1,SGLang 用--enable-deterministic-inference,RL 场景用--rl-on-policy-target自动开启并用log_softmax与训练端对齐。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题