KV Cache 与两阶段推理
KV Cache 是大模型推理中最重要的一个概念:它把生成的计算量从平方级降到线性级,同时带来了推理系统里几乎所有的显存管理问题。理解了它,也就理解了推理为什么分成 prefill 和 decode 两个性质完全不同的阶段,以及批处理为什么能大幅提升吞吐。
自测:能答上来就可以跳过本章
- 为什么历史 token 的 K、V 可以缓存复用?Q 为什么不需要缓存?
- 不用 KV Cache 生成 n 个 token,总共要处理多少个 token?用了之后呢?
- prefill 和 decode 的算术强度分别是多少?各自是什么瓶颈?
- 为什么把 8 个请求放在一起 decode,耗时远小于单独 decode 8 次?
- PagedAttention 解决的是 KV Cache 的什么问题?
自测参考答案(先自己答,再展开对照)
- 因果注意力里,历史 token 的 K、V 只依赖它自己和更早的 token,后面加入新 token 不会改变它们;Q 只在计算当前 token 的输出时用一次,之后不再需要。
- 不用缓存时,生成第 t 个 token 要重新处理 t 个 token,n 个 token 共约 \(n^2/2\) 个;用了缓存每步只处理 1 个新 token,共约 n 个(加上一次提示词的 prefill)。
- prefill 一次处理成百上千个 token,算术强度约等于 token 数,是计算瓶颈;decode 每个请求每步 1 个 token,强度约等于 batch 大小,远低于屋脊点,是访存瓶颈。
- decode 的时间主要花在读权重上,8 个请求一起 decode 时权重只读一遍、同时算 8 个 token,耗时增加很少(本章实测只多 60%),吞吐约为原来的 5 倍。
- KV Cache 的显存碎片和浪费:按最大长度连续预留会有大量内部和外部碎片;分页后按块按需分配,还能在请求之间按块共享前缀。
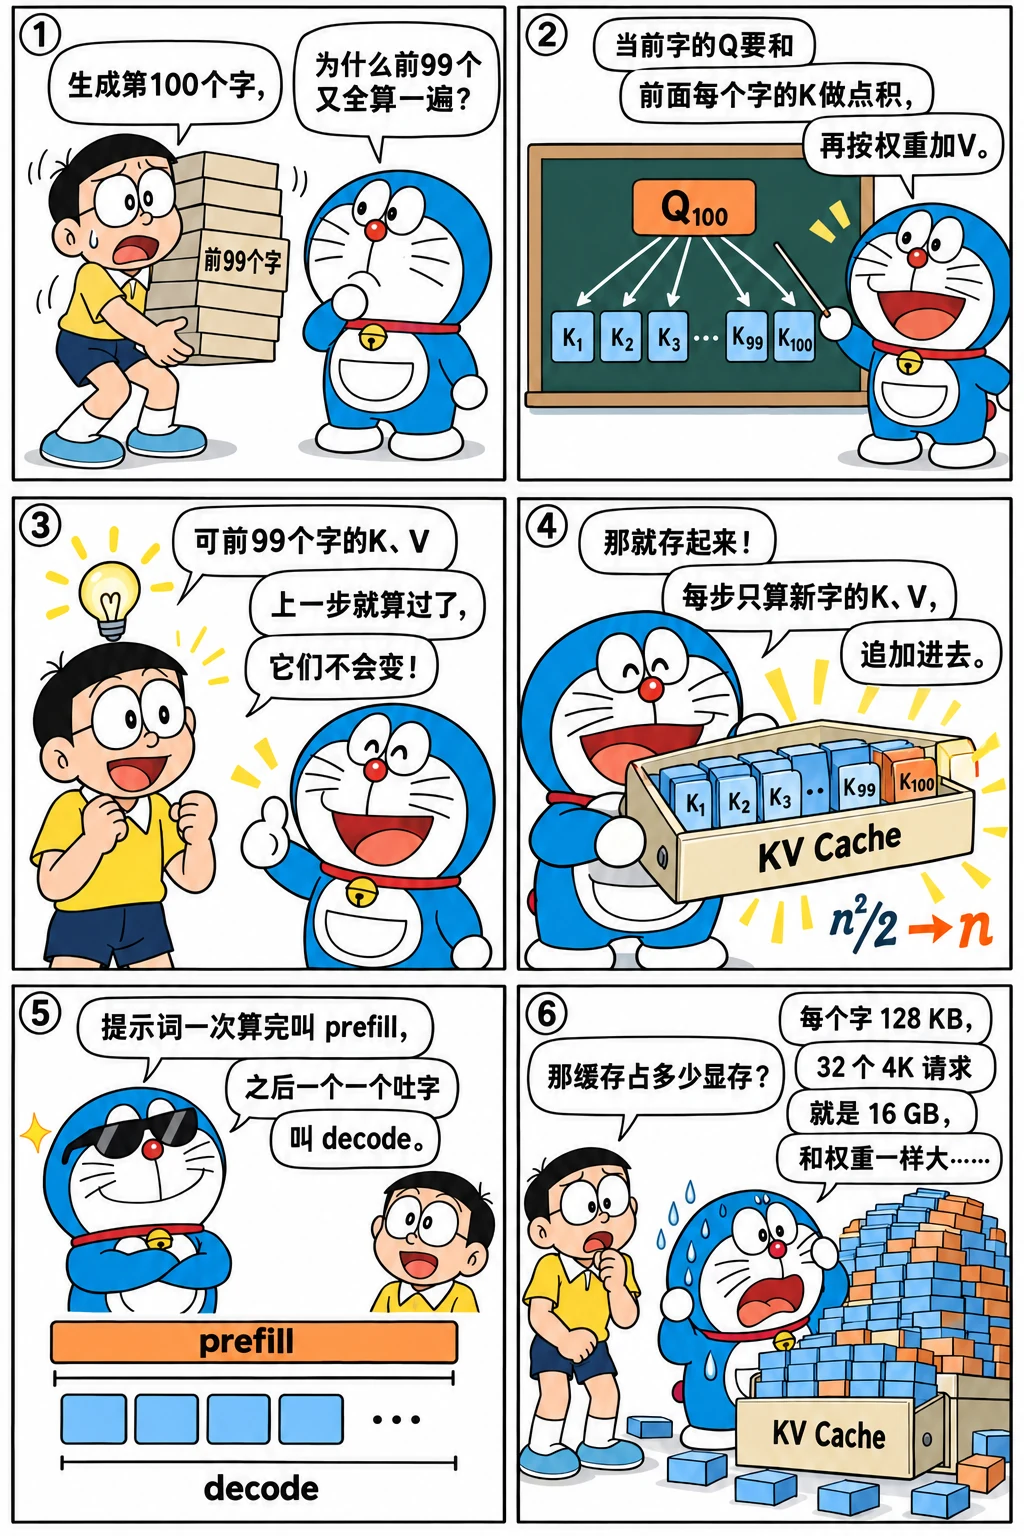
先看一个六格小剧场,再读正文:
为什么 K、V 可以缓存
生成第 t+1 个 token 时,模型要对前 t 个 token 做完整的前向计算吗?看因果注意力的结构:位置 i 的输出只依赖位置 ≤ i 的输入。所以追加一个新 token 时,所有历史位置在每一层的隐藏状态都不会改变,它们的 K、V 自然也不变。新 token 只需要:
- 计算自己的 Q、K、V;
- 把自己的 K、V 追加到缓存里;
- 用自己的 Q 和缓存中全部的 K、V 做注意力。
历史 token 的 Q 以后再也用不到(只有最新 token 的 query 参与计算),所以只缓存 K 和 V。这就是 KV Cache。
不用缓存时,生成第 t 个 token 要重新处理 t 个 token,生成 n 个 token 共处理约 \(n^2/2\) 个;用了缓存,每步只处理 1 个新 token。
验证:带缓存的逐步计算等于完整重算
这是检验推理实现正确性最常用的方法:
import time
import torch
from transformers import AutoTokenizer
from mini_llm import KVCache, Transformer

path = "models/Qwen3-0.6B"
tok = AutoTokenizer.from_pretrained(path)
model = Transformer.from_pretrained(path)
ids = tok("KV Cache 是大模型推理中最重要的概念之一,因为", return_tensors="pt").input_ids

with torch.no_grad():
    full = model(ids)                                   # 一次性处理整个序列
    cache = KVCache(model.cfg.num_hidden_layers)
    step_logits = [model(ids[:, :5], cache)]            # 先 prefill 前 5 个 token
    for t in range(5, ids.shape[1]):                    # 再逐个 decode 剩下的 token
        step_logits.append(model(ids[:, t:t + 1], cache))
    incremental = torch.cat(step_logits, dim=1)

diff = (full - incremental).abs().max().item()
print(f"逐步计算 vs 完整重算,logits 最大差异 {diff:.1e};缓存长度 {cache.length},K 的形状 {tuple(cache.k[0].shape)}")
assert diff < 1e-3 and cache.length == ids.shape[1]
缓存中每一层的 K 形状为 [B, n_kv, S, d_h] = [1, 8, S, 128]。
prefill 与 decode
有了 KV Cache,一次生成请求分成两个阶段:
| prefill | decode | |
|---|---|---|
| 输入 | 整个提示词(T 个 token) | 每步 1 个新 token |
| 做什么 | 计算所有提示词 token 的 K、V 写入缓存,输出第一个新 token | 读取缓存,生成下一个 token,追加它的 K、V |
| 每读一次权重参与计算的 token 数 | T | batch 中的请求数 |
| 瓶颈 | 计算(T 较大时) | 显存带宽(读权重、读 KV Cache) |
| 对应的延迟指标 | TTFT(首 token 延迟) | TPOT / ITL(每个输出 token 的延迟) |
算术强度的差异是理解一切的关键。一个 BF16 线性层,每个参数 2 字节,每个 token 用它做 2 次运算:
- decode(batch = 1):每读 2 字节做 2 次运算,算术强度约 1 FLOP/Byte;
- prefill(T 个 token):每读 2 字节做 2T 次运算,算术强度约 T FLOP/Byte。
H100 的脊点约为 989 TFLOPS / 3.35 TB/s ≈ 295 FLOP/Byte。所以 prefill 几百个 token 就能把 GPU 算满,而 decode 离算满差了两个数量级:GPU 的大部分算力在 decode 时是闲置的,时间都花在从显存读权重和 KV Cache 上。
在 CPU 上也能观察到同样的规律(CPU 同样有"内存带宽 vs 算力"的平衡问题):
torch.set_num_threads(16)
prompt = tok("介绍一下大模型推理中的 prefill 和 decode 两个阶段。" * 8, return_tensors="pt").input_ids

@torch.no_grad()
def timed_generate(input_ids, n_new=20):
    cache = KVCache(model.cfg.num_hidden_layers)
    t0 = time.perf_counter()
    logits = model(input_ids, cache)
    t_prefill = time.perf_counter() - t0
    nxt = logits[:, -1].argmax(-1)
    t0 = time.perf_counter()
    for _ in range(n_new):
        nxt = model(nxt[:, None], cache)[:, -1].argmax(-1)
    return t_prefill, (time.perf_counter() - t0) / n_new

timed_generate(prompt[:, :8], n_new=2)                   # 预热
t_pre, t_dec = timed_generate(prompt)
T = prompt.shape[1]
print(f"prefill {T} 个 token: {t_pre * 1000:.0f} ms(每个 token {t_pre / T * 1000:.1f} ms)")
print(f"decode: 每个 token {t_dec * 1000:.1f} ms")
在本手册的环境里运行得到(数值因机器而异,重要的是比例):
prefill 平均到每个 token 只要 1.7 ms,decode 生成一个 token 却要 45.5 ms,相差约 26 倍:同样读一遍权重,prefill 让一百多个 token 分摊了这次读取,decode 只有一个。
批处理:让多个请求分摊权重读取
既然 decode 的瓶颈在于"读一次权重只算一个 token",那就让多个请求一起 decode:权重读一次,同时为 B 个请求各算一个 token。只要还没到计算瓶颈,耗时几乎不随 B 增长,吞吐量却提高了 B 倍:
@torch.no_grad()
def decode_step_time(batch, ctx_len=64, steps=10):
    ids = torch.randint(0, 150000, (batch, ctx_len))
    cache = KVCache(model.cfg.num_hidden_layers)
    model(ids, cache)
    nxt = torch.randint(0, 150000, (batch,))
    t0 = time.perf_counter()
    for _ in range(steps):
        nxt = model(nxt[:, None], cache)[:, -1].argmax(-1)
    return (time.perf_counter() - t0) / steps

decode_step_time(2, steps=2)                              # 预热
t1, t8 = decode_step_time(1), decode_step_time(8)
print(f"batch=1: 每步 {t1 * 1000:.1f} ms;batch=8: 每步 {t8 * 1000:.1f} ms({t8 / t1:.1f} 倍的时间,8 倍的 token)")
在本手册的环境里:
8 个请求一起 decode,每一步只多花了 60% 的时间,吞吐却提高到约 5 倍。这就是推理服务追求大 batch 的根本原因。但 batch 不能无限增大:每个请求都有自己的 KV Cache,显存会先耗尽;batch 越大,每个请求的 decode 延迟也会上升。推理服务的调度,本质上是在吞吐和延迟之间找平衡,见推理服务。
推理视角
decode 时,除了权重,KV Cache 也要每步完整地读一遍。权重是所有请求共享的,批处理可以分摊;KV Cache 却是每个请求私有的,无法分摊。上下文越长、batch 越大,读 KV Cache 的时间占比越高,最终可能超过读权重的时间。这就是长上下文推理慢的原因,也是 GQA、MLA、KV Cache 量化如此重要的原因(见注意力变体)。
把这笔账放到具体的模型和卡上算一算:选一个模型、一张卡和平均上下文长度,看 KV 能放下多少个请求,满载时 decode 一步至少要多久。
几个值得试的组合:LLaMA-3-8B 和 Qwen2.5-7B 参数量差不多,但 KV 头数差一倍、层数也多 4 层,每个 token 的 KV 差了一倍多,能服务的请求数也差这么多;把 KV 换成 FP8,请求数翻倍;DeepSeek-V3 的 FP8 权重在 8 张 H100 上放不下、8 张 H200 可以,而且 MLA 的缓存每张卡都要存一份。
KV Cache 的显存管理
每个 token 的 KV Cache 大小是固定的(Qwen3-0.6B 为 2 × 28 × 8 × 128 × 2 字节 = 112 KB,BF16),但一个请求最终会生成多少 token 是事先不知道的。朴素的做法是按最大长度为每个请求预留一块连续的显存,问题很大:
- 内部碎片:预留了 32K,实际只用了 500,其余全浪费;
- 外部碎片:请求来来去去,显存被切成大小不一的空洞;
- 无法共享:多个请求有相同的前缀(系统提示),却要各存一份。
vLLM 提出的 PagedAttention 借鉴了操作系统的虚拟内存:把 KV Cache 切成固定大小的块(比如每块 16 个 token),每个请求用一张块表记录它的逻辑块存放在哪些物理块中,按需分配、用完回收;相同的前缀可以映射到相同的物理块(写时复制)。显存浪费从 60%-80% 降到不足 4%(数据来自 vLLM 论文),同样的显存能容纳多得多的并发请求。代价是注意力 kernel 需要通过块表间接寻址,参见 CUDA 手册中的分页 decode attention。
在此基础上,还有这些常见的 KV Cache 管理手段:
| 手段 | 做什么 |
|---|---|
| 前缀缓存(prefix caching) | 请求结束后不立即释放 KV,按内容哈希(vLLM)或基数树(SGLang 的 RadixAttention)索引,新请求命中相同前缀就直接复用 |
| 抢占(preemption) | 显存不够时暂停一些请求,丢弃它们的 KV(之后重新计算)或换出到 CPU 内存 |
| KV 卸载 | 把不常用的 KV 放到 CPU 内存或 SSD(LMCache、Mooncake 等),需要时再拉回来 |
| KV 量化 | FP8 或更低精度存储 KV,容量翻倍、读取量减半 |
怎么讲清楚
按"为什么能缓存 → 省了什么 → 带来什么问题"讲:因果注意力下历史 token 的 K、V 不会变,Q 只用当前的;缓存把生成 n 个 token 的计算从平方级降到线性级。代价是显存:每 token 的 KV = 2 × 层数 × KV 头数 × 头维 × 字节数(Qwen3-0.6B 为 112 KB),它决定并发和上下文上限。prefill 计算密集(决定 TTFT),decode 访存密集(决定 TPOT);批处理能分摊权重的读取(本章 8 个请求一起 decode 只多花 60% 的时间),却分摊不了各自的 KV。最后提 PagedAttention、前缀缓存、KV 量化。
练习
1. 计算题。 生成 1000 个 token(提示词 100 个 token),不用 KV Cache 和使用 KV Cache,分别需要处理多少个 token 的前向计算?
参考答案
不用缓存:第 i 步处理 100 + i − 1 个 token,总共 \(\sum_{i=1}^{1000}(99 + i) = 99 \times 1000 + 500500 = 599500\) 个。使用缓存:prefill 100 个,之后 999 步各 1 个(最后一个 token 生成后不需要再计算),共 1099 个,约为前者的 1/545。
2. 估算题。 在 H100(3.35 TB/s)上用 BF16 部署 LLaMA-3-8B(权重约 16 GB,KV Cache 128 KB/token)。batch = 32、每个请求的上下文长度都是 4096 时,decode 每一步至少要读多少数据?延迟下限是多少?此时读 KV 占多大比例?
参考答案
KV Cache:32 × 4096 × 128 KB = 16 GB,和权重一样大。每步至少读 32 GB,延迟下限约 32 GB / 3.35 TB/s ≈ 10 ms,读 KV 占一半。如果上下文增加到 16K,KV 就是权重的 4 倍。这说明长上下文、大 batch 的场景下,KV Cache 的读取才是 decode 的主要开销。
小结
- 因果注意力保证历史 token 的 K、V 不变,所以可以缓存;Q 不需要缓存。
- KV Cache 把生成的计算量从平方级降到线性级;用"逐步计算 = 完整重算"验证实现。
- prefill 计算密集(TTFT),decode 访存密集(TPOT);decode 时 GPU 算力大量闲置。
- 批处理让多个请求分摊权重读取,是提高吞吐的根本手段;KV Cache 无法分摊。
- PagedAttention 用块表管理 KV Cache,消除碎片并支持前缀共享;另有前缀缓存、抢占、卸载、量化等手段。
本章练习题(2 道)
在浏览器里直接写代码、跑测试;也可以在本地用 python practice/judge.py 判题。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题