投机解码进阶:树形草稿与 EAGLE
大模型手册的投机解码一节讲了基本原理:草稿猜几个 token,目标模型一次前向验证,贪心时输出不变,采样时分布不变。这一章讲推理引擎里真正在用的进阶做法:把草稿组织成一棵树、用树注意力一次验证多条候选路径;EAGLE 与 MTP 这类"长在目标模型身上"的草稿;以及投机解码在什么负载下有效、在引擎中如何实现。
自测:能答上来就可以跳过本章
- 为什么要用树形草稿?树注意力的掩码长什么样?树中节点的位置编码怎么取?
- 验证之后,被接受的 token 的 KV 要重新计算吗?
- EAGLE 的草稿模型输入的是什么?MTP 又是什么?
- 投机解码在 batch 很大时为什么会变慢?
自测参考答案(先自己答,再展开对照)
- 链式草稿只有一条候选,前面一个 token 错了后面全部作废;树形草稿在草稿模型不确定的地方分叉,同时准备多条候选,一次验证整棵树,平均接受的 token 更多。树注意力的掩码让每个节点只看到前缀、自己的祖先和自己;位置取"前缀长度 + 深度"。
- 不需要:验证时已经为树上的每个节点算好了 KV,被接受路径上的直接复用(把它们整理到连续的位置),被拒绝的直接作废。
- EAGLE 的草稿网络读取目标模型的隐藏状态(特征)和下一个 token 的嵌入,预测下一步的特征,再经过目标模型的输出层得到 token;MTP 是模型训练时就带的多 token 预测层,推理时可以直接当作草稿。
- batch 大时 GPU 的算力已经被占满,验证多个草稿 token 的计算不再是"免费"的;每一步变慢的代价超过了多接受的 token 带来的收益,加速比消失甚至变成负的。
先看一个六格小剧场,再读正文:
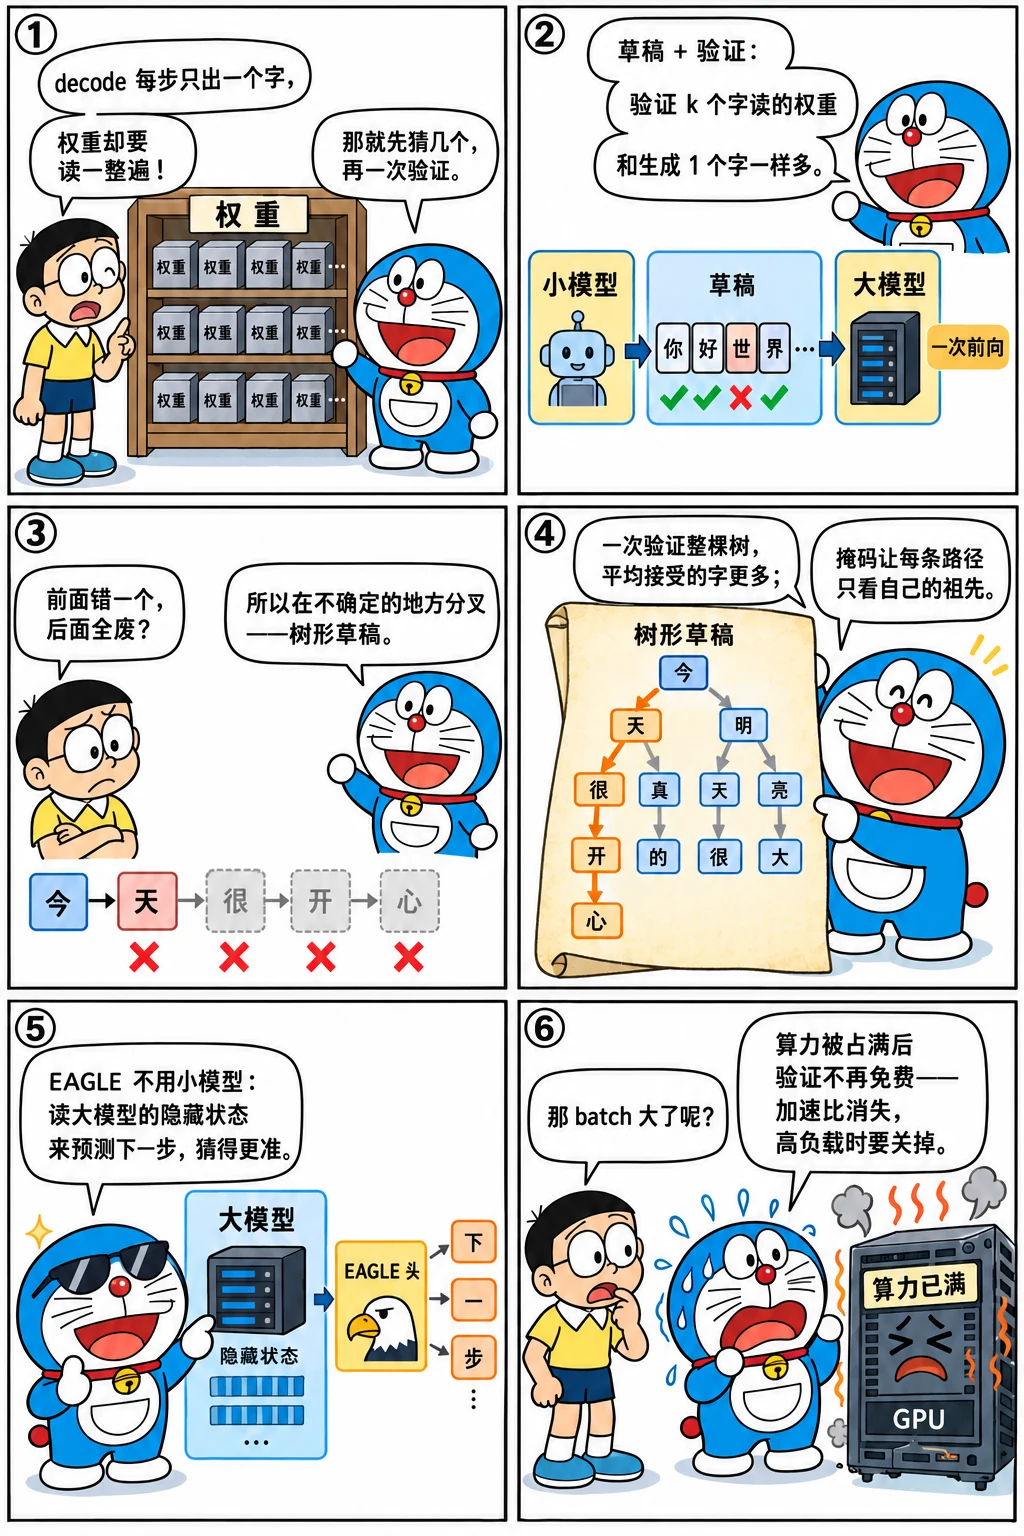
为什么要用树
草稿的每一步只猜一个 token(链式草稿),第一个猜错就前功尽弃。但草稿模型往往"知道自己不确定":第一个位置它觉得 A 和 B 都有可能。如果同时准备 A 和 B 两条后续,目标模型只要认可其中一条,就能接受更长的序列。把这些候选组织成一棵树:
            根(目标模型上一步给出的 token)
           /                    \
       候选 A1                 候选 B1          ← 第 1 层:草稿的 top-2
       /     \                /     \
     A2      A2'            B2      B2'         ← 第 2 层:每个节点再取 top-2
     |        |              |       |
     A3      A3'            B3      B3'         ← 第 3 层:top-1
拖动宽度、深度和草稿命中率,看期望能吐出多少 token、加速比什么时候翻负:
关键在于:整棵树可以在一次前向中验证。把所有节点排成一个序列送进目标模型,用一个特殊的注意力掩码让每个节点只看到"已提交的前缀 + 自己的祖先 + 自己",就好像每条路径都在单独计算;每个节点的 RoPE 位置取"前缀长度 + 深度",同一层的兄弟节点位置相同。验证之后,从根出发,沿着"目标模型的预测恰好是某个子节点"的方向往下走,得到被接受的最长路径。
实现
"""tree_spec.py —— 树形投机解码:草稿组织成一棵 token 树,用"树注意力掩码"一次前向验证整棵树。

树中每个节点只能看到:已提交的前缀、自己的所有祖先、自己。节点的位置 = 前缀长度 + 深度。
验证后沿树走出与目标模型贪心结果一致的最长路径,并直接复用这条路径上的 KV,不需要重算。
"""

import math

import torch
import torch.nn.functional as F

from mini_llm import KVCache, apply_rope, rope_cos_sin


@torch.no_grad()
def forward_with_mask(model, ids, positions, cache: KVCache, mask):
    """ids: [T] 新 token;mask: [T, T] 新 token 之间的可见性(True 表示可见);它们都能看到缓存中的全部前缀。
    返回 logits [T, V] 和各层新 token 的 (K, V),不修改 cache。"""
    cfg = model.cfg
    T, P = len(ids), cache.length
    full_mask = torch.cat([torch.ones(T, P, dtype=torch.bool), mask], dim=1)
    cos, sin = rope_cos_sin(positions, cfg.hd, cfg.rope_theta)
    x = model.embed_tokens(ids[None])
    new_kv = []
    for i, layer in enumerate(model.layers):
        attn, h = layer.self_attn, layer.input_layernorm(x)
        q = apply_rope(attn.q_norm(attn.q_proj(h).view(1, T, attn.nh, attn.hd).transpose(1, 2)), cos, sin)
        k = apply_rope(attn.k_norm(attn.k_proj(h).view(1, T, attn.nkv, attn.hd).transpose(1, 2)), cos, sin)
        v = attn.v_proj(h).view(1, T, attn.nkv, attn.hd).transpose(1, 2)
        new_kv.append((k, v))
        K = torch.cat([cache.k[i], k], dim=2) if P else k
        V = torch.cat([cache.v[i], v], dim=2) if P else v
        rep = attn.nh // attn.nkv
        out = F.scaled_dot_product_attention(q, K.repeat_interleave(rep, 1), V.repeat_interleave(rep, 1),
                                             attn_mask=full_mask)
        x = x + attn.o_proj(out.transpose(1, 2).reshape(1, T, attn.nh * attn.hd))
        x = x + layer.mlp(layer.post_attention_layernorm(x))
    return model.lm_head(model.norm(x))[0], new_kv


def tree_mask(parents: list[int]) -> torch.Tensor:
    """parents[i] 是节点 i 的父节点下标(根为 -1)。节点 i 能看到自己和所有祖先。"""
    n = len(parents)
    mask = torch.zeros(n, n, dtype=torch.bool)
    for i in range(n):
        j = i
        while j != -1:
            mask[i, j] = True
            j = parents[j]
    return mask


def depths(parents):
    d = []
    for p in parents:
        d.append(0 if p == -1 else d[p] + 1)
    return d


@torch.no_grad()
def build_draft_tree(draft_model, context: list[int], root: int, branching: list[int]):
    """用草稿模型从 root 往下展开:第 l 层每个节点取草稿模型的 top-branching[l] 个 token。
    返回 (tokens, parents),第 0 个节点是 root 本身。"""
    tokens, parents, frontier = [root], [-1], [0]
    for width in branching:
        next_frontier = []
        for node in frontier:
            path, j = [], node
            while j != -1:
                path.append(tokens[j])
                j = parents[j]
            logits = draft_model(torch.tensor([context + path[::-1]]))[0, -1]
            for t in logits.topk(width).indices.tolist():
                tokens.append(t)
                parents.append(node)
                next_frontier.append(len(tokens) - 1)
        frontier = next_frontier
    return tokens, parents


@torch.no_grad()
def tree_speculative_generate(target, draft, prompt: list[int], max_new: int, branching: list[int], eos=None):
    cache = KVCache(target.cfg.num_hidden_layers)
    root = target(torch.tensor([prompt]), cache)[0, -1].argmax().item()   # prefill,得到第一个 token
    committed, out, target_calls, accepted_per_call = list(prompt), [], 1, []
    while len(out) < max_new:
        tokens, parents = build_draft_tree(draft, committed, root, branching)
        pos = torch.tensor([len(committed) + d for d in depths(parents)])
        logits, new_kv = forward_with_mask(target, torch.tensor(tokens), pos, cache, tree_mask(parents))
        target_calls += 1
        path, node = [0], 0                                  # 从根出发,走目标模型认可的最长路径
        while True:
            pred = logits[node].argmax().item()
            child = next((c for c, p in enumerate(parents) if p == node and tokens[c] == pred), None)
            if child is None:
                break
            path.append(child)
            node = child
        accepted_per_call.append(len(path))
        for layer, (k, v) in enumerate(new_kv):              # 只把路径上节点的 KV 追加进缓存
            cache.update(layer, k[:, :, path], v[:, :, path])
        for n in path:
            committed.append(tokens[n])
            out.append(tokens[n])
            if tokens[n] == eos or len(out) >= max_new:
                return out[:max_new], target_calls, accepted_per_call
        root = logits[node].argmax().item()                  # 目标模型在路径终点给出的下一个 token
    return out, target_calls, accepted_per_call
注意最后一步:路径上节点的 K/V 在验证时已经按正确的位置和上下文算好了,直接挑出来追加到缓存即可,不需要重算。真实引擎中,这一步是把被接受节点的 KV 槽位"压实"到序列的正确位置(或者只更新块表),被拒绝的节点的槽位直接作废。
先验证树注意力本身的正确性:树中每个节点的 logits,应该和把"前缀 + 它的祖先 + 它自己"当成普通序列计算的结果一样:
import copy
import time
import torch
from transformers import AutoTokenizer
from mini_llm import KVCache, Transformer, generate
from quant import fake_quant_int
from tree_spec import depths, forward_with_mask, tree_mask, tree_speculative_generate

torch.set_num_threads(16)
path = "models/Qwen3-0.6B"
tok = AutoTokenizer.from_pretrained(path)
target = Transformer.from_pretrained(path)

prefix = tok("树形投机解码的核心是").input_ids
tokens, parents = [100, 200, 300, 400, 500, 600], [-1, 0, 0, 1, 1, 2]   # 一棵小树:根有两个孩子
cache = KVCache(target.cfg.num_hidden_layers)
with torch.no_grad():
    target(torch.tensor([prefix]), cache)
pos = torch.tensor([len(prefix) + d for d in depths(parents)])
logits, _ = forward_with_mask(target, torch.tensor(tokens), pos, cache, tree_mask(parents))
worst = 0.0
for node in range(len(tokens)):
    chain, j = [], node
    while j != -1:
        chain.append(tokens[j])
        j = parents[j]
    with torch.no_grad():
        ref = target(torch.tensor([prefix + chain[::-1]]))[0, -1]
    worst = max(worst, (logits[node] - ref).abs().max().item())
print("掩码(行:节点,列:可见的节点):")
print(tree_mask(parents).int())
print(f"6 个节点与逐条路径单独计算的最大误差:{worst:.1e}")
assert worst < 1e-3
掩码(行:节点,列:可见的节点):
tensor([[1, 0, 0, 0, 0, 0],
        [1, 1, 0, 0, 0, 0],
        [1, 0, 1, 0, 0, 0],
        [1, 1, 0, 1, 0, 0],
        [1, 1, 0, 0, 1, 0],
        [1, 0, 1, 0, 0, 1]], dtype=torch.int32)
6 个节点与逐条路径单独计算的最大误差:1.5e-05
然后跑一次完整的树形投机解码。草稿模型用目标模型的 INT4 伪量化版本(量化后的自己是一个不错的草稿:便宜、而且和目标模型很像),比较链式草稿(每层 top-1,深 4 层)与树形草稿(前两层 top-2,后两层 top-1):
draft = copy.deepcopy(target)
for layer in draft.layers:
    a, f = layer.self_attn, layer.mlp
    for lin in (a.q_proj, a.k_proj, a.v_proj, a.o_proj, f.gate_proj, f.up_proj, f.down_proj):
        lin.weight.data = fake_quant_int(lin.weight.data, 4, "group")

prompt = tok(tok.apply_chat_template([{"role": "user", "content": "解释一下什么是投机解码,以及它为什么能加速。"}],
                                     tokenize=False, add_generation_prompt=True, enable_thinking=False)).input_ids
reference = generate(target, torch.tensor([prompt]), 48, eos_token_id=tok.eos_token_id)[0].tolist()
for name, branching in [("链式草稿 [1, 1, 1, 1]", [1, 1, 1, 1]), ("树形草稿 [2, 2, 1, 1]", [2, 2, 1, 1])]:
    out, calls, accepted = tree_speculative_generate(target, draft, prompt, 48, branching, eos=tok.eos_token_id)
    print(f"{name}:目标模型前向 {calls} 次(普通解码需要 48 次),每次平均前进 {sum(accepted) / len(accepted):.2f} 个 token,"
          f"输出与贪心一致:{out == reference}")
    assert out == reference
链式草稿 [1, 1, 1, 1]:目标模型前向 23 次(普通解码需要 48 次),每次平均前进 2.23 个 token,输出与贪心一致:True
树形草稿 [2, 2, 1, 1]:目标模型前向 21 次(普通解码需要 48 次),每次平均前进 2.45 个 token,输出与贪心一致:True
两种草稿的输出都与目标模型的贪心结果逐 token 相同。树形草稿用更多的草稿 token(每步 14 个节点对 4 个),换来了更长的平均接受长度和更少的目标模型前向次数。实际系统里,树的形状是一个需要调优的参数:树越宽,接受得越长,但验证的 token 数也越多(下文会看到,这在大 batch 下会变得昂贵)。EAGLE-2 进一步按草稿模型的置信度动态决定树的形状。
更好的草稿:EAGLE 与 MTP
草稿的质量决定接受率。常见的草稿来源:
| 草稿 | 做法 | 特点 |
|---|---|---|
| n-gram / 提示词查找 | 在上下文中找相同的后缀,把后面的 token 当草稿 | 零成本,复述、代码编辑类任务效果好(大模型手册的例子) |
| 独立的小模型 | 同系列的小模型当草稿 | 需要词表一致;草稿本身也有不小的开销 |
| Medusa | 在目标模型最后一层加几个预测头,分别预测 +2、+3……位置的 token | 训练简单;各头独立预测,彼此不条件化,准确率有限 |
| EAGLE | 一个很小的草稿网络(约一层 Transformer),输入是目标模型的隐藏状态加上下一个 token 的嵌入,自回归地预测后续的隐藏状态与 token | 利用了目标模型的内部特征,接受率高;EAGLE-3 融合多层特征、并在训练中模拟推理时的误差累积 |
| MTP | DeepSeek-V3 等模型训练时就带有多 token 预测模块,推理时直接作为草稿 | 与目标模型一起训练,质量高;Qwen3-Next、Qwen3.5、GLM 等也带 MTP 层 |
EAGLE 与 MTP 是目前推理引擎中效果最好、最常用的方案。它们的共同点是"长在目标模型身上":直接读取目标模型刚算出的隐藏状态,草稿网络只有一两层,几乎不增加显存。
什么时候有效
投机解码的收益取决于两件事:平均每次验证能前进多少个 token,以及验证 k 个草稿 token 比普通 decode 贵多少。后者由 batch 大小决定:batch 小时 decode 是访存受限的,多验证几个 token 几乎免费;batch 大时每步已经接近计算受限,验证的 token 数翻几倍,时间也翻几倍。用屋顶线模型估算 Qwen2.5-7B 在 H100 上的加速比(每个草稿 token 的接受概率 0.8、每步 4 个草稿,草稿开销按每个 token 为一步 decode 的 5% 估计):
P, weights, kv_per_token, bw, peak, ctx = 7.6e9, 15.2e9, 57344, 3.35e12, 989e12, 1024

def step_time(tokens, batch):                          # 一步前向:算完与读完中较慢的那个,加上固定开销
    return max(2 * P * tokens / (peak * 0.6), (weights + kv_per_token * ctx * batch) / bw) + 0.3e-3

alpha, k = 0.8, 4
expected = (1 - alpha ** (k + 1)) / (1 - alpha)        # 每次验证平均前进的 token 数
print(f"每次验证平均前进 {expected:.2f} 个 token")
print("batch   普通 decode   验证 k+1 个 token   加速比")
for batch in (1, 4, 16, 64, 128, 256):
    decode, verify = step_time(batch, batch), step_time(batch * (k + 1), batch)
    speedup = expected * decode / (verify + k * 0.05 * decode)
    print(f"{batch:5d}   {decode * 1e3:8.2f} ms   {verify * 1e3:10.2f} ms       {speedup:5.2f}x")
每次验证平均前进 3.36 个 token
batch   普通 decode   验证 k+1 个 token   加速比
    1       4.85 ms         4.85 ms        2.80x
    4       4.91 ms         4.91 ms        2.80x
   16       5.12 ms         5.12 ms        2.80x
   64       5.96 ms         8.50 ms        2.07x
  128       7.08 ms        16.69 ms        1.31x
  256       9.32 ms        33.09 ms        0.90x
batch 较小时加速接近 3 倍;batch 到 128 时只剩 1.3 倍,到 256 时反而变慢。所以投机解码最适合低并发、对单请求延迟敏感的场景(交互式对话、Agent 的单条长链路);高吞吐的离线批处理通常应该关掉它,或者按负载动态调整草稿长度(vLLM 与 SGLang 都在做基于负载的自适应)。
在引擎中实现
投机解码对引擎的几乎每个部分都有要求:
- 调度器:请求的
num_tokens包含草稿 token(vLLM 的num_tokens_with_spec),调度器按"要验证的 token 数"分配预算与 KV 槽位;被拒绝的草稿不推进num_computed_tokens,它们写入的 KV 在下一步被覆盖; - 模型执行:验证是一次"每个请求有 k+1 个 query"的前向,注意力后端要支持(树形草稿还要支持自定义掩码);为了用上 CUDA Graph,验证批次的形状要规整;
- 采样:贪心时逐个比较;随机采样时用拒绝采样(vLLM 的
rejection_sampler.py),并在 GPU 上批量完成; - 草稿:EAGLE/MTP 需要目标模型的隐藏状态,草稿网络有自己的 KV Cache 和 CUDA Graph;
- 与其他特性的交互:结构化输出(草稿 token 也要满足语法)、前缀缓存、PD 分离(decode 实例上运行草稿)、流水线并行……
源码对照
- vLLM:
--speculative-config '{"method": "eagle3", "model": "<草稿模型>", "num_speculative_tokens": 3}',method还可以是ngram、mtp、medusa、draft_model、suffix等。草稿在vllm/v1/spec_decode/(eagle.py、ngram_proposer.py、suffix_decoding.py……),验证在vllm/v1/sample/rejection_sampler.py,调度器中的scheduled_spec_decode_tokens与update_draft_token_ids负责草稿 token 的流转。 - SGLang:
--speculative-algorithm EAGLE3(或EAGLE、NEXTN(MTP)、STANDALONE(独立草稿模型)、NGRAM等),--speculative-num-steps(草稿深度)、--speculative-eagle-topk(每层分支数,大于 1 即树形草稿)、--speculative-num-draft-tokens(参与验证的节点数);实现在srt/speculative/(eagle_worker_v2.py、eagle_utils.py中的树构建与验证等)。
怎么讲清楚
投机解码的常见追问链:为什么能加速(decode 访存受限,验证多个 token 几乎免费)→ 为什么不改变输出(贪心逐个比较;采样用拒绝采样,能证明分布不变)→ 草稿从哪来(n-gram、小模型、Medusa、EAGLE、MTP,各自的优缺点)→ 树形草稿(一次验证多条路径,树注意力掩码、深度作为位置、接受路径的 KV 直接复用)→ 什么时候不该用(大 batch 时验证变贵,本章的估算表)。能把最后一点用数字讲清楚,说明你真正理解了屋顶线。
练习
1. 树的节点数。 分支 [2, 2, 1, 1] 的树有多少个草稿节点(不含根)?如果改成 [3, 3, 2] 呢?在 batch = 64 时,你会选哪个?
参考答案
[2, 2, 1, 1]:2 + 4 + 4 + 4 = 14 个节点;[3, 3, 2]:3 + 9 + 18 = 30 个节点。batch = 64 时,验证 64 × 15 ≈ 960 个 token 已经接近计算受限(上表中 k+1 = 5 时就已经明显变贵),30 个节点的树会让验证代价再翻一倍,得不偿失;应该用更窄的树,甚至链式草稿,或者关掉投机解码。
2. 采样时的树。 随机采样时,树形草稿怎样保证输出分布不变?
参考思路
逐层进行拒绝采样:在某个节点,依次考虑它的子节点(草稿提出的候选),对每个候选以 \(\min(1, p(x)/q(x))\) 接受;被拒绝时,把目标分布更新为 \(\text{norm}(\max(0, p - q))\) 再考虑下一个候选(这里的 \(q\) 要按候选的采样方式相应调整);所有候选都被拒绝时,从最后的残差分布中采样一个 token 并结束。SpecInfer、EAGLE 的论文给出了多候选情况下的证明。这比链式的情况复杂,所以很多系统在随机采样时使用更简单的树或链。
小结
- 树形草稿同时准备多条候选,树注意力掩码让每个节点只看到前缀、祖先和自己,位置取"前缀长度 + 深度",一次前向验证整棵树。
- 被接受路径上的 KV 在验证时已经算好,直接复用;被拒绝的直接作废。
- EAGLE(读取目标模型隐藏状态的小草稿网络)与 MTP(模型自带的多 token 预测层)是当前最常用的草稿。
- 小 batch 时加速接近平均接受长度,大 batch 时验证变贵,收益消失甚至变负。
本章练习题(3 道)
在浏览器里直接写代码、跑测试;也可以在本地用 python practice/judge.py 判题。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题