FlashAttention 与推理算子
注意力是大模型里最关键、也最常被问到的算子。这一章从标准注意力的访存问题讲起,推导 FlashAttention 的分块 + online softmax 算法,写出一个能跑通的前向 kernel;然后转向推理:KV Cache、PagedAttention、decode 阶段的 split-K(Flash-Decoding),并实现一个支持 GQA 的分页 decode attention kernel。
自测:能答上来就可以跳过本章
- 标准注意力实现的瓶颈在哪里?为什么说它是访存瓶颈?
- FlashAttention 为什么能在不改变结果的前提下省掉 N×N 矩阵的读写?
- FlashAttention-2 相比第一版做了哪些改进?FlashAttention-3 呢?
- decode 阶段每次只有一个 query,注意力 kernel 应该怎么并行?
- PagedAttention 解决了什么问题?kernel 里多了什么操作?
自测参考答案(先自己答,再展开对照)
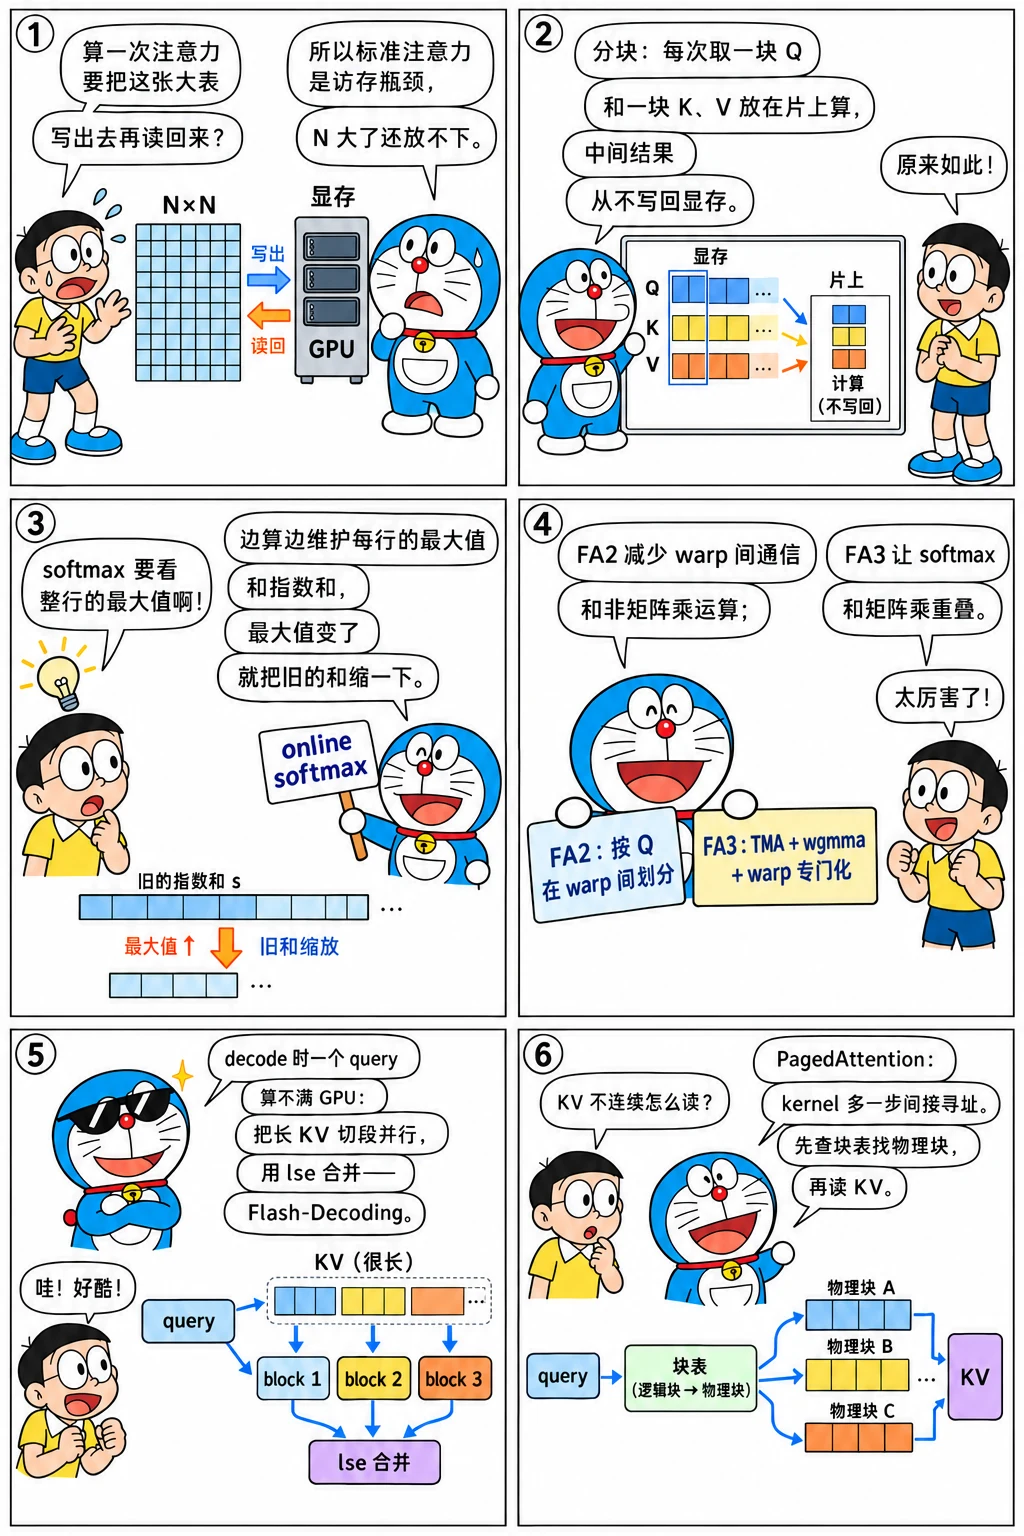
- 要把 N×N 的分数矩阵和注意力权重写回显存、再读出来,计算量本身不大,时间花在这些中间结果的读写上,所以是访存瓶颈(N 大时显存也放不下)。
- 分块计算:每次取一块 Q 和一块 K、V 放在片上,算出这一块的分数,用 online softmax 维护每行的最大值和指数和,边算边合并输出。中间结果从不写回显存,而数学上与完整的 softmax 相同。
- FA2:在序列维度上也并行,按 Q 在 warp 之间划分(减少 warp 间的通信),减少非矩阵乘的运算。FA3:用 Hopper 的 TMA 异步搬运、wgmma、warp 专门化,让 softmax 与矩阵乘重叠,并支持 FP8。
- 一个 query 算不满 GPU:按 batch 和头并行之外,还要把长的 KV 切成几段,由不同的 block 并行计算各自的部分结果,最后用 log-sum-exp 合并(Flash-Decoding / split-KV)。
- KV Cache 的碎片与浪费:按块存放、按块表查找,按需分配,还能在请求之间共享前缀。kernel 里多了一步间接寻址:先按块表查出逻辑块对应的物理块,再去读 KV。
先看一个六格小剧场,再读正文:
标准注意力的问题
其中 Q、K、V 是 N×d(N 是序列长度,d 是每个头的维度,常见 64 或 128)。标准实现分三步,每步一个 kernel:
- 计算 S,写回显存:N×N 个元素;
- 读 S,做 softmax,写回 P:又是 N×N;
- 读 P 和 V,计算 O。
N = 8192 时,每个头的 S 有 6700 万个元素,FP16 就是 128 MB。整个过程读写了好几遍 N×N 的矩阵,而实际计算量(两个 GEMM,约 4N²d)并不大。注意力的瓶颈是 N×N 中间结果的显存读写,而且显存占用随序列长度平方增长。
FlashAttention:分块 + online softmax
核心想法:不把 S 和 P 写回显存。把 Q 按行切成若干块 \(Q_i\)(每块 \(B_r\) 行),K、V 按行切成若干块 \(K_j, V_j\)(每块 \(B_c\) 行)。对每个 \(Q_i\),依次处理所有的 \(K_j, V_j\):
- 在片上计算 \(S_{ij} = Q_i K_j^\top / \sqrt{d}\)(\(B_r \times B_c\),放在寄存器或共享内存);
- 用 online softmax 的方式更新每一行的最大值 \(m\) 和指数和 \(\ell\);
- 把之前累积的输出按新的最大值缩放,再加上这一块的贡献 \(\tilde{P}_{ij} V_j\)。
对第 i 行,处理完第 j 块后:
所有块处理完后,\(O = O^{(\text{last})} / \ell^{(\text{last})}\)。这就是上一章的 online softmax推广到"softmax 之后还要乘 V"的情形:因为输出对 \(\tilde{P}\) 是线性的,缩放因子可以直接作用在累加器 O 上。
结果和标准注意力在数学上完全相同,不是近似。显存读写从 \(O(N^2)\) 降到 \(O(N d)\) 量级(每个 Q 块读一遍所有 K、V),中间结果全在片上。显存占用也从 \(O(N^2)\) 降到 \(O(N)\)。
几代 FlashAttention 的演进
| 版本 | 主要改进 |
|---|---|
| FlashAttention(2022) | 分块 + online softmax,IO 感知;反向传播时重新计算 S 而不是保存它 |
| FlashAttention-2(2023) | 在序列长度维度上也并行(每个 Q 块一个 block),长序列、小 batch 时 GPU 更满;减少非矩阵乘运算(最后才除以 ℓ);warp 之间按 Q 划分而不是按 K 划分,避免 warp 间通过共享内存交换中间结果 |
| FlashAttention-3(2024) | 面向 Hopper:TMA + wgmma + warp 专门化;两个 warpgroup 乒乓执行,让 softmax 与 GEMM 重叠;支持 FP8 |
因果掩码(decoder 模型的自注意力):第 i 个 query 只能看到前 i 个 key。在分块算法里,完全位于对角线上方的块直接跳过,节省将近一半的计算;对角线上的块逐元素加掩码。
一个能跑通的 FlashAttention 前向 kernel
下面是一个教学版本:FP32、不使用 Tensor Core,每个线程负责一个 query 行,一个 block 负责 \(B_r = 64\) 个 query,K、V 每次取 \(B_c = 32\) 行放进共享内存。它的目的是把算法落到代码上,性能远不如正式实现(正式实现用 Tensor Core 计算 \(QK^\top\) 和 \(PV\),每个 warp 负责 16 行,数据在寄存器 fragment 里完成 online softmax)。
// flash_attn.cu —— 教学版 FlashAttention 前向:分块 + online softmax,支持因果掩码
// 编译:nvcc -O3 -arch=sm_75 flash_attn.cu -o flash_attn
// 布局:Q、K、V、O 都是 [batch * heads, seq_len, D] 连续存储
#include "common.cuh"

constexpr int Br = 64;   // 每个 block 处理的 query 行数(= 线程数)
constexpr int Bc = 32;   // 每次加载的 key/value 行数

template <int D>
__global__ void __launch_bounds__(Br)
flash_attn_fwd(const float* __restrict__ Q, const float* __restrict__ K, const float* __restrict__ V,
               float* __restrict__ O, int N, float scale, bool causal) {
  __shared__ float Ks[Bc][D];
  __shared__ float Vs[Bc][D];
  const size_t head_off = static_cast<size_t>(blockIdx.y) * N * D;
  const int q_row = blockIdx.x * Br + threadIdx.x;
  const bool active = q_row < N;

  float q[D], o[D];
#pragma unroll
  for (int k = 0; k < D; ++k) {
    q[k] = active ? Q[head_off + static_cast<size_t>(q_row) * D + k] * scale : 0.f;   // 预先乘上 1/sqrt(d)
    o[k] = 0.f;
  }
  float m = -INFINITY, l = 0.f;

  // 因果掩码:这个 block 最后一个 query 的位置之后的 key 都用不到
  const int kv_end = causal ? min(N, static_cast<int>(blockIdx.x + 1) * Br) : N;
  for (int j0 = 0; j0 < kv_end; j0 += Bc) {
    // 协作加载 K、V 的一块(越界填 0,后面用掩码排除)
    for (int idx = threadIdx.x; idx < Bc * D; idx += Br) {
      const int r = idx / D, c = idx % D, g = j0 + r;
      Ks[r][c] = g < N ? K[head_off + static_cast<size_t>(g) * D + c] : 0.f;
      Vs[r][c] = g < N ? V[head_off + static_cast<size_t>(g) * D + c] : 0.f;
    }
    __syncthreads();

    // 1) 这一块的分数与块内最大值
    float s[Bc];
    float block_max = -INFINITY;
#pragma unroll
    for (int c = 0; c < Bc; ++c) {
      const int key = j0 + c;
      float acc = 0.f;
#pragma unroll
      for (int k = 0; k < D; ++k) acc += q[k] * Ks[c][k];   // 所有线程读同一行:广播
      const bool masked = key >= N || (causal && key > q_row);
      s[c] = masked ? -INFINITY : acc;
      block_max = fmaxf(block_max, s[c]);
    }

    // 2) online softmax 更新;整块都被掩码时 m 保持不变
    const float m_new = fmaxf(m, block_max);
    if (m_new != -INFINITY) {
      const float correction = __expf(m - m_new);   // m 为 -inf 时结果是 0
      float row_sum = 0.f;
#pragma unroll
      for (int c = 0; c < Bc; ++c) {
        s[c] = __expf(s[c] - m_new);                // 被掩码的位置得到 0
        row_sum += s[c];
      }
      l = l * correction + row_sum;
      // 3) 缩放旧的累加器,加上 P V
#pragma unroll
      for (int k = 0; k < D; ++k) {
        float acc = o[k] * correction;
#pragma unroll
        for (int c = 0; c < Bc; ++c) acc += s[c] * Vs[c][k];
        o[k] = acc;
      }
      m = m_new;
    }
    __syncthreads();   // 下一轮覆盖 Ks/Vs 之前,确保大家都用完了
  }

  if (active) {
    const float inv_l = 1.f / l;
#pragma unroll
    for (int k = 0; k < D; ++k) O[head_off + static_cast<size_t>(q_row) * D + k] = o[k] * inv_l;
  }
}

void attention_cpu(const float* Q, const float* K, const float* V, float* O, int BH, int N, int D, bool causal) {
  const double scale = 1.0 / std::sqrt(static_cast<double>(D));
  std::vector<double> s(N);
  for (int h = 0; h < BH; ++h) {
    const size_t off = static_cast<size_t>(h) * N * D;
    for (int i = 0; i < N; ++i) {
      double mx = -1e300;
      const int end = causal ? i + 1 : N;
      for (int j = 0; j < end; ++j) {
        double acc = 0;
        for (int k = 0; k < D; ++k) acc += double(Q[off + i * D + k]) * K[off + j * D + k];
        s[j] = acc * scale;
        mx = std::max(mx, s[j]);
      }
      double sum = 0;
      for (int j = 0; j < end; ++j) { s[j] = std::exp(s[j] - mx); sum += s[j]; }
      for (int k = 0; k < D; ++k) {
        double acc = 0;
        for (int j = 0; j < end; ++j) acc += s[j] * V[off + j * D + k];
        O[off + i * D + k] = static_cast<float>(acc / sum);
      }
    }
  }
}

int main() {
  constexpr int D = 64;
  const int batch_heads = 8, N = 1000;   // 故意不是块大小的整数倍
  const size_t n = static_cast<size_t>(batch_heads) * N * D, bytes = n * sizeof(float);
  std::vector<float> hq(n), hk(n), hv(n), ref(n), got(n);
  fill_random(hq, 1);
  fill_random(hk, 2);
  fill_random(hv, 3);
  float *dq, *dk, *dv, *dout;
  CUDA_CHECK(cudaMalloc(&dq, bytes));
  CUDA_CHECK(cudaMalloc(&dk, bytes));
  CUDA_CHECK(cudaMalloc(&dv, bytes));
  CUDA_CHECK(cudaMalloc(&dout, bytes));
  CUDA_CHECK(cudaMemcpy(dq, hq.data(), bytes, cudaMemcpyHostToDevice));
  CUDA_CHECK(cudaMemcpy(dk, hk.data(), bytes, cudaMemcpyHostToDevice));
  CUDA_CHECK(cudaMemcpy(dv, hv.data(), bytes, cudaMemcpyHostToDevice));

  const float scale = 1.f / std::sqrt(static_cast<float>(D));
  dim3 grid((N + Br - 1) / Br, batch_heads);
  bool ok = true;
  for (bool causal : {false, true}) {
    attention_cpu(hq.data(), hk.data(), hv.data(), ref.data(), batch_heads, N, D, causal);
    flash_attn_fwd<D><<<grid, Br>>>(dq, dk, dv, dout, N, scale, causal);
    CUDA_CHECK_LAST();
    CUDA_CHECK(cudaMemcpy(got.data(), dout, bytes, cudaMemcpyDeviceToHost));
    std::printf("causal=%d  ", causal);
    ok &= check_close(got.data(), ref.data(), n, 1e-3f, 1e-4f);
    float ms = time_ms([&] { flash_attn_fwd<D><<<grid, Br>>>(dq, dk, dv, dout, N, scale, causal); });
    const double flops = 4.0 * batch_heads * N * N * D * (causal ? 0.5 : 1.0);
    std::printf("           %.3f ms, %.2f TFLOPS\n", ms, tflops(flops, ms));
  }
  CUDA_CHECK(cudaFree(dq));
  CUDA_CHECK(cudaFree(dk));
  CUDA_CHECK(cudaFree(dv));
  CUDA_CHECK(cudaFree(dout));
  return ok ? 0 : 1;
}
读这段代码时重点看三处:correction 如何缩放旧的累加器 o 和 l;掩码如何处理(被掩码的分数设为 -inf,指数之后自然为 0);以及整块都被掩码、m 还是 -inf 时如何避免出现 NaN。这三处也是面试中让你手推 FlashAttention 时最常被追问的细节。
推理:prefill 与 decode
大模型推理分两个阶段:
- prefill:一次处理用户输入的整段提示词(几百到几万个 token),Q、K、V 都很长,和训练的前向传播类似,是计算瓶颈,用 FlashAttention 类的 kernel;
- decode:每次只生成一个新 token,只有 1 个 query,但要和之前所有 token 的 K、V 做注意力。之前的 K、V 在每一步都保存下来,这就是 KV Cache。decode 的注意力本质上是矩阵向量乘,是访存瓶颈:每一步都要把整个 KV Cache 从显存读一遍。
KV Cache 的大小:2 × 层数 × KV 头数 × 头维度 × 序列长度 × 每元素字节数。以一个 32 层、8 个 KV 头、头维度 128 的模型为例,BF16 下每个 token 占 2 × 32 × 8 × 128 × 2 B = 128 KB,一个 32K 长度的请求就要 4 GB。这就是 GQA(多个 query 头共享一组 KV 头)、MLA(DeepSeek 把 KV 压缩成低秩的潜向量)、KV Cache 量化等技术出现的原因。
PagedAttention
如果给每个请求按最大长度预先分配一段连续的 KV Cache,会浪费大量显存(请求的实际长度事先未知),而且会产生碎片。vLLM 提出的 PagedAttention 借鉴了操作系统的分页:
- KV Cache 被切成固定大小的块(page),比如每块 16 个 token;
- 每个请求有一张块表(block table),记录它的第 i 个逻辑块存放在哪个物理块里;
- 物理块按需分配,请求结束后回收;多个请求共享相同前缀时可以共享物理块(前缀缓存)。
对 kernel 来说,唯一的变化是读 K、V 时多了一次间接寻址:第 t 个 token 的 K 位于物理块 block_table[t / page_size] 的第 t % page_size 个位置。SGLang 的 RadixAttention 在此基础上用基数树管理前缀,最大化 KV Cache 的复用。
decode 阶段的并行:Flash-Decoding 与 split-K
decode 时每个 (请求, 头) 只有一个 query。如果一个 block 负责一个 (请求, 头),batch 小时 block 数远少于 SM 数,GPU 大量空闲;序列很长时,单个 block 要串行扫完几万个 token。
Flash-Decoding 把 KV 序列切成若干段(split-K),每段由一个 block 处理,各自算出这一段的部分输出和 \((m, \ell)\),最后再用 online softmax 的合并规则把各段合并:
其中 \(O_s\) 是第 s 段已经归一化过的输出。这样即使 batch = 1,也能用上所有 SM。
一个分页 decode attention kernel(支持 GQA)
下面的 kernel 实现了 decode 阶段的注意力:每个 block 负责一个 (序列, query 头),K、V 通过块表从分页的 KV Cache 中读取,多个 query 头共享一个 KV 头(GQA)。为了清楚,没有做 split-K,分三步完成:
- 每个 warp 负责一部分 token,warp 内 32 个线程并行地算 q 和 k 的点积(每个线程负责 D/32 个维度,再做 warp 归约),分数写入共享内存;
- block 内求最大值和指数和;
- 每个线程负责输出的一个维度,遍历所有 token 累加 \(p_t V_t\)。同一时刻相邻线程读 V 的相邻维度,访问是合并的。
// paged_decode.cu —— 分页 KV Cache 上的 decode 注意力,支持 GQA
// 编译:nvcc -O3 -arch=sm_75 paged_decode.cu -o paged_decode
// KV Cache 布局:[num_physical_blocks, PAGE, num_kv_heads, D]
#include "common.cuh"

constexpr int PAGE = 16;          // 每个物理块存 16 个 token
constexpr int kThreads = 128;     // 4 个 warp
constexpr int kMaxCtx = 4096;     // 本示例支持的最大上下文长度(分数放在共享内存里)

__device__ __forceinline__ float warp_sum(float v) {
  for (int m = 16; m > 0; m /= 2) v += __shfl_xor_sync(0xffffffff, v, m);
  return v;
}
__device__ __forceinline__ float warp_max(float v) {
  for (int m = 16; m > 0; m /= 2) v = fmaxf(v, __shfl_xor_sync(0xffffffff, v, m));
  return v;
}

template <int D>
__global__ void __launch_bounds__(kThreads)
paged_decode_attention(const float* __restrict__ q,          // [num_seqs, num_heads, D]
                       const float* __restrict__ k_cache,    // [num_blocks, PAGE, num_kv_heads, D]
                       const float* __restrict__ v_cache,
                       const int* __restrict__ block_table,  // [num_seqs, max_blocks_per_seq]
                       const int* __restrict__ context_lens, // [num_seqs]
                       float* __restrict__ out,              // [num_seqs, num_heads, D]
                       int num_heads, int num_kv_heads, int max_blocks_per_seq, float scale) {
  static_assert(D % 32 == 0 && D <= kThreads, "one output dim per thread");
  constexpr int kDimsPerLane = D / 32;
  __shared__ float scores[kMaxCtx];
  __shared__ float red[kThreads / 32];

  const int seq = blockIdx.y, head = blockIdx.x;
  const int kv_head = head / (num_heads / num_kv_heads);   // GQA:若干个 query 头共享一个 KV 头
  const int ctx = context_lens[seq];
  const int lane = threadIdx.x % 32, warp = threadIdx.x / 32, nwarps = kThreads / 32;
  const int* table = block_table + static_cast<size_t>(seq) * max_blocks_per_seq;

  // 每个 lane 持有 q 的 kDimsPerLane 个维度
  const float* qp = q + (static_cast<size_t>(seq) * num_heads + head) * D;
  float qr[kDimsPerLane];
#pragma unroll
  for (int i = 0; i < kDimsPerLane; ++i) qr[i] = qp[lane + i * 32] * scale;

  // 第 1 步:分数。warp w 处理 token w, w + nwarps, ...
  float local_max = -INFINITY;
  for (int t = warp; t < ctx; t += nwarps) {
    const int phys = table[t / PAGE], slot = t % PAGE;
    const float* kp = k_cache + ((static_cast<size_t>(phys) * PAGE + slot) * num_kv_heads + kv_head) * D;
    float dot = 0.f;
#pragma unroll
    for (int i = 0; i < kDimsPerLane; ++i) dot += qr[i] * kp[lane + i * 32];
    dot = warp_sum(dot);
    if (lane == 0) scores[t] = dot;
    local_max = fmaxf(local_max, dot);
  }

  // 第 2 步:block 内最大值 → 指数与求和
  if (lane == 0) red[warp] = local_max;
  __syncthreads();
  float mx = lane < nwarps ? red[lane] : -INFINITY;
  mx = warp_max(mx);            // 每个 warp 都算一遍,结果相同,省去一次广播
  __syncthreads();
  float local_sum = 0.f;
  for (int t = threadIdx.x; t < ctx; t += kThreads) {
    float p = __expf(scores[t] - mx);
    scores[t] = p;
    local_sum += p;
  }
  local_sum = warp_sum(local_sum);
  if (lane == 0) red[warp] = local_sum;
  __syncthreads();
  float sum = lane < nwarps ? red[lane] : 0.f;
  sum = warp_sum(sum);
  const float inv_sum = 1.f / sum;

  // 第 3 步:输出。线程 d 负责第 d 个维度
  if (threadIdx.x < D) {
    const int d = threadIdx.x;
    float acc = 0.f;
    for (int t = 0; t < ctx; ++t) {
      const int phys = table[t / PAGE], slot = t % PAGE;
      acc += scores[t] * v_cache[((static_cast<size_t>(phys) * PAGE + slot) * num_kv_heads + kv_head) * D + d];
    }
    out[(static_cast<size_t>(seq) * num_heads + head) * D + d] = acc * inv_sum;
  }
}

int main() {
  constexpr int D = 128;
  const int num_seqs = 4, num_heads = 32, num_kv_heads = 8;
  const std::vector<int> ctx_lens = {1, 17, 1000, 4096};   // 各种长度,包括不满一页的情况
  int max_blocks_per_seq = 0, total_blocks = 0;
  for (int c : ctx_lens) {
    max_blocks_per_seq = std::max(max_blocks_per_seq, (c + PAGE - 1) / PAGE);
    total_blocks += (c + PAGE - 1) / PAGE;
  }
  // 物理块随机打乱分配,模拟真实的分页情况
  std::vector<int> perm(total_blocks);
  for (int i = 0; i < total_blocks; ++i) perm[i] = i;
  std::shuffle(perm.begin(), perm.end(), std::mt19937(7));
  std::vector<int> table(static_cast<size_t>(num_seqs) * max_blocks_per_seq, -1);
  for (int s = 0, next = 0; s < num_seqs; ++s)
    for (int b = 0; b < (ctx_lens[s] + PAGE - 1) / PAGE; ++b) table[s * max_blocks_per_seq + b] = perm[next++];

  const size_t cache_elems = static_cast<size_t>(total_blocks) * PAGE * num_kv_heads * D;
  const size_t q_elems = static_cast<size_t>(num_seqs) * num_heads * D;
  std::vector<float> hq(q_elems), hk(cache_elems), hv(cache_elems), ref(q_elems), got(q_elems);
  fill_random(hq, 1);
  fill_random(hk, 2);
  fill_random(hv, 3);
  const float scale = 1.f / std::sqrt(static_cast<float>(D));

  // CPU 参考:按逻辑顺序展开 KV
  for (int s = 0; s < num_seqs; ++s)
    for (int h = 0; h < num_heads; ++h) {
      const int kvh = h / (num_heads / num_kv_heads), ctx = ctx_lens[s];
      std::vector<double> sc(ctx);
      double mx = -1e300;
      for (int t = 0; t < ctx; ++t) {
        const int phys = table[s * max_blocks_per_seq + t / PAGE], slot = t % PAGE;
        const float* kp = &hk[((static_cast<size_t>(phys) * PAGE + slot) * num_kv_heads + kvh) * D];
        double dot = 0;
        for (int d = 0; d < D; ++d) dot += double(hq[(s * num_heads + h) * D + d]) * kp[d];
        sc[t] = dot * scale;
        mx = std::max(mx, sc[t]);
      }
      double sum = 0;
      for (int t = 0; t < ctx; ++t) { sc[t] = std::exp(sc[t] - mx); sum += sc[t]; }
      for (int d = 0; d < D; ++d) {
        double acc = 0;
        for (int t = 0; t < ctx; ++t) {
          const int phys = table[s * max_blocks_per_seq + t / PAGE], slot = t % PAGE;
          acc += sc[t] * hv[((static_cast<size_t>(phys) * PAGE + slot) * num_kv_heads + kvh) * D + d];
        }
        ref[(s * num_heads + h) * D + d] = static_cast<float>(acc / sum);
      }
    }

  float *dq, *dk, *dv, *dout;
  int *dtable, *dctx;
  CUDA_CHECK(cudaMalloc(&dq, q_elems * sizeof(float)));
  CUDA_CHECK(cudaMalloc(&dout, q_elems * sizeof(float)));
  CUDA_CHECK(cudaMalloc(&dk, cache_elems * sizeof(float)));
  CUDA_CHECK(cudaMalloc(&dv, cache_elems * sizeof(float)));
  CUDA_CHECK(cudaMalloc(&dtable, table.size() * sizeof(int)));
  CUDA_CHECK(cudaMalloc(&dctx, num_seqs * sizeof(int)));
  CUDA_CHECK(cudaMemcpy(dq, hq.data(), q_elems * sizeof(float), cudaMemcpyHostToDevice));
  CUDA_CHECK(cudaMemcpy(dk, hk.data(), cache_elems * sizeof(float), cudaMemcpyHostToDevice));
  CUDA_CHECK(cudaMemcpy(dv, hv.data(), cache_elems * sizeof(float), cudaMemcpyHostToDevice));
  CUDA_CHECK(cudaMemcpy(dtable, table.data(), table.size() * sizeof(int), cudaMemcpyHostToDevice));
  CUDA_CHECK(cudaMemcpy(dctx, ctx_lens.data(), num_seqs * sizeof(int), cudaMemcpyHostToDevice));

  dim3 grid(num_heads, num_seqs);
  auto launch = [&] {
    paged_decode_attention<D><<<grid, kThreads>>>(dq, dk, dv, dtable, dctx, dout, num_heads, num_kv_heads,
                                                  max_blocks_per_seq, scale);
  };
  launch();
  CUDA_CHECK_LAST();
  CUDA_CHECK(cudaMemcpy(got.data(), dout, q_elems * sizeof(float), cudaMemcpyDeviceToHost));
  bool ok = check_close(got.data(), ref.data(), q_elems, 1e-3f, 1e-5f);
  float ms = time_ms(launch);
  size_t kv_bytes = 0;
  for (int c : ctx_lens) kv_bytes += static_cast<size_t>(c) * num_heads * D * 2 * sizeof(float);
  std::printf("paged decode: %.3f ms, %.1f GB/s of K/V reads (GQA heads re-read shared KV)\n", ms, gbps(kv_bytes, ms));
  CUDA_CHECK(cudaFree(dq));
  CUDA_CHECK(cudaFree(dout));
  CUDA_CHECK(cudaFree(dk));
  CUDA_CHECK(cudaFree(dv));
  CUDA_CHECK(cudaFree(dtable));
  CUDA_CHECK(cudaFree(dctx));
  return ok ? 0 : 1;
}
这个 kernel 还有很多可以改进的地方,正好可以作为练习和面试的讨论素材:
- GQA 的重复读取:同一个 KV 头被 4 个 query 头的 4 个 block 各读一遍。更好的做法是一个 block 同时处理共享同一 KV 头的所有 query 头,KV 只读一次;
- split-K:长序列、小 batch 时按上一节的 Flash-Decoding 方式切分;
- 向量化与低精度:KV Cache 实际是 BF16 或 FP8,用 128 位读取,在寄存器里转换成 FP32 计算;
- 分数不放共享内存:上下文很长时共享内存放不下全部分数,改用 online softmax 边扫描边累加输出,这也是 FlashInfer、vLLM 里 decode kernel 的做法。
实际工程中,FlashInfer、FlashAttention 的 flash_attn_with_kvcache、vLLM 和 SGLang 自带的 attention 后端都提供了高度优化的 paged prefill/decode kernel。读它们的源码是非常好的进阶练习。
怎么讲清楚
讲 FlashAttention:标准注意力的瓶颈是 N×N 中间矩阵的显存读写;FlashAttention 分块计算、用 online softmax 在片上合并,结果精确不变,显存从 \(O(N^2)\) 降到 \(O(N)\);FA2 在序列维度并行、按 Q 在 warp 间划分,FA3 用 Hopper 的 TMA、wgmma 和 warp 专门化。推理侧:prefill 计算受限,decode 访存受限——每次只有一个 query,要用 split-KV(Flash-Decoding)并行长序列;PagedAttention 在 kernel 里多一次块表的间接寻址;GQA 下让一个 block 处理共享同一个 KV 头的所有 query 头,避免重复读 KV。
练习
1. 手推题。 用 online softmax 的方式,对一行分数 [1, 3](第一块)和 [2, 5](第二块),V 的对应行分别是标量 [10, 20] 和 [30, 40],逐步写出 m、ℓ、O 的变化,验证最终结果等于直接计算的 softmax 加权和。
参考答案
- 第一块:m = 3,\(\tilde{p} = [e^{-2}, 1] ≈ [0.1353, 1]\),ℓ = 1.1353,O = 0.1353 × 10 + 1 × 20 = 21.353。
- 第二块:块内最大值 5,m' = 5,correction = \(e^{3-5} = e^{-2} ≈ 0.1353\);\(\tilde{p} = [e^{-3}, 1] ≈ [0.0498, 1]\);ℓ = 1.1353 × 0.1353 + 1.0498 ≈ 1.2034;O = 21.353 × 0.1353 + 0.0498 × 30 + 1 × 40 ≈ 2.890 + 1.494 + 40 = 44.384。
- 最终输出 O / ℓ ≈ 44.384 / 1.2034 ≈ 36.88。
- 直接计算:权重 \(\propto [e^{1}, e^{3}, e^{2}, e^{5}] = [2.718, 20.09, 7.389, 148.4]\),和为 178.6;加权和 = (27.18 + 401.7 + 221.7 + 5936) / 178.6 ≈ 36.88。两者一致。
2. 实现 split-K 合并。 给定 S 段的部分结果:每段已归一化的输出 \(O_s\)(长度 D)以及 \((m_s, \ell_s)\),写一个 kernel 合并出最终输出。
参考思路
一个 block 负责一个 (序列, 头),线程 d 负责第 d 维:先由任意线程(或每个线程重复计算)求出 \(m = \max_s m_s\) 与权重 \(w_s = e^{m_s - m} \ell_s\),\(\ell = \sum_s w_s\);然后 \(O[d] = \sum_s w_s O_s[d] / \ell\)。S 一般不大(几到几十),权重可以先写进共享内存。注意某一段没有任何有效 token 时(ℓ = 0、m = -inf),要跳过它以避免 NaN。
3. 思考题:GQA 的读取放大。 在 paged_decode.cu 中,num_heads = 32、num_kv_heads = 8。每个 decode 步骤,KV Cache 实际被从显存读取了几遍?怎么改成只读一遍?
参考答案
每个 KV 头被 32 / 8 = 4 个 query 头共享,而每个 query 头是一个独立的 block,所以 KV Cache 被读了 4 遍(L2 能挡住一部分,但不可靠)。改进方法是让一个 block 处理一个 (序列, KV 头),同时计算这个 KV 头对应的 4 个 query 头:读一次 K 行,同时与 4 个 q 做点积;读一次 V 行,同时累加到 4 个输出。decode 是访存瓶颈,这个改动几乎能带来成倍的加速。这正是 FlashInfer 等库为 GQA 做的专门优化。
小结
- 标准注意力的瓶颈是 N×N 中间结果的显存读写;FlashAttention 用分块 + online softmax 把它们留在片上,结果精确不变。
- FA2 在序列维度并行、按 Q 在 warp 间划分;FA3 利用 Hopper 的 TMA、wgmma、warp 专门化。
- prefill 是计算瓶颈,decode 是访存瓶颈;KV Cache 的大小决定了 decode 的开销和并发能力。
- PagedAttention 用块表管理 KV Cache,kernel 里多一次间接寻址;Flash-Decoding 用 split-K 并行长序列。
- GQA 下应让一个 block 处理共享同一 KV 头的所有 query 头,避免重复读取。
本章练习题(2 道)
在浏览器里直接写代码、跑测试;也可以在本地用 python practice/judge.py 判题。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题