PD 分离与 KV 传输
prefill 是计算密集的,decode 是访存密集的,放在同一组 GPU 上会互相干扰,也无法各自选择最合适的并行方式和批大小。PD 分离把它们放到不同的实例上:prefill 实例算出提示词的 KV Cache 和第一个 token,把 KV 传给 decode 实例继续生成。这一章用迷你引擎实现这套流程(两个实例连块大小都不同),验证输出不变,再讨论传输的代价、KV 布局的转换,以及 vLLM、SGLang 中的实现。
自测:能答上来就可以跳过本章
- PD 分离解决了哪两个问题?什么情况下不值得做?
- KV 从 prefill 实例传到 decode 实例,数据量有多大?能不能藏在计算后面?
- 两边的并行方式不同(例如 prefill TP=4、decode TP=8)时,KV 传输要做什么额外处理?
- 为什么 decode 实例通常先分配好块,再让 prefill 实例把 KV 写进来?
自测参考答案(先自己答,再展开对照)
- 两个问题:prefill 和 decode 放在一起会互相干扰(长 prefill 让 decode 卡顿、TPOT 抖动);两个阶段性质不同,却只能用同一种并行方式和批大小。分离后各自选最优配置、分别扩缩容。规模小、提示词短、对 TPOT 抖动不敏感时不值得做,分块 prefill 就够了。
- 每 token 的 KV × 提示词长度:LLaMA-3-70B 一个 4K 的提示词约 1.34 GB,单条 400 Gb/s 链路约 27 ms;DeepSeek-V3(MLA)只有 0.29 GB、约 6 ms。这大约是 prefill 时间的五分之一,而且一台机器有 8 条链路并行,逐层传输能把大部分藏在计算后面。
- 两边的 KV 切分方式不同(按头切成 4 份和 8 份)、块大小和布局也可能不同,传输时要做布局转换:按 prefill 端的块表收集,按 decode 端的切分重新分发、写进它的块表对应的位置。
- decode 实例先确认有地方放、分配好块,再告诉 prefill 实例地址,prefill 实例直接把数据写进去:避免中间缓冲区的额外拷贝,也避免 decode 实例显存不够时 prefill 白算一遍。
先看一个六格小剧场,再读正文:
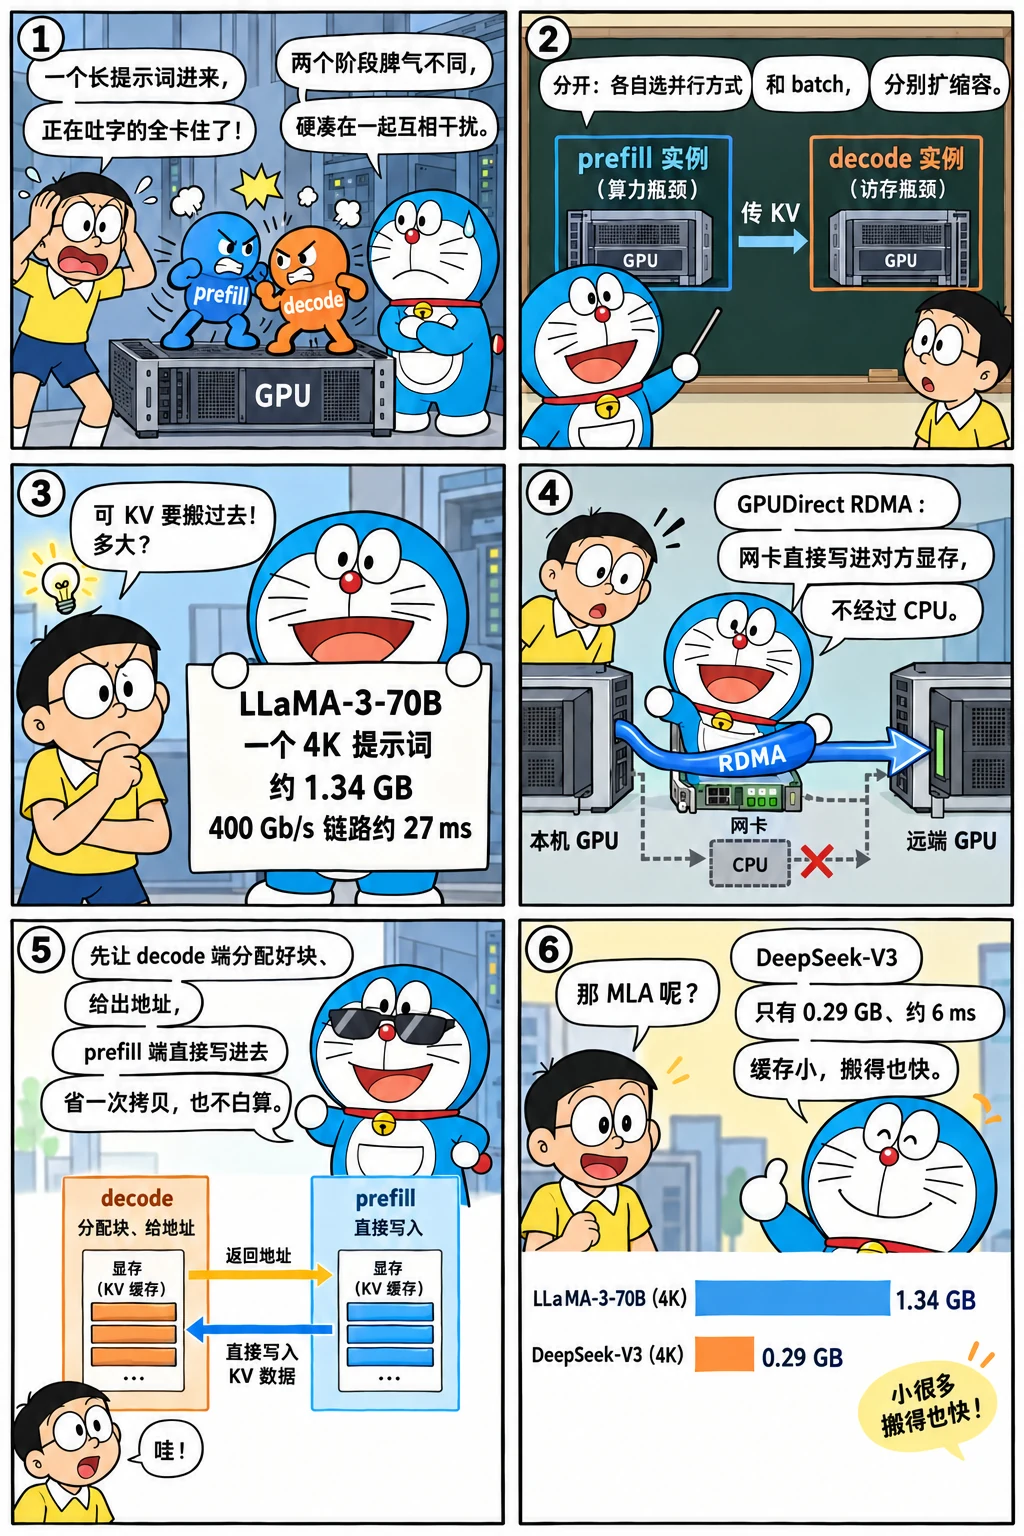
为什么要分离
大模型手册的推理服务一章介绍过动机,这里换成部署者的视角:
- 干扰:一个长提示词的 prefill 插进来,同一批次里所有 decode 请求这一步都要等它(调度器一章实测过 TPOT 尖峰)。分块 prefill 能缓解,但不能消除;在同一张卡上按 SM 切开的做法见 PD 复用。
- 最优配置不同:prefill 希望用较小的 TP 或 EP、较大的 token 批次,把算力吃满;decode 希望用尽量大的 batch 摊薄权重读取,DeepSeek 这类 MoE 模型还希望用很大的 EP(见专家并行),并用上 CUDA Graph 和低延迟通信。混在一起只能折中。
- SLO 解耦:TTFT 主要由 prefill 实例决定,TPOT 主要由 decode 实例决定,两者可以分别扩缩容。prefill 实例与 decode 实例的数量比(常说的 xPyD)按负载调整。
代价是 KV 的传输开销、更复杂的系统,以及资源可能不均衡(一边忙一边闲)。规模小、提示词短、对 TPOT 抖动不敏感时,不分离、用分块 prefill 往往就够了。
流程
             ① 请求                    ② prefill 实例:计算提示词,得到 KV 和第一个 token
客户端 ─────▶ 路由器 ──────────────▶ ┌────────────────────────┐
                │                     │  Prefill 实例(TP/EP 较小)│
                │ ③ 在 decode 实例上   └───────────┬────────────┘
                │   预先分配 KV 块                  │ ④ 按块(或逐层)把 KV 写进
                ▼                                 ▼   decode 实例的显存(RDMA)
         ┌────────────────────────┐   ◀───────────┘
         │  Decode 实例(EP/batch 大)│ ⑤ 收到"传输完成",请求进入运行队列,继续 decode
         └────────────────────────┘ ⑥ 流式返回
实际系统在细节上各有不同,但有两点几乎一致:decode 实例先分配好 KV 块,prefill 实例直接把数据写进这些块(避免中间缓冲、避免 decode 实例显存不够时白算一遍);KV 可以逐层传输:prefill 算完一层就开始传这一层,传输与后续层的计算重叠。
实现
两个 LLMEngine 实例分别扮演 prefill 和 decode 的角色。prefill 实例的块大小是 16,decode 实例是 32,所以"传输"不是按块原样拷贝,而是先按 prefill 实例的块表把 KV 收集出来,再按 decode 实例的块表写进去,这就是一次布局转换:
"""pd.py —— PD 分离的最小实现:prefill 实例算出 KV 和第一个 token,把 KV 传给 decode 实例继续生成。

两个实例是两个独立的 LLMEngine(各自的块池、KV 张量,甚至块大小都可以不同),
"传输"就是按块表把 KV 从一边的物理块拷贝到另一边的物理块;真实系统中这一步由 RDMA 完成。
"""

import math

import torch

from nano_engine import LLMEngine, Request, SamplingParams, Status
from runner import build_batch


@torch.no_grad()
def prefill(engine: LLMEngine, prompt_ids: list[int]):
    """在 prefill 实例上计算整段提示词,返回第一个 token 和按层收集好的 K/V([层][seq, kv_heads, head_dim])。"""
    n_blocks = math.ceil(len(prompt_ids) / engine.block_size)
    blocks = engine.pool.allocate(n_blocks)
    logits = engine.runner.forward(build_batch([(prompt_ids, 0, blocks, True)], engine.block_size))
    first_token = logits.argmax(-1).item()
    kv = [engine.kv.gather(layer, blocks, len(prompt_ids)) for layer in range(len(engine.kv.k))]
    engine.pool.free(blocks)                        # 传输完成后,prefill 实例立即释放这些块
    return first_token, kv


def admit(engine: LLMEngine, prompt_ids: list[int], first_token: int, kv, params: SamplingParams) -> Request:
    """在 decode 实例上接收 KV:分配块、写入,然后让请求直接以"已计算完提示词"的状态进入运行队列。"""
    req = Request(f"pd-{engine._next_id}", prompt_ids, params)
    engine._next_id += 1
    n = len(prompt_ids)
    req.block_ids = engine.pool.allocate(math.ceil((n + 1) / engine.block_size))
    slots = torch.tensor([req.block_ids[p // engine.block_size] * engine.block_size + p % engine.block_size
                          for p in range(n)])
    for layer, (k, v) in enumerate(kv):
        engine.kv.write(layer, slots, k, v)
    req.output_ids, req.num_computed = [first_token], n  # 提示词的 KV 已就位,下一步直接 decode
    req.status = Status.RUNNING
    engine.scheduler.running.append(req)
    return req
admit 之后,这个请求在 decode 实例看来就是一个"提示词已经算完、已经生成了 1 个 token"的普通运行中请求:num_computed 等于提示词长度,num_tokens 比它多 1,调度器下一步就会给它分配 1 个 token,也就是 decode。
import torch
from transformers import AutoTokenizer
from mini_llm import Transformer
from nano_engine import LLMEngine, SamplingParams
from pd import admit, prefill

torch.set_num_threads(16)
path = "models/Qwen3-0.6B"
tok = AutoTokenizer.from_pretrained(path)
model = Transformer.from_pretrained(path)

def chat(q):
    return tok(tok.apply_chat_template([{"role": "user", "content": q}], tokenize=False,
                                       add_generation_prompt=True, enable_thinking=False)).input_ids

prompts = [chat(q) for q in ["什么是 PD 分离?", "介绍一下 RDMA。", "写一句关于秋天的诗。", "Explain KV cache transfer."]]
params = SamplingParams(max_tokens=24)
reference = LLMEngine(model, eos_token_id=tok.eos_token_id).generate(prompts, params)   # 不分离

prefill_instance = LLMEngine(model, eos_token_id=tok.eos_token_id, block_size=16)
decode_instance = LLMEngine(model, eos_token_id=tok.eos_token_id, block_size=32)
requests, transferred = [], 0
for p in prompts:
    first_token, kv = prefill(prefill_instance, p)
    transferred += sum(k.numel() + v.numel() for k, v in kv) * 2        # 按 BF16 计算
    requests.append(admit(decode_instance, p, first_token, kv, params))
while decode_instance.scheduler.has_unfinished():
    decode_instance.step()

print(f"4 个请求共 {sum(len(p) for p in prompts)} 个提示词 token,传输 KV {transferred / 1024:.0f} KB")
print("与不分离的结果一致:", [r.output_ids == o for r, o in zip(requests, reference)])
assert all(r.output_ids == o for r, o in zip(requests, reference))
传输的代价
每个 token 的 KV 大小就是大模型手册里估算过的"KV/token"。传输一个请求的 KV 需要多久?
cases = {"LLaMA-3-70B(GQA,320 KB/token)": 320 * 1024, "DeepSeek-V3(MLA,69 KB/token)": 70272}
prompt_len, rdma = 4096, 50e9                                      # 4K 提示词;400 Gb/s RDMA ≈ 50 GB/s
prefill_ms = 2 * 70.55e9 * prompt_len / (8 * 989e12 * 0.5) * 1e3   # 70B 在 8 张 H100 上 prefill(MFU 50%)
for name, per_token in cases.items():
    size = per_token * prompt_len
    print(f"{name}:4K 提示词的 KV {size / 1e9:.2f} GB,单条 400 Gb/s 链路传输 {size / rdma * 1e3:.0f} ms")
print(f"对比:70B 模型在 8 张 H100 上 prefill 4K token 约 {prefill_ms:.0f} ms")
LLaMA-3-70B(GQA,320 KB/token):4K 提示词的 KV 1.34 GB,单条 400 Gb/s 链路传输 27 ms
DeepSeek-V3(MLA,69 KB/token):4K 提示词的 KV 0.29 GB,单条 400 Gb/s 链路传输 6 ms
对比:70B 模型在 8 张 H100 上 prefill 4K token 约 146 ms
传输时间约为 prefill 时间的五分之一(而且一台机器通常有 8 条这样的链路,按卡并行传输),如果逐层传输、与计算重叠,大部分可以被隐藏。MLA 的 KV 小得多,传输压力更小,这也是 DeepSeek 类模型特别适合 PD 分离的原因之一。
布局转换
真实系统里,两边的 KV 布局往往不同:
- 块大小不同:本章的例子,按 token 重新映射即可;
- TP 不同:prefill TP=4 时每张卡存 1/4 的 KV 头,decode TP=8 时每张卡存 1/8。一张 prefill 卡的 KV 要拆给两张 decode 卡,或者反过来合并;
- 注意力后端不同:不同后端要求的物理布局不同(例如 K、V 是否拼在一起,头维和 token 维的顺序),vLLM 的 KV connector 可以声明自己需要的布局(
get_required_kvcache_layout); - 数据类型不同:一边 BF16、一边 FP8 KV,需要在传输前后转换。
这些转换最好在 GPU 上、在传输前后顺手完成,否则会成为新的瓶颈。
源码对照
- vLLM:PD 分离通过 KV connector 接口实现(
vllm/distributed/kv_transfer/kv_connector/v1/base.py中的KVConnectorBase_V1),分为两侧:调度器侧的get_num_new_matched_tokens(这个请求有多少 token 的 KV 可以从外部加载)、update_state_after_alloc、build_connector_meta、request_finished;worker 侧的start_load_kv、wait_for_layer_load、save_kv_layer、wait_for_save,天然支持逐层加载和保存。实现有nixl/(NVIDIA NIXL,RDMA 传输)、mooncake/、lmcache_connector.py、offloading_connector.py等,用--kv-transfer-config配置。调度器中的WAITING_FOR_REMOTE_KVS状态表示"KV 还在传输中"。 - SGLang:
--disaggregation-mode prefill|decode启动两类实例,--disaggregation-transfer-backend选择mooncake、nixl等传输后端;逻辑在srt/disaggregation/(prefill.py、decode.py,以及各后端的子目录),decode 侧预先分配 KV 并通过 bootstrap 服务与 prefill 侧握手。 - 生态中还有 NVIDIA Dynamo、llm-d、Mooncake 等以 PD 分离和 KV 管理为核心的调度框架。
怎么讲清楚
讲 PD 分离时,至少覆盖四点:动机(干扰与配置冲突,TTFT/TPOT 解耦)、流程(decode 预分配 → prefill 计算并逐层推送 KV → decode 接管)、代价(KV 大小 × 带宽的估算,能用本章的数字说明"可以被重叠隐藏")、难点(布局转换、xPyD 配比随负载变化、故障与重试、小规模时不划算)。能提到 vLLM 的 KV connector 接口或 SGLang 的 disaggregation 模式,说明你看过实现。
练习
1. xPyD 配比。 某业务平均提示词 2000 token、输出 300 token。一个 prefill 实例每秒能处理 20000 个提示词 token,一个 decode 实例在满足 TPOT SLO 时每秒能输出 3000 个 token。要支持每秒 30 个请求,需要多少个 prefill 实例和 decode 实例?
参考答案
提示词 token:30 × 2000 = 60000 个/秒,需要 3 个 prefill 实例;输出 token:30 × 300 = 9000 个/秒,需要 3 个 decode 实例。即 3P3D,再各留一些余量。如果业务变成平均提示词 8000 token,prefill 需求翻两番,需要 12 个 prefill 实例,而 decode 实例数不变。这就是为什么 xPyD 需要按负载动态调整。
2. 前缀缓存怎么办? PD 分离之后,前缀缓存应该放在 prefill 实例、decode 实例,还是别的地方?
参考思路
前缀缓存的作用是减少 prefill 计算,所以首先要在 prefill 实例上命中,路由器应该把共享前缀的请求发往同一个 prefill 实例(缓存感知路由)。decode 实例上的 KV 在请求结束后也可以保留,多轮对话的下一轮如果被路由到同一个 decode 实例,理论上可以复用,但下一轮还需要 prefill 新的内容,所以更常见的做法是建一个独立于实例的 KV 缓存池(CPU 内存、SSD 或分布式存储,例如 Mooncake Store、LMCache),prefill 实例从中加载命中的前缀。这就是下一章的内容。
小结
- PD 分离消除 prefill 与 decode 的干扰,让两者各自选择最优配置,并分别扩缩容。
- 流程:decode 预分配 KV 块,prefill 计算后(逐层)写入,decode 以"提示词已算完"的状态接管请求。
- KV 传输量 = 每 token KV × 提示词长度,在 RDMA 带宽下约为 prefill 时间的几分之一,可以与计算重叠。
- 块大小、TP、注意力后端、数据类型不同时,传输前后需要做布局转换。
本章练习题(2 道)
在浏览器里直接写代码、跑测试;也可以在本地用 python practice/judge.py 判题。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题