调度器:连续批处理、分块 prefill 与抢占
调度器是推理引擎的大脑。每一步它都要决定:这一步算哪些请求、每个请求算多少个 token、显存不够时牺牲谁。这一章按照 vLLM V1 的思路,实现一个完整的调度器和引擎主循环:连续批处理、分块 prefill、重算式抢占,并验证在各种调度参数下,输出都与逐个请求单独生成逐 token 一致。
自测:能答上来就可以跳过本章
- vLLM V1 的调度器为什么说"没有 prefill 阶段和 decode 阶段"?它每一步在做什么?
max_num_batched_tokens调大、调小分别影响什么指标?- 显存不够时,vLLM 抢占哪个请求?被抢占的请求之后怎么恢复?和 SGLang 的做法有何不同?
- 为什么发生抢占的这一步不再接收新请求?
自测参考答案(先自己答,再展开对照)
- 它不区分阶段,每一步只做一件事:在 token 预算内,让每个请求已经计算的 token 数(
num_computed_tokens)追上它的总 token 数;prefill、分块 prefill、decode 只是"差多少"不同,可以出现在同一步里。 - 调大:每步能处理更多的 prefill token,TTFT 降低、吞吐提高,但每一步变慢,正在 decode 的请求 ITL / TPOT 变大、抖动更明显;调小则相反:decode 平稳,长提示词的 TTFT 变长。
- vLLM 从运行队列的队尾(最近调度的、优先级最低的)抢占,释放它的 KV,之后作为等待中的请求重新 prefill(重算);SGLang 在组批时预估未来的需求、保守地接收新请求,显存不够时撤回(retract)部分 decode 请求,把它们放回等待队列。
- 抢占说明显存已经不够了,再接收新请求只会马上又被抢占,来回浪费计算;这一步先让运行中的请求往前走、释放出空间。
先看一个六格小剧场,再读正文:
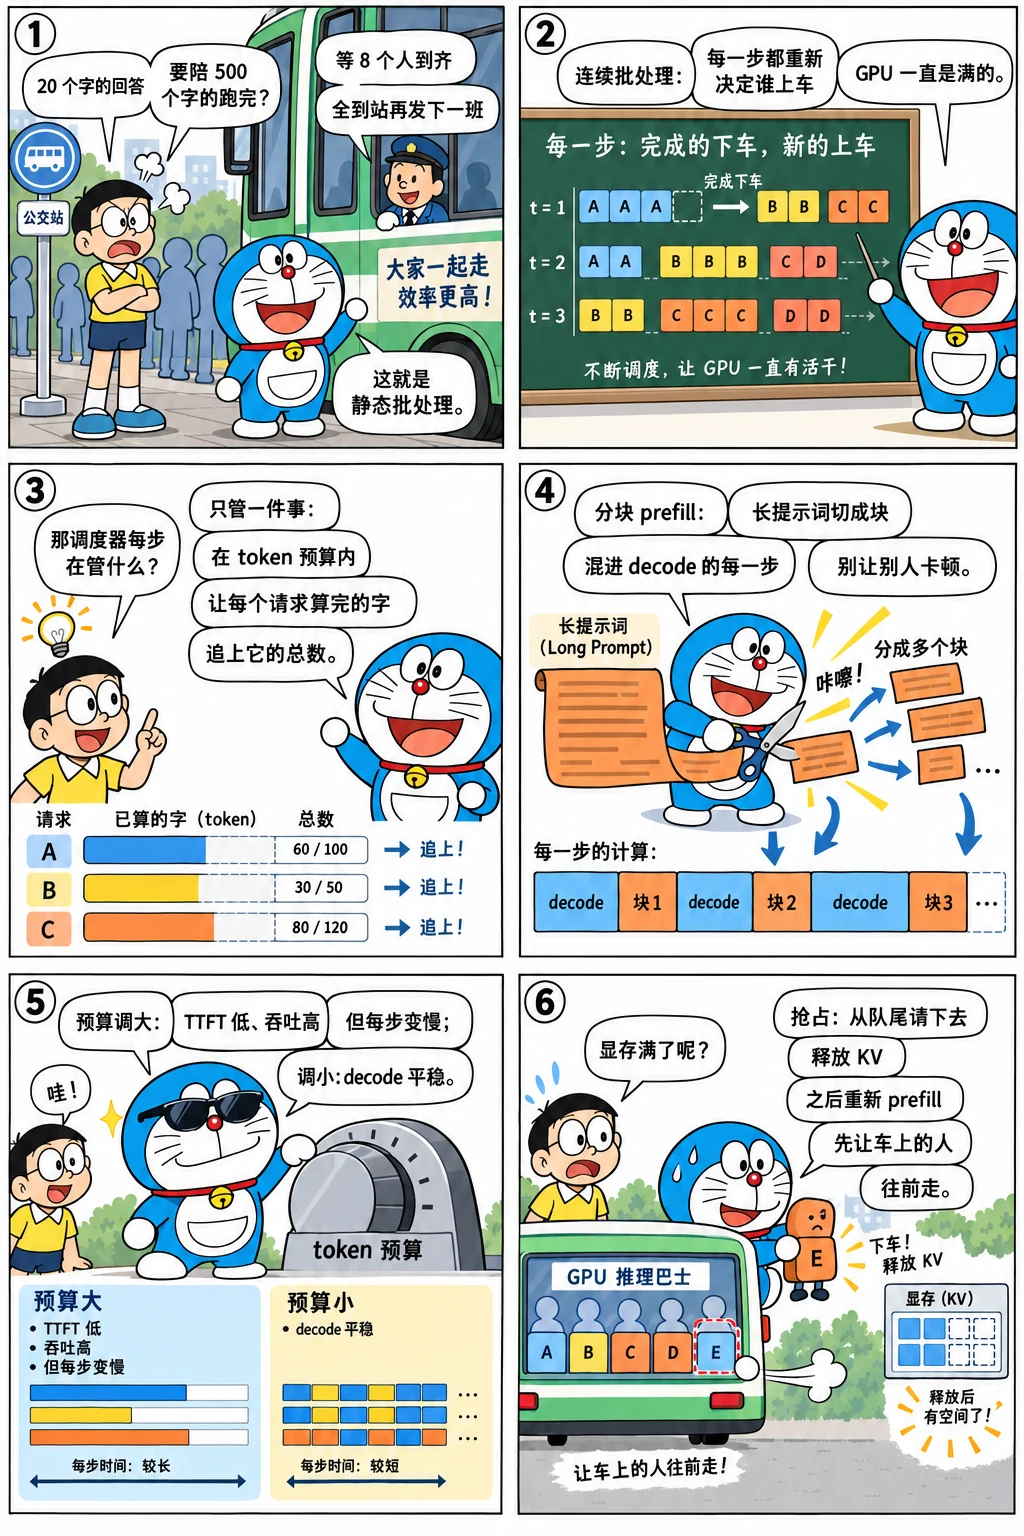
统一的 token 预算
vLLM V1 调度器的核心思想,写在 Scheduler.schedule() 开头的注释里:
调度器里没有"decode 阶段"或"prefill 阶段"。每个请求只有
num_computed_tokens和num_tokens_with_spec两个数。每一步,调度器给请求分配 token,让num_computed_tokens追上num_tokens_with_spec。这足以涵盖分块 prefill、前缀缓存、投机解码,以及将来的"跳跃解码"。
上一章已经说明了为什么可以这样:在一次前向里,prefill、分块 prefill 和 decode 只是"已缓存长度"与"本步长度"的不同组合。于是调度被统一成一个问题:在 token 预算(max_num_batched_tokens)内,给每个请求分配本步要计算的 token 数。
- 新请求:
num_computed = 0,需要len(prompt)个 token;预算不够就只给一部分,这就是分块 prefill; - 分块 prefill 进行中:继续给剩下的部分;
- decode:
num_tokens - num_computed = 1,给 1 个; - 被抢占后恢复:
num_computed被清零,提示词和已生成的 token 全部重算; - 前缀缓存命中:调度前把
num_computed直接设为命中的长度(下一章); - 投机解码:
num_tokens包含草稿 token,一次给多个。
换着看三种调度方式画出来的时间线,静态批处理为什么不能用、分块 prefill 又救了什么,一眼就清楚:
实现
"""nano_engine.py —— 一个最小但完整的推理引擎:调度器 + 模型执行器 + 采样。

调度思路与 vLLM V1 相同:没有"prefill 阶段"和"decode 阶段"之分,每个请求只记录
num_computed(KV 已在缓存中的 token 数)和 num_tokens(提示词 + 已生成)。每一步,调度器在
token 预算内给请求分配 token,让 num_computed 追上 num_tokens。分块 prefill、decode、抢占后的重算
都是这个规则的特例。
"""

import math
import time
from collections import deque
from dataclasses import dataclass
from enum import Enum

import torch

from paged import BlockPool, PagedKVCache
from runner import ModelRunner, build_batch


@dataclass
class SamplingParams:
    max_tokens: int = 64
    temperature: float = 0.0          # 0 表示贪心
    top_p: float = 1.0
    top_k: int = 0                    # 0 表示不限制
    seed: int | None = None
    stop_token_ids: tuple[int, ...] = ()
    ignore_eos: bool = False


class Status(Enum):
    WAITING = "waiting"
    RUNNING = "running"
    FINISHED = "finished"


class Request:
    def __init__(self, request_id: str, prompt_ids: list[int], params: SamplingParams):
        self.request_id, self.prompt_ids, self.params = request_id, list(prompt_ids), params
        self.output_ids: list[int] = []
        self.num_computed = 0            # 已写入 KV Cache 的 token 数
        self.block_ids: list[int] = []   # 块表
        self.status = Status.WAITING
        self.finish_reason: str | None = None
        self.num_preemptions = 0
        self.num_cached_tokens = 0       # 前缀缓存命中的 token 数
        self.generator = torch.Generator().manual_seed(params.seed) if params.seed is not None else None
        self.arrival_time = time.perf_counter()
        self.token_times: list[float] = []

    @property
    def token_ids(self) -> list[int]:
        return self.prompt_ids + self.output_ids

    @property
    def num_tokens(self) -> int:
        return len(self.prompt_ids) + len(self.output_ids)


@dataclass
class SchedulerOutput:
    scheduled: list[tuple[Request, int]]   # (请求, 本步为它计算的 token 数)
    num_preempted: int


class Scheduler:
    def __init__(self, pool: BlockPool, block_size: int, max_num_batched_tokens: int = 256,
                 max_num_seqs: int = 16, enable_chunked_prefill: bool = True):
        self.pool, self.block_size = pool, block_size
        self.max_num_batched_tokens, self.max_num_seqs = max_num_batched_tokens, max_num_seqs
        self.enable_chunked_prefill = enable_chunked_prefill
        self.waiting: deque[Request] = deque()
        self.running: list[Request] = []

    def add_request(self, req: Request) -> None:
        self.waiting.append(req)

    def has_unfinished(self) -> bool:
        return bool(self.waiting or self.running)

    def schedule(self) -> SchedulerOutput:
        budget = self.max_num_batched_tokens
        scheduled: list[tuple[Request, int]] = []
        num_preempted = 0

        # 1. 先调度正在运行的请求(decode 或未完成的分块 prefill),按到达顺序
        i = 0
        while i < len(self.running) and budget > 0:
            req = self.running[i]
            n = min(req.num_tokens - req.num_computed, budget)
            while not self._allocate(req, req.num_computed + n):
                victim = self.running.pop()            # 显存不够:抢占优先级最低(最后到达)的请求
                self._preempt(victim)
                num_preempted += 1
                if victim is req:
                    break
            else:
                scheduled.append((req, n))
                budget -= n
                i += 1
                continue
            break                                      # 当前请求自己被抢占了,本轮不再调度运行队列

        # 2. 再从等待队列取新请求(本步发生过抢占就不接新请求,避免抖动)
        while self.waiting and budget > 0 and not num_preempted and len(self.running) < self.max_num_seqs:
            req = self.waiting[0]
            self._lookup_prefix_cache(req)
            n = req.num_tokens - req.num_computed
            if not self.enable_chunked_prefill and n > budget:
                self._release_prefix_hit(req)
                break
            n = min(n, budget)
            if not self._allocate(req, req.num_computed + n):
                self._release_prefix_hit(req)
                break
            self.waiting.popleft()
            req.status = Status.RUNNING
            self.running.append(req)
            scheduled.append((req, n))
            budget -= n
        return SchedulerOutput(scheduled, num_preempted)

    def _allocate(self, req: Request, num_tokens: int) -> bool:
        """保证请求的块表能容纳 num_tokens 个 token。"""
        need = math.ceil(num_tokens / self.block_size) - len(req.block_ids)
        if need <= 0:
            return True
        blocks = self.pool.allocate(need)
        if blocks is None:
            return False
        req.block_ids += blocks
        return True

    def _preempt(self, req: Request) -> None:
        """重算式抢占:释放全部块,回到等待队列最前面;下次调度时从头计算(提示词 + 已生成的 token)。"""
        self.pool.free(req.block_ids)
        req.block_ids, req.num_computed = [], 0
        req.status = Status.WAITING
        req.num_preemptions += 1
        self.waiting.appendleft(req)

    def _lookup_prefix_cache(self, req: Request) -> None:
        if getattr(self.pool, "enable_caching", False) and req.num_computed == 0:
            # 至少留最后一个 token 不命中:必须真正算一次前向,才能得到下一个 token 的 logits
            hit = self.pool.lookup(req.token_ids[: req.num_tokens - 1])
            self.pool.touch(hit)
            req.block_ids = hit
            req.num_computed = req.num_cached_tokens = len(hit) * self.block_size

    def _release_prefix_hit(self, req: Request) -> None:
        if req.block_ids:
            self.pool.free(req.block_ids)
            req.block_ids, req.num_computed, req.num_cached_tokens = [], 0, 0

    def finish(self, req: Request, reason: str) -> None:
        req.status, req.finish_reason = Status.FINISHED, reason
        self.running.remove(req)
        self.pool.free(req.block_ids)
        req.block_ids = []


def greedy_sample(logits: torch.Tensor, reqs: list[Request]) -> list[int]:
    return logits.argmax(-1).tolist()


class LLMEngine:
    def __init__(self, model, eos_token_id: int | None = None, num_blocks: int = 256, block_size: int = 16,
                 max_num_batched_tokens: int = 256, max_num_seqs: int = 16, enable_chunked_prefill: bool = True,
                 pool: BlockPool | None = None, sample_fn=greedy_sample):
        cfg = model.cfg
        self.block_size, self.eos_token_id, self.sample_fn = block_size, eos_token_id, sample_fn
        self.pool = pool if pool is not None else BlockPool(num_blocks)
        self.kv = PagedKVCache(cfg.num_hidden_layers, self.pool.num_blocks, block_size, cfg.num_key_value_heads, cfg.hd)
        self.runner = ModelRunner(model, self.kv)
        self.scheduler = Scheduler(self.pool, block_size, max_num_batched_tokens, max_num_seqs, enable_chunked_prefill)
        self.step_log: list[dict] = []
        self._next_id = 0

    def add_request(self, prompt_ids: list[int], params: SamplingParams | None = None) -> Request:
        req = Request(str(self._next_id), prompt_ids, params or SamplingParams())
        self._next_id += 1
        self.scheduler.add_request(req)
        return req

    def step(self) -> list[Request]:
        """调度 → 构造批次 → 前向 → 采样 → 更新状态。返回本步产生了新 token 的请求。"""
        out = self.scheduler.schedule()
        if not out.scheduled:
            return []
        items, sampled = [], []
        for req, n in out.scheduled:
            need_logits = req.num_computed + n == req.num_tokens   # 算到了最后一个 token,才需要采样
            items.append((req.token_ids[req.num_computed:req.num_computed + n], req.num_computed, req.block_ids,
                          need_logits))
            if need_logits:
                sampled.append(req)
        logits = self.runner.forward(build_batch(items, self.block_size))
        next_tokens = self.sample_fn(logits, sampled) if sampled else []

        for req, n in out.scheduled:
            req.num_computed += n
            if hasattr(self.pool, "cache_blocks"):
                self.pool.cache_blocks(req.token_ids, req.block_ids, req.num_computed)
        now = time.perf_counter()
        for req, tok in zip(sampled, next_tokens):
            req.output_ids.append(tok)
            req.token_times.append(now)
            p = req.params
            if (tok == self.eos_token_id and not p.ignore_eos) or tok in p.stop_token_ids:
                self.scheduler.finish(req, "stop")
            elif len(req.output_ids) >= p.max_tokens:
                self.scheduler.finish(req, "length")
        self.step_log.append({"num_tokens": sum(n for _, n in out.scheduled), "num_reqs": len(out.scheduled),
                              "num_prefill_tokens": sum(n for r, n in out.scheduled if n > 1),
                              "num_preempted": out.num_preempted, "free_blocks": self.pool.num_free(),
                              "waiting": len(self.scheduler.waiting)})
        return sampled

    def generate(self, prompts: list[list[int]], params=None) -> list[list[int]]:
        """params 可以是一个 SamplingParams(所有请求共用),也可以是每个请求一个的列表。"""
        if not isinstance(params, list):
            params = [params] * len(prompts)
        reqs = [self.add_request(p, sp) for p, sp in zip(prompts, params)]
        while self.scheduler.has_unfinished():
            self.step()
        return [r.output_ids for r in reqs]
schedule() 分两轮:
- 先调度运行中的请求(按到达顺序)。它们已经占有 KV Cache,优先让它们继续,避免已经投入的计算被浪费。给请求分配 token 之前,先确保它的块表能容纳新 token;分配不到块,就从运行队列末尾(最晚到达、优先级最低)抢占一个请求,释放它的块,直到分配成功,或者被抢占的恰好是当前请求自己。
- 再从等待队列接收新请求,直到预算用完、达到并发上限
max_num_seqs,或者分配不到块。如果本步发生过抢占,就不接收新请求:显存已经紧张,再接收新请求只会导致下一步继续抢占,造成抖动。
step() 则是引擎主循环的一次迭代:调度 → 构造批次 → 前向 → 采样 → 更新状态、检查停止条件。只有"算到了最后一个 token"的请求需要采样,分块 prefill 的中间段只写 KV Cache。
验证:怎样调度,结果都一样
用 6 个聊天请求,分别在三种配置下运行:默认参数、很小的 token 预算(强制分块 prefill)、很少的 KV 块(强制抢占)。每种配置的输出都与 mini_llm.generate 逐个请求单独生成的结果比较:
import time
import torch
from transformers import AutoTokenizer
from mini_llm import Transformer, generate
from nano_engine import LLMEngine, SamplingParams

torch.set_num_threads(16)
path = "models/Qwen3-0.6B"
tok = AutoTokenizer.from_pretrained(path)
model = Transformer.from_pretrained(path)

def chat(q):
    return tok(tok.apply_chat_template([{"role": "user", "content": q}], tokenize=False,
                                       add_generation_prompt=True, enable_thinking=False)).input_ids

prompts = [chat(q) for q in ["什么是 KV Cache?", "用一句话解释连续批处理。", "Python 的 GIL 是什么?",
                             "写一个关于月亮的比喻。", "Explain tensor parallelism in one sentence.", "1+1 等于几?请直接回答。"]]
t0 = time.perf_counter()
reference = [generate(model, torch.tensor([p]), 24, eos_token_id=tok.eos_token_id)[0].tolist() for p in prompts]
print(f"逐个单独生成:{time.perf_counter() - t0:.1f} s")

configs = {"默认": {}, "预算 32 个 token": {"max_num_batched_tokens": 32},
           "只有 10 个 KV 块": {"max_num_batched_tokens": 64, "num_blocks": 10}}
for name, kw in configs.items():
    engine = LLMEngine(model, eos_token_id=tok.eos_token_id, **kw)
    t0 = time.perf_counter()
    outputs = engine.generate(prompts, SamplingParams(max_tokens=24))
    preempted = sum(s["num_preempted"] for s in engine.step_log)
    print(f"{name:12s} {len(engine.step_log):3d} 步,抢占 {preempted} 次,{time.perf_counter() - t0:.1f} s,"
          f"与单独生成一致:{outputs == reference}")
    assert outputs == reference
逐个单独生成:6.0 s
默认            24 步,抢占 0 次,2.4 s,与单独生成一致:True
预算 32 个 token  27 步,抢占 0 次,2.6 s,与单独生成一致:True
只有 10 个 KV 块  36 步,抢占 2 次,2.9 s,与单独生成一致:True
三种配置下输出都完全一致,而批处理让总时间缩短了一半以上。这是"调度只影响性能,不影响结果"的直接证明(在浮点误差不改变 argmax 的前提下,参见大模型手册哪些优化会改变输出)。
调度轨迹
看看 token 预算为 32 时前几步发生了什么:
engine = LLMEngine(model, eos_token_id=tok.eos_token_id, max_num_batched_tokens=32)
engine.generate(prompts, SamplingParams(max_tokens=24))
print("步  token 数  请求数  其中 prefill token  等待队列")
for i, s in enumerate(engine.step_log[:6]):
    print(f"{i:2d}  {s['num_tokens']:6d}  {s['num_reqs']:6d}  {s['num_prefill_tokens']:12d}  {s['waiting']:8d}")
步  token 数  请求数  其中 prefill token  等待队列
 0      32       2            32         4
 1      32       4            31         2
 2      32       5            29         1
 3      31       6            27         0
 4       6       6             0         0
 5       6       6             0         0
每个提示词 16~25 个 token,预算只有 32:第 0 步算完第一个请求的提示词,再用剩下的预算算第二个请求的一部分;之后每一步里,已经开始 decode 的请求各占 1 个 token,剩下的预算用来推进后面请求的 prefill 分块。到第 4 步,6 个请求都进入了 decode,每步只剩 6 个 token。decode 与 prefill 分块在同一步中"搭便车",这正是 Sarathi-Serve 提出的做法。
token 预算的取舍
max_num_batched_tokens 决定了一步最多算多少个 token。它直接影响两个指标:
- 预算大:长提示词一步算完,TTFT 短;但这一步很慢,同批的 decode 请求要等它,出现一次很长的 token 间隔(TPOT 尖峰);
- 预算小:长提示词被切成很多块,每步都不慢,decode 很平稳;但提示词要分很多步才能算完,TTFT 变长,而且每步的矩阵乘法变小,GPU 利用率下降。
实验:4 个短请求正在 decode,这时来了一个 786 token 的长请求。比较不同预算下,短请求的最大 token 间隔和长请求的 TTFT:
short = [chat(q) for q in ["介绍一下杭州。", "介绍一下成都。", "介绍一下西安。", "介绍一下广州。"]]
long_prompt = tok("请总结下面这段文字:" + "推理引擎需要在吞吐和延迟之间做权衡。" * 60).input_ids
for budget in (2048, 256, 64):
    engine = LLMEngine(model, eos_token_id=tok.eos_token_id, max_num_batched_tokens=budget, num_blocks=512)
    shorts = [engine.add_request(p, SamplingParams(max_tokens=40, ignore_eos=True)) for p in short]
    for _ in range(4):
        engine.step()
    long_req = engine.add_request(long_prompt, SamplingParams(max_tokens=8, ignore_eos=True))
    while engine.scheduler.has_unfinished():
        engine.step()
    max_gap = max(max(b - a for a, b in zip(r.token_times, r.token_times[1:])) for r in shorts)
    ttft = long_req.token_times[0] - long_req.arrival_time
    print(f"预算 {budget:5d}:短请求最大 token 间隔 {max_gap * 1000:5.0f} ms,长请求 TTFT {ttft * 1000:5.0f} ms")
预算  2048:短请求最大 token 间隔   747 ms,长请求 TTFT   747 ms
预算   256:短请求最大 token 间隔   413 ms,长请求 TTFT  1200 ms
预算    64:短请求最大 token 间隔   203 ms,长请求 TTFT  2469 ms
预算越小,decode 越平稳,但长请求的 TTFT 越长(这是 CPU 上的数字,趋势与 GPU 相同)。实际部署中这个值通常是几千到上万。vLLM 0.30 的默认值按显卡而定:显存不小于 160 GB 的卡(B200 等)为 16384;H100/H200 在线服务为 8192、离线推理为 16384;其他显卡在线服务为 2048、离线推理为 8192。具体取值需要结合 SLO 压测确定(见压测一章)。
抢占:vLLM 与 SGLang 的两种思路
| vLLM V1 | SGLang | |
|---|---|---|
| 接收新请求 | 只要当前步能分配到块就接收 | 预估未来的显存需求(剩余输出长度 × new_token_ratio),留出余量才接收 |
| 显存不够时 | 抢占运行队列末尾的请求(或优先级最低的),释放全部块,放回等待队列最前面,之后重算 | decode 时发现显存不够,retract_decode 撤回一部分请求,并调高 new_token_ratio,让后续接收更保守 |
| 被抢占的请求 | num_computed_tokens 清零,提示词 + 已生成的内容全部重算;前缀缓存往往能让重算便宜很多 |
同样重算;撤回的 KV 可以进入基数树缓存 |
两种思路各有利弊:vLLM 更激进,平时并发更高,偶尔需要付出抢占的代价;SGLang 更保守,很少撤回请求,但预估偏大时会少接收一些请求。早期的 vLLM 还支持把被抢占请求的 KV 换出到 CPU 内存(swap),V1 中去掉了:重算配合前缀缓存通常更快,实现也简单得多。
源码对照
- vLLM:
Scheduler.schedule()(vllm/v1/core/sched/scheduler.py)的结构与本章的实现一致:先遍历self.running,用kv_cache_manager.allocate_slots分配块,失败时抢占self.running[-1](优先级调度时抢占优先级最低的),_preempt_request把num_computed_tokens置 0 并放回self.waiting最前面;然后只有在not preempted_reqs时才调度等待队列。相关参数:max_num_batched_tokens(token 预算)、max_num_seqs(并发上限)、long_prefill_token_threshold(单个请求一步最多算多少 token)。 - 每步前向之后,
update_from_output把采样结果写回请求、检查停止条件、释放结束请求的块。EngineCore.step()(vllm/v1/engine/core.py)把这些串起来:schedule → execute_model → sample_tokens → update_from_output。 - SGLang:
Scheduler.get_next_batch_to_run(srt/managers/scheduler.py)优先尝试组一个新的 prefill 批次(get_new_batch_prefill,由PrefillAdder按剩余 token 预算接收请求,chunked_prefill_size控制分块),组不出来才让运行批次继续 decode(update_running_batch,显存不够时调用retract_decode)。开启--enable-mixed-chunk后,prefill 分块和 decode 会合并成一个MIXED批次。
怎么讲清楚
讲"连续批处理是怎么实现的"的时候,不要只说"请求结束就退出、新请求随时加入",要讲出三个要点:
- 调度粒度是一次迭代:每步重新决定批次,而不是一个请求从头跑到尾;
- 统一的 token 预算:prefill 与 decode 用同一个预算调度,长提示词被分块,与 decode 混在同一步;
- 显存管理:分页 KV Cache 按需分配,显存不够时抢占并重算。
再补一个取舍(token 预算大小与 TTFT/TPOT 的关系)和一个对比(vLLM 与 SGLang 的抢占策略),就把这件事讲完整了。
练习
1. 优先级调度。 给 Request 加一个 priority 字段(数字越小越优先),修改调度器:等待队列按优先级出队;需要抢占时,抢占运行队列中优先级最低的请求。这会带来什么新问题?
参考思路
等待队列改成按 (priority, arrival_time) 排序的堆;抢占时选 max(running, key=lambda r: (r.priority, r.arrival_time)),这正是 vLLM SchedulingPolicy.PRIORITY 的做法。新问题是饥饿:持续到来的高优先级请求可能让低优先级请求一直得不到调度,甚至反复被抢占、反复重算。常见的缓解办法是"老化":等待时间越长,有效优先级越高。
2. 预算和并发上限。 如果 max_num_seqs = 256,但 max_num_batched_tokens = 128,会发生什么?
参考答案
decode 时每个请求每步需要 1 个 token,预算只够 128 个请求同时 decode,另外 128 个即使已经在运行队列里,这一步也分不到 token,只能轮流前进,TPOT 翻倍。并且新请求的 prefill 几乎挤不进来。所以 max_num_batched_tokens 至少要大于 max_num_seqs,通常要大得多,才能给 prefill 留出空间。
小结
- vLLM V1 的调度器没有阶段之分:在 token 预算内,让每个请求的
num_computed追上num_tokens。 - 先调度运行中的请求,再接收新请求;显存不够时从队尾抢占并重算,发生抢占的那一步不接收新请求。
- 分块 prefill 让 decode 与 prefill 分块同步进行:预算小则 decode 平稳、TTFT 变长,预算大则相反。
- vLLM 激进接收、按需抢占;SGLang 预估未来需求、保守接收、必要时撤回。
本章练习题(1 道)
在浏览器里直接写代码、跑测试;也可以在本地用 python practice/judge.py 判题。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题