长上下文、KV 淘汰与稀疏注意力
上下文从 4K 走到 128K、1M,推理的瓶颈也随之转移:prefill 的注意力计算随长度平方增长,KV Cache 随长度线性增长,decode 每一步都要读完整个 KV。这一章先算清楚长上下文的代价从哪个长度开始变得显著,再在真实模型上做两个实验:StreamingLLM 式的 KV 淘汰(只保留注意力汇聚点和最近的窗口),以及几种稀疏注意力选择策略的误差对比。
自测:能答上来就可以跳过本章
- 上下文多长时,注意力的计算量开始超过线性层?
- 只保留最近 N 个 token 的 KV,为什么效果会崩溃?StreamingLLM 做了什么修正?
- 静态的 KV 淘汰与动态的稀疏注意力(如 DeepSeek 的 DSA)有什么本质区别?
- 推理引擎需要为长上下文做哪些专门的支持?
自测参考答案(先自己答,再展开对照)
- 每层注意力的计算约 \(4 \cdot d \cdot\) 上下文长度,线性层约 \(2 \times\) 参数量;按本章的估算,Qwen2.5-7B 在约 38K、LLaMA-3-70B 在约 54K 时,注意力的计算量追上线性层。
- 模型把大量注意力分给开头的几个 token(注意力汇聚),丢掉它们之后 softmax 的分布被打乱,输出就崩溃了。StreamingLLM 在最近的窗口之外,始终保留开头的几个 token 的 KV,模型就能稳定地处理长输入流(但窗口外的信息仍然丢失)。
- 静态淘汰按某个规则永久丢掉 KV,之后再也用不上;动态稀疏注意力保留全部 KV,每个 query 用一个训练过的轻量打分器挑出要看的一小部分(DSA 每个 query 选 2048 个),不同的 query 可以看不同的 token,信息没有丢失,只是省了计算和带宽。
- 滑动窗口 / 局部与全局混合注意力的 KV 管理、注意力汇聚、稀疏注意力的 kernel 和索引器的缓存、分块 prefill、上下文并行(超长提示词),以及 KV 卸载和容量规划。
先看一个六格小剧场,再读正文:
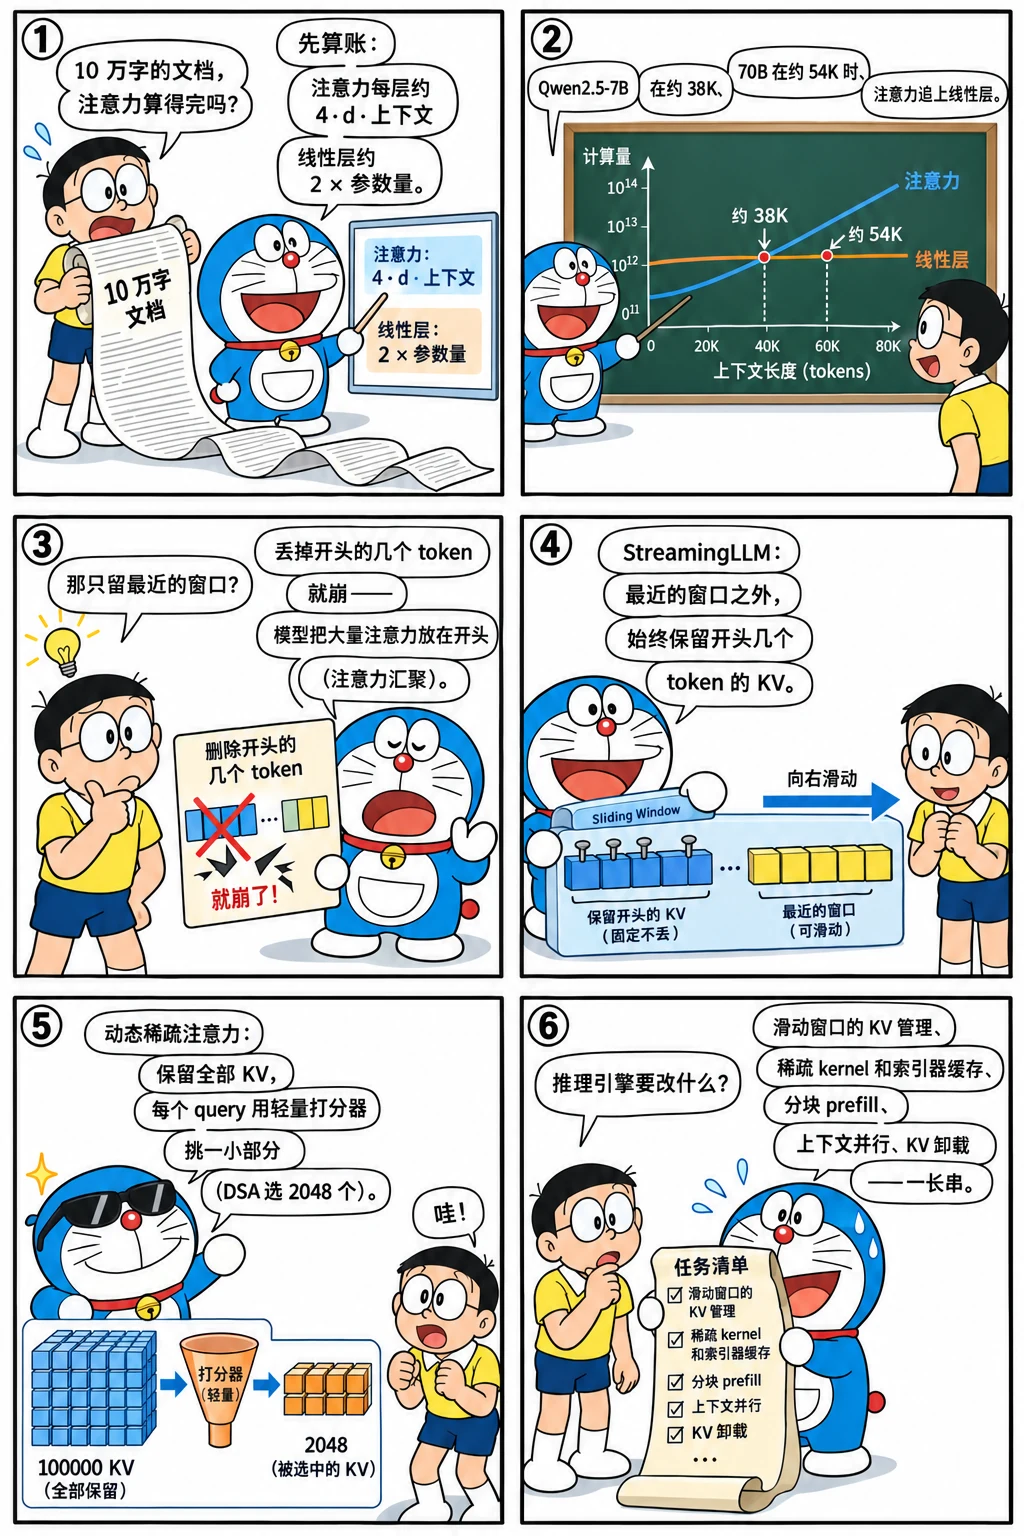
长上下文的代价
每个 token 经过线性层的计算量约为 2 × 参数量,而注意力的计算量与它看到的上下文长度成正比:每层 \(4 \cdot S \cdot n_h \cdot d_h\)(\(QK^\top\) 与 \(PV\) 各一半)。两者相等时:
models = {"Qwen2.5-7B": (7.6e9, 28, 28, 128), "LLaMA-3-70B": (70.6e9, 80, 64, 128)}
for name, (params, layers, heads, head_dim) in models.items():
    crossover = 2 * params / (4 * layers * heads * head_dim)          # 注意力 = 线性层 时的上下文长度
    kv = 2 * layers * {"Qwen2.5-7B": 4, "LLaMA-3-70B": 8}[name] * head_dim * 2
    print(f"{name}:上下文约 {crossover / 1000:.0f}K 时注意力计算量追上线性层;"
          f"128K 上下文的 KV Cache 为 {kv * 131072 / 1e9:.1f} GB")
Qwen2.5-7B:上下文约 38K 时注意力计算量追上线性层;128K 上下文的 KV Cache 为 7.5 GB
LLaMA-3-70B:上下文约 54K 时注意力计算量追上线性层;128K 上下文的 KV Cache 为 42.9 GB
也就是说,几万 token 以内,注意力还不是计算的主体;到了 128K 以上,prefill 的大部分时间都花在注意力上;一个 128K 请求的 KV 就有几 GB 到几十 GB,几个这样的请求加起来就超过了模型权重。decode 时情况更直接:每一步都要读完整个 KV,TPOT 随上下文线性增长。应对方式分三类:
- 让 KV 更少:结构层面(GQA/MLA、滑动窗口与全局注意力混合、线性注意力,见大模型手册的模型巡礼),或者运行时淘汰不重要的 KV;
- 每步只看一部分 KV:稀疏注意力;
- 分摊到更多卡:上下文并行(上一部分)、KV 卸载(分层缓存)。
KV 淘汰:StreamingLLM
最简单的淘汰策略是只保留最近的 N 个 token(滑动窗口)。在一段 1600 token 的文本上,按 64 token 一块依次处理,每块处理完后把 KV 淘汰到 256 个,看困惑度:
import math
import re
import torch
from transformers import AutoTokenizer
from mini_llm import KVCache, Transformer, apply_rope
from tree_spec import forward_with_mask

torch.set_num_threads(16)
path = "models/Qwen3-0.6B"
tok = AutoTokenizer.from_pretrained(path)
model = Transformer.from_pretrained(path)
raw = open("../llm/docs/assets/sample-passage.txt").read()   # 冻结的样本文本:大模型手册「语言模型」一章正文的快照
ids = tok(re.sub(r"[#*`>|\-\[\]()!]", "", raw)).input_ids[:1600]    # 大模型手册中的一章正文
L = model.cfg.num_hidden_layers

def streaming_perplexity(policy, budget=256, sinks=4, chunk=64):
    cache, nll, count = KVCache(L), 0.0, 0
    for start in range(0, len(ids) - 1, chunk):
        piece = ids[start:start + chunk]
        causal = torch.ones(len(piece), len(piece), dtype=torch.bool).tril()
        # 位置用 token 在原文中的真实位置;缓存里的 K 在写入时已经按各自的位置旋转过
        logits, new_kv = forward_with_mask(model, torch.tensor(piece), torch.arange(start, start + len(piece)),
                                           cache, causal)
        target = ids[start + 1:start + len(piece) + 1]
        nll += torch.nn.functional.cross_entropy(logits[:len(target)], torch.tensor(target), reduction="sum").item()
        count += len(target)
        for layer, (k, v) in enumerate(new_kv):
            cache.update(layer, k, v)
        S = cache.k[0].shape[2]
        if policy != "全部保留" and S > budget:
            if policy == "只保留最近 256 个":
                keep = list(range(S - budget, S))
            else:                                                     # 开头的汇聚点 + 最近的窗口
                keep = list(range(sinks)) + list(range(S - (budget - sinks), S))
            for layer in range(L):
                cache.k[layer], cache.v[layer] = cache.k[layer][:, :, keep], cache.v[layer][:, :, keep]
    return math.exp(nll / count)

for policy in ("全部保留", "只保留最近 256 个", "开头 4 个 + 最近窗口"):
    print(f"{policy:14s} 困惑度 {streaming_perplexity(policy):7.2f}")
只保留最近的窗口,困惑度从 27.1 暴涨到 677,模型彻底崩溃;而额外保留开头的 4 个 token,困惑度就回到了 35.8。这正是 StreamingLLM(Xiao 等,2023)的发现:模型会把大量注意力放在最开头的几个 token 上,把它们当作"什么都不看"时的垃圾桶(大模型手册在同一个模型上测到,从第 6 层起有 40%~77% 的注意力落在第一个 token 上,见注意力汇聚)。淘汰掉它们,softmax 的分母突然少了一大块,其余注意力的分布全部被扭曲。保留这几个"汇聚点",就能用固定大小的 KV 处理无限长的输入流。
StreamingLLM 解决的是"不崩溃",而不是"不丢信息":窗口之外的内容仍然被丢掉了,需要回忆远处细节的任务仍会失败。更精细的淘汰策略根据注意力分数决定保留哪些 token:H2O 保留累计注意力最高的"重要 token",SnapKV 在 prefill 结束时根据最后一段 query 的注意力选出每个头要保留的 KV。
把淘汰策略画出来:预算、汇聚 token 的个数怎么决定缓存里留着谁:
稀疏注意力:每一步动态选择
淘汰是永久的:丢掉的 KV 再也回不来。稀疏注意力则保留全部 KV(可以放在显存、甚至卸载到 CPU),但每一步只让 query 与其中一小部分做注意力,而且每个 query 可以选不同的部分。问题变成:怎样又快又准地选出最重要的那部分?
用真实模型第 12 层的 Q、K、V,比较几种"每个 query 只看 256 个 token"的策略与完整注意力的误差(对最后 64 个 query 计算):
LAYER, budget = 12, 256
captured = {}
hook = model.layers[LAYER].self_attn.register_forward_pre_hook(
    lambda mod, args: captured.update(x=args[0], cos=args[1], sin=args[2]))
cache = KVCache(L)
with torch.no_grad():
    model(torch.tensor([ids]), cache)
hook.remove()
attn = model.layers[LAYER].self_attn
with torch.no_grad():
    q = apply_rope(attn.q_norm(attn.q_proj(captured["x"]).view(1, -1, attn.nh, attn.hd).transpose(1, 2)),
                   captured["cos"], captured["sin"])[0]                       # [头, S, D]
rep = attn.nh // attn.nkv
K, V = cache.k[LAYER][0].repeat_interleave(rep, 0), cache.v[LAYER][0].repeat_interleave(rep, 0)
S = K.shape[1]
qpos, kpos = torch.arange(S - 64, S), torch.arange(S)
causal = qpos[:, None] >= kpos[None, :]
scores = (q[:, qpos] @ K.transpose(-1, -2) * attn.hd ** -0.5).masked_fill(~causal, float("-inf"))
full = scores.softmax(-1) @ V

def error_with(selected):
    out = scores.masked_fill(~selected, float("-inf")).softmax(-1) @ V
    return ((out - full).norm() / full.norm()).item()

window = (kpos[None, None] > qpos[:, None] - budget) & causal
sink_window = ((kpos[None, None] > qpos[:, None] - (budget - 4)) | (kpos[None, None] < 4)) & causal
oracle = torch.zeros_like(scores, dtype=torch.bool).scatter_(-1, scores.topk(budget, -1).indices, True) & causal
page = 16                                                              # Quest:按页估计注意力分数的上界
pages = K[:, : S // page * page].view(K.shape[0], S // page, page, -1)
kmin, kmax = pages.amin(2), pages.amax(2)
upper = torch.maximum(q[:, qpos, None, :] * kmin[:, None], q[:, qpos, None, :] * kmax[:, None]).sum(-1)
chosen = torch.zeros_like(upper, dtype=torch.bool).scatter_(-1, upper.topk(budget // page, -1).indices, True)
quest = torch.cat([chosen.repeat_interleave(page, -1),
                   torch.ones(*chosen.shape[:2], S - S // page * page, dtype=torch.bool)], -1) & causal
for name, sel in [("最近 256 个(滑动窗口)", window), ("开头 4 个 + 最近窗口", sink_window),
                  ("按页估计上界选 16 页(Quest)", quest), ("每个 query 精确的 top-256", oracle)]:
    print(f"{name:22s} 相对误差 {error_with(sel):.3f}")
最近 256 个(滑动窗口)         相对误差 0.705
开头 4 个 + 最近窗口          相对误差 0.312
按页估计上界选 16 页(Quest)    相对误差 0.232
每个 query 精确的 top-256   相对误差 0.094
- 静态的窗口策略误差最大,加上汇聚点后大幅改善;
- 每个 query 精确地选出分数最高的 256 个 token,误差只有 9.4%,这是"选对了"能达到的效果,说明注意力确实高度稀疏;
- 但精确选择需要先算出所有分数,等于没省计算。Quest 用每页 key 的最小值、最大值估计分数上界,只需很少的计算,在这里比"汇聚点 + 窗口"好一些,和精确选择还有不小的距离。
真实系统的做法是用一个又快又准的打分器逼近精确选择。DeepSeek-V3.2 的 DSA(DeepSeek Sparse Attention)为每个 token 训练了一个轻量的"闪电索引器"(lightning indexer),用很少的头和 FP8 计算快速给所有历史 token 打分,每个 query 只对得分最高的 2048 个 token 做完整的注意力;NSA(Native Sparse Attention)则把压缩的粗粒度注意力、选择出的细粒度块和滑动窗口三路结合。它们都是在训练时就让模型适应稀疏注意力,而不是推理时事后近似。
推理引擎中的支持
- 滑动窗口与混合注意力:vLLM 的
SlidingWindowManager只保留窗口内的块,窗口外的块及时释放;混合模型的不同层使用不同的 KV 管理器(KV Cache 组,见 vLLM 源码导读); - 注意力汇聚:gpt-oss 这类显式带汇聚项的模型需要注意力后端支持(vLLM 的
SinkFullAttentionManager、SGLang 的相应后端); - 稀疏注意力:DeepSeek-V3.2 的 DSA 需要专门的索引器 kernel、索引器自己的 KV 缓存(vLLM 中的 sparse MLA 后端与
sparse_attn_indexer,SGLang 的nsa_backend.py、dsa_backend.py); - 长提示词的 prefill:分块 prefill 是必需的,否则一个 128K 的请求会让整个服务停顿;更长时用上下文并行;
- 位置编码扩展:超出训练长度时通过 YaRN 等 RoPE 缩放扩展(在模型配置的
rope_scaling中设置),推理引擎需要实现对应的 RoPE 变体。
源码对照
- vLLM:KV 管理器在
vllm/v1/core/single_type_kv_cache_manager.py(SlidingWindowManager、ChunkedLocalAttentionManager、SinkFullAttentionManager等);稀疏注意力相关在vllm/model_executor/layers/sparse_attn_indexer.py、vllm/v1/attention/backends/mla/下的flashmla_sparse.py、flashinfer_mla_sparse.py等 sparse MLA 后端与indexer.py;vllm/v1/hisparse/是面向稀疏注意力的 KV 分层管理。 - SGLang:
srt/layers/attention/nsa_backend.py、dsa_backend.py、dsa/,srt/mem_cache/sparsity/与hisparse_memory_pool.py;滑动窗口相关的swa_memory_pool.py、swa_radix_cache.py。
怎么讲清楚
"如何支持 1M 上下文?"可以按三层讲:模型结构(GQA/MLA、局部与全局注意力混合、线性注意力、原生稀疏注意力)→ 推理系统(分块 prefill、上下文并行、KV 卸载、稀疏注意力的索引与选择)→ 有损近似(KV 淘汰:StreamingLLM 保留汇聚点、H2O/SnapKV 按重要性保留,以及它们的代价)。用本章的实验说明"只保留窗口会崩、保留汇聚点就不会",以及"注意力高度稀疏,但选得准才有用",会很有说服力。
练习
1. 汇聚点保留几个? 把 sinks 从 4 改成 1、16,困惑度会怎样变化?为什么保留 1 个可能就足够了?
参考思路
可以直接修改 streaming_perplexity 的参数运行。多数模型的注意力汇聚集中在第一个 token 上(大模型手册的测量中,第 0 个 token 吸收了大部分汇聚注意力),所以保留 1 个就能恢复大部分效果;保留 4 个更稳妥(StreamingLLM 论文的默认值),多了收益很小,只是挤占了窗口的名额。
2. 为什么不能对所有模型都直接用稀疏注意力? 既然精确的 top-256 误差只有 9.4%,为什么不在推理时对任意模型都用 top-k 稀疏注意力?
参考答案
- 精确的 top-k 需要先算出所有分数,计算量没有减少,只省了 softmax 和 PV 的部分;要真正省计算,必须用近似的打分(Quest、索引器),而近似打分选不准时误差会大得多;
- 误差会逐层、逐 token 累积,单层 9% 左右的误差放到 28 层、上千个 token 上可能造成明显的质量下降,尤其是需要精确检索远处信息的任务("大海捞针");
- 因此 DSA、NSA 都是在训练中引入稀疏注意力,让模型学会在稀疏条件下工作,而不是推理时事后替换。
小结
- 注意力的计算量在几万 token 时追上线性层;几个长上下文请求的 KV 就能超过权重,decode 的 TPOT 随上下文线性增长。
- 只保留最近窗口的 KV 会让模型崩溃;保留开头的注意力汇聚点(StreamingLLM)就能稳定处理长输入流,但窗口外的信息仍然丢失。
- 注意力高度稀疏,精确选择能以很小的误差只看一小部分 KV;实用的稀疏注意力(DSA、NSA)用训练过的轻量打分器逼近精确选择。
- 引擎需要支持滑动窗口/混合注意力的 KV 管理、注意力汇聚、稀疏注意力 kernel、分块 prefill 与上下文并行。
本章练习题(1 道)
在浏览器里直接写代码、跑测试;也可以在本地用 python practice/judge.py 判题。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题