CUDA Graphs 与 torch.compile
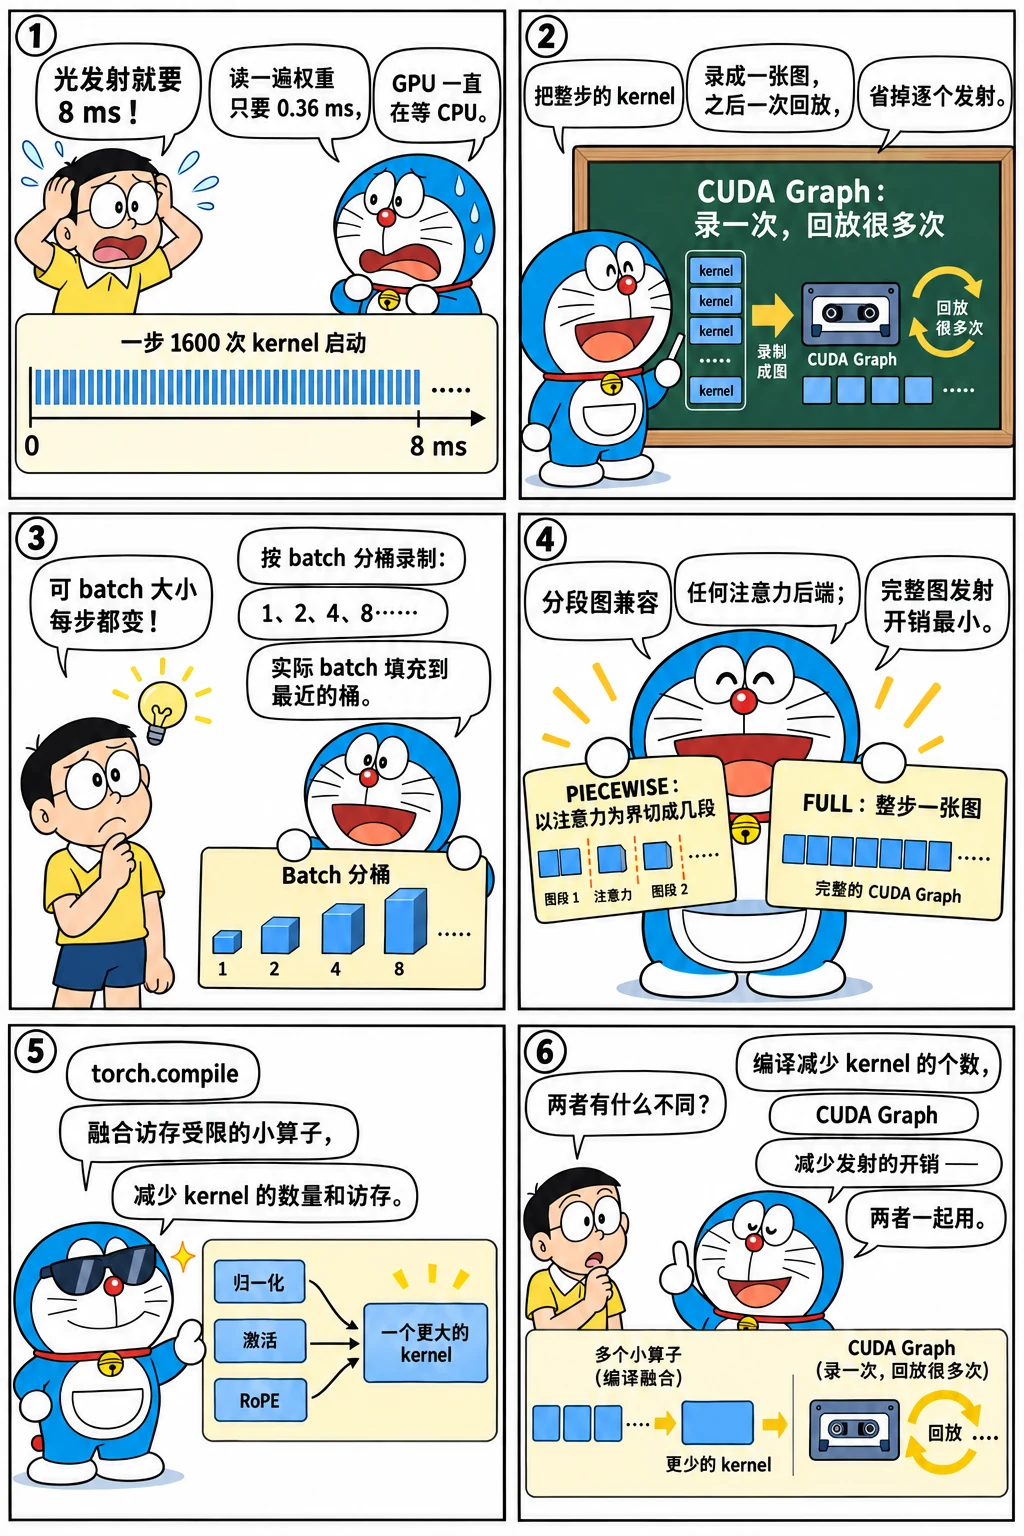
decode 的每一步,GPU 上真正的计算可能只要零点几毫秒,但 CPU 要为它发射上千个 kernel。模型越小、batch 越小,这个开销越显眼,GPU 大部分时间都在等 CPU。推理引擎用两件武器对付它:CUDA Graphs 把一整步前向录制下来、一次提交;torch.compile 把零碎的小算子融合成少数几个 kernel。这一章先量化问题有多严重,再讲清两者的原理、约束,以及 vLLM、SGLang 中的具体做法。
自测:能答上来就可以跳过本章
- 一个 0.6B 模型 decode 一步要发射多少个算子?在 H100 上,发射开销和计算时间哪个大?
- CUDA Graph 为什么要求形状固定、地址固定?引擎怎样让变化的 batch 大小也能用上它?
- vLLM 的
PIECEWISE和FULL两种 CUDA Graph 模式有什么区别?为什么默认是FULL_AND_PIECEWISE? - torch.compile 在推理引擎里主要做什么?它和 CUDA Graphs 是什么关系?
自测参考答案(先自己答,再展开对照)
- 本章的 mini_llm(0.6B)decode 一步有约 2269 个算子调用、约 1600 次 kernel 启动。按每次 5 μs 算发射就要约 8 ms,而 H100 读一遍权重只要约 0.36 ms——发射开销远大于计算,GPU 超过 95% 的时间在等 CPU。
- 图录下的是具体的 kernel、参数和内存地址,重放时原样执行,所以形状和地址都要固定。引擎按一组 batch 大小分别录制(分桶),实际 batch 填充到最近的桶,输入和元数据都拷进录制时用的静态缓冲区。
PIECEWISE:以注意力为界把图切成几段,每段各录一张,注意力在图外正常执行,适用于任何注意力后端和混合批次;FULL:连注意力一起录进一张图,发射开销最小,但要求注意力后端支持。FULL_AND_PIECEWISE对纯 decode 批次用完整图、对 prefill 和混合批次用分段图,兼顾两者。- 融合访存受限的小算子(归一化、激活、RoPE 等),以符号形状编译一次、再为录制的大小特化,并做自定义的融合 pass。它减少的是 kernel 的数量和访存,CUDA Graph 减少的是发射开销,两者配合使用(编译后的代码再录进图里);代价是启动时间和显存。
先看一个六格小剧场,再读正文:
问题有多严重
用 PyTorch 的 profiler 数一数 mini_llm decode 一步调用了多少个算子:
import torch
from collections import Counter
from torch.profiler import ProfilerActivity, profile
from mini_llm import KVCache, Transformer

torch.set_num_threads(16)
model = Transformer.from_pretrained("models/Qwen3-0.6B")
cache = KVCache(model.cfg.num_hidden_layers)
with torch.no_grad():
    model(torch.randint(0, 1000, (1, 64)), cache)                    # 先 prefill 64 个 token
    with profile(activities=[ProfilerActivity.CPU]) as prof:
        model(torch.tensor([[5]]), cache)                             # decode 一步

ops = [e.name for e in prof.events() if e.name.startswith("aten::") and e.cpu_parent is None]
views = {"aten::view", "aten::transpose", "aten::chunk", "aten::reshape", "aten::expand", "aten::slice",
         "aten::unsqueeze", "aten::t", "aten::split", "aten::detach", "aten::alias", "aten::select",
         "aten::to"}                                                  # dtype 不变时 to 什么也不做
compute = [o for o in ops if o not in views]                          # 视图操作不启动 kernel
print(f"decode 一步:{len(ops)} 个算子调用,其中约 {len(compute)} 个需要启动 kernel")
print(Counter(compute).most_common(6))
decode 一步:2269 个算子调用,其中约 1617 个需要启动 kernel
[('aten::mul', 368), ('aten::add', 225), ('aten::linear', 197), ('aten::pow', 114), ('aten::cat', 113), ('aten::mean', 113)]
在 GPU 上,每个 kernel 的启动大约需要几微秒的 CPU 时间(Python 调度 + PyTorch 分发 + CUDA 驱动)。按每个 5 μs 估算,1600 个 kernel 就是 8 ms 左右;而 H100 读一遍 0.6B 模型的 BF16 权重(约 1.2 GB)只要 0.36 ms。GPU 超过 95% 的时间在等 CPU 发射下一个 kernel。即使是 8B 模型(读权重约 4.8 ms),发射开销也与计算时间相当。这就是为什么 decode 阶段几乎离不开 CUDA Graphs。
把这些数字放进一个简单的时间模型,看启动开销占多少、两种手段各省多少:
CUDA Graphs:录一次,放很多次
CUDA Graph 把一段 GPU 操作序列(kernel 启动、内存拷贝)录制成一张图,之后用一次调用就能提交整张图,由 GPU 端直接按顺序执行,省掉了每个 kernel 的 CPU 发射开销:
# 录制:先把输入放进固定的"静态缓冲区",在 graph 的上下文里跑一遍前向
static_input_ids = torch.zeros(batch_size, dtype=torch.long, device="cuda")
static_positions = torch.zeros(batch_size, dtype=torch.long, device="cuda")
graph = torch.cuda.CUDAGraph()
with torch.cuda.graph(graph):
    static_logits = model(static_input_ids, static_positions, attn_metadata)

# 重放:每一步只需把新数据拷进同一块缓冲区,再 replay
static_input_ids.copy_(new_input_ids)
static_positions.copy_(new_positions)
graph.replay()
next_logits = static_logits.clone()
录制下来的是具体的 kernel 和具体的显存地址,所以有三条硬约束:
- 形状固定:录制时 batch 为 8,就只能用于 batch 为 8 的输入;
- 地址固定:输入、输出、中间结果都在录制时分配的那块显存上,每步必须把数据拷进同一个输入缓冲区;
- 图里不能有 CPU 参与的逻辑:不能有依赖 GPU 数据的 Python 分支,不能有
.item()这类 CPU-GPU 同步。
让变化的 batch 用上固定的图
每一步的 batch 大小都不一样,引擎的做法是:预先为一组 batch 大小各录一张图,运行时把实际的 batch 填充到不小于它的最近一个录制大小。vLLM 默认的录制大小是:
>>> import bisect
>>> max_size = 512
>>> sizes = [1, 2, 4] + list(range(8, 256, 8)) + list(range(256, max_size + 1, 16))
>>> len(sizes), sizes[:8], sizes[-3:]
(51, [1, 2, 4, 8, 16, 24, 32, 40], [480, 496, 512])
>>> def padded(n):                       # 填充到最近的录制大小;超过最大值就不用 CUDA Graph
...     i = bisect.bisect_left(sizes, n)
...     return sizes[i] if i < len(sizes) else None
>>> [padded(n) for n in (1, 3, 9, 100, 300, 600)]
[1, 4, 16, 104, 304, None]
小 batch 时录制得密(填充浪费少),大 batch 时录制得疏(录制的图太多会占用显存、拖慢启动)。填充出来的 token 是"假"的,它们的 KV 写到保留的空块(块 0,vLLM 中叫 null_block;SGLang 的 ReqToTokenPool 也专门保留了第 0 行),结果被丢弃。
注意力是难点:分段图与完整图
decode 批次的形状只由 batch 大小决定,但注意力还依赖每步都变的元数据:每个请求的上下文长度、块表。这些元数据也必须放在固定的缓冲区里、由 kernel 从显存读取,而不是作为 Python 参数传进 kernel,注意力 kernel 才能被录进图里。并不是所有注意力后端都支持这一点。于是 vLLM 有两种模式:
| 模式 | 做法 | 适用 |
|---|---|---|
PIECEWISE(分段) |
以注意力为界把计算图切成若干段,每段各录一张图,注意力在图外正常执行 | 任何注意力后端;prefill 与混合批次 |
FULL(完整) |
连同注意力一起录成一张图 | 注意力后端支持固定缓冲区的元数据时(FlashAttention 3、FlashInfer、FlashMLA 的 decode 等) |
FULL_AND_PIECEWISE(V1 默认) |
纯 decode 批次用完整图,prefill 与混合批次用分段图 | 大多数模型性能最好 |
分段图把几千次 kernel 启动减少到"层数 × 2"次左右的图重放加注意力调用,已经省掉了大部分开销;完整图更进一步,一步只需一次重放。
torch.compile:把小算子融合起来
CUDA Graphs 省的是发射开销,但每个 kernel 仍然要各自读写一遍显存。像 RMSNorm、残差相加、SiLU × up、RoPE 这类逐元素或归约的小算子,都是访存受限的:融合成一个 kernel,可以让数据只读写一遍。torch.compile(TorchInductor 后端)自动做这件事:
import re
from torch._inductor.utils import run_and_get_code

def fused_add_rms_norm(x, residual, weight, eps: float = 1e-6):
    residual = x + residual
    var = residual.pow(2).mean(-1, keepdim=True)
    return weight * (residual * torch.rsqrt(var + eps)), residual

x, r, w = torch.randn(16, 1024), torch.randn(16, 1024), torch.randn(1024)
with profile(activities=[ProfilerActivity.CPU]) as prof:
    eager = fused_add_rms_norm(x, r, w)
eager_ops = [e.name for e in prof.events() if e.name.startswith("aten::") and e.cpu_parent is None]
compiled, code = run_and_get_code(torch.compile(fused_add_rms_norm), x, r, w)
kernels = sorted(set(re.findall(r"cpp_fused_\w+", code[0])))
print(f"eager:{len(eager_ops)} 个算子 {eager_ops}")
print(f"compile 之后:{len(kernels)} 个融合 kernel {kernels}")
print("结果一致:", all(torch.allclose(a, b, atol=1e-5) for a, b in zip(eager, compiled)))
eager:7 个算子 ['aten::add', 'aten::pow', 'aten::mean', 'aten::add', 'aten::rsqrt', 'aten::mul', 'aten::mul']
compile 之后:1 个融合 kernel ['cpp_fused_add_mean_mul_pow_rsqrt_0']
结果一致: True
7 个算子被融合成 1 个 kernel(在 CPU 上生成 C++,在 GPU 上生成 Triton)。在 GPU 上,这意味着 residual 只读一遍、写一遍,而不是被 7 个 kernel 反复读写。
torch.compile 也有形状问题。默认它先按具体形状编译;遇到新形状时会重新编译,并尝试把变化的维度当作符号处理:
from torch._dynamo.utils import counters

for dynamic in (False, True):
    torch._dynamo.reset()
    counters.clear()
    f = torch.compile(fused_add_rms_norm, dynamic=dynamic)
    for n in (1, 2, 3, 5, 8, 13):                                 # 6 种不同的 token 数
        f(torch.randn(n, 1024), torch.randn(n, 1024), w)
    print(f"dynamic={dynamic}:6 种形状共编译了 {counters['stats']['unique_graphs']} 次")
dynamic=False 时每种形状都要重新编译一次;dynamic=True 时 token 数成为符号,只编译了两次(大小为 1 的维度会被单独特化,这是 torch.compile 的惯例)。推理引擎每步的 token 数都在变,所以 vLLM 的做法是:以符号化的 token 数编译一次,得到对任意 token 数都适用的通用版本;如果需要,还可以通过 compile_sizes 为指定的大小(例如全部 CUDA Graph 录制大小)额外编译特化版本,或用 compile_ranges_endpoints 按区间编译。编译结果缓存在磁盘上(默认 ~/.cache/vllm/torch_compile_cache),重启时直接加载。
两者的配合与代价
在 vLLM 中,torch.compile 与 CUDA Graphs 是正交的两层:
- torch.compile 捕获模型的计算图,用自定义的 Inductor pass 做融合(RMSNorm + 量化、SiLU × up + 量化、all-reduce + RMSNorm 等),并在注意力处把图切开(分段编译);
- CUDA Graphs 把编译后的每一段(或整步)录制下来重放。
代价主要是启动时间与显存:编译加上为几十种 batch 大小录图,可能需要几十秒到几分钟,录制的图还会占用一些显存。调试时可以用 --enforce-eager(vLLM)或 --disable-cuda-graph(SGLang)关掉,排查"加了 CUDA Graph 结果就不对"这类问题。
源码对照
- vLLM:CUDA Graph 模式由
CompilationConfig.cudagraph_mode(vllm/config/compilation.py)控制,文档字符串详细解释了NONE / PIECEWISE / FULL / FULL_DECODE_ONLY / FULL_AND_PIECEWISE;cudagraph_capture_sizes的默认生成规则就是上面的[1, 2, 4] + range(8, 256, 8) + range(256, max+1, 16),max_cudagraph_capture_size默认最大 512(数据中心级 Blackwell 为 1024)。运行时由vllm/v1/cudagraph_dispatcher.py根据批次类型选择模式和填充大小,录制在GPUModelRunner.capture_model/_capture_cudagraphs。编译相关代码在vllm/compilation/。 - SGLang:
srt/model_executor/runner/下有decode_cuda_graph_runner.py和prefill_cuda_graph_runner.py,runner_backend/下有完整图、基于 torch.compile 的分段图(tc_piecewise_cuda_graph_backend.py)等后端。0.5.20 中 decode 和 prefill 两个阶段分别配置,常用参数有--cuda-graph-max-bs-decode、--cuda-graph-bs-decode、--disable-cuda-graph、--disable-prefill-cuda-graph。
怎么讲清楚
"CUDA Graph 为什么能加速 decode?有什么限制?"——先用数字说明问题:decode 一步上千次 kernel 启动,每次几微秒,而 GPU 计算只要零点几到几毫秒,发射开销占大头;CUDA Graph 把整步录下来一次提交,消除了这部分开销。然后说限制:形状和地址固定(所以要按 batch 大小分桶录制、填充、用静态缓冲区),图里不能有 CPU 同步和依赖数据的分支,注意力元数据要放在固定缓冲区里(所以有 piecewise 和 full 两种模式)。最后提代价:启动时间和显存。
练习
1. 填充的代价。 按 vLLM 的默认录制大小,batch 为 257 时要填充到多少?浪费了多少比例的计算?为什么大 batch 时录制得稀疏一些也可以接受?
参考答案
257 被填充到 272,浪费 15 / 272 ≈ 5.5%。大 batch 时 decode 更接近计算受限,每步时间较长,CPU 发射开销占比本来就小,即使不用 CUDA Graph 损失也不大;而 batch 很小时发射开销占比最高,最需要精确的录制大小。另外每张图都占显存、增加启动时间,录制的大小不能无限多。
2. 为什么结果会变? 有人发现,开启 CUDA Graph 后,同一个请求的贪心输出和关闭时不一样。可能的原因有哪些?
参考思路
- 填充改变了 batch 大小,矩阵乘法可能选择不同的 kernel 或切分方式,浮点累加顺序不同,logits 有微小差异,遇到接近平局的 token 时 argmax 翻转(参见大模型手册的哪些优化会改变输出);
- torch.compile 的融合改变了计算顺序;
- 真正的 bug:图里读到了过期的缓冲区(某个输入没有拷进静态缓冲区)、填充的请求的 KV 写进了真实请求的块等。
前两种是正常的数值差异,用 logits 误差阈值判断;第三种需要对比开关 CUDA Graph 时每一层的输出来定位。
小结
- decode 一步上千次 kernel 启动,每次几微秒,发射开销常常比 GPU 计算还长。
- CUDA Graph 录制一步前向、一次提交;要求形状和地址固定,所以按 batch 大小分桶录制、填充、使用静态缓冲区。
- 注意力元数据每步都变,vLLM 用分段图(注意力在图外)和完整图(注意力在图内)两种模式,默认对 decode 用完整图、对混合批次用分段图。
- torch.compile 融合访存受限的小算子,以符号形状编译一次、为录制大小特化;与 CUDA Graphs 配合使用,代价是启动时间和显存。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题