RDMA 编程模型:verbs、单边操作与内存注册
PD 分离的 KV 传输、跨机的专家并行、分布式 KV 缓存,底层都是 RDMA:网卡直接读写远端机器(甚至远端 GPU)的内存,不经过对方的 CPU 和内核。NCCL 把这些细节封装了起来,但 KV 传输引擎、DeepEP 这类系统是直接在 RDMA 之上写的。这一章讲 RDMA 的编程模型——内存注册、队列对、单边与双边操作、完成通知——用一个语义模拟器把 KV 推送的流程走一遍,再用一个开销模型说明为什么"请求要合并"。
自测:能答上来就可以跳过本章
- RDMA 为什么比 TCP 快?"内核旁路"和"零拷贝"分别指什么?
- 内存注册做了什么?为什么 KV 池要在启动时一次性注册?
- 单边 WRITE 和双边 SEND / RECV 有什么区别?接收方怎么知道数据写完了?
- PD 分离中,KV 是 prefill 推(WRITE)还是 decode 拉(READ)?各有什么考虑?
- 为什么传输很多个小块时,带宽跑不满?
自测参考答案(先自己答,再展开对照)
- 内核旁路:应用程序直接和网卡交互,数据收发不经过操作系统内核(没有系统调用和上下文切换);零拷贝:网卡直接从应用程序的内存读写,不需要在内核缓冲区和用户内存之间拷贝。再加上协议处理由网卡硬件完成,延迟低、带宽高、几乎不占 CPU。
- 把一段内存锁定在物理内存里(不会被换出),在网卡里建立虚拟地址到物理地址的映射,并生成访问密钥(
lkey/rkey)。注册很慢(要锁页、写网卡的页表),所以 KV 池这种大块内存要在启动时一次性注册,而不是每次传输时临时注册。 - 单边 WRITE:发起方直接写对端的内存,对端 CPU 完全不参与、也不知道;双边 SEND / RECV:接收方要事先提交接收缓冲区,数据到达时它会收到完成事件。接收方知道写完了的办法:最后一个写带立即数(WRITE_WITH_IMM),在对端产生一个完成事件;或者另发一条消息。
- 本书的做法是推:decode 实例预分配好块并告知地址,prefill 实例算完一层就用单边 WRITE 写过去,能和计算重叠。拉(READ)则由 decode 实例在准备好之后主动读,节奏由 decode 控制,但要等 prefill 端的数据准备好、还要多一次通知。
- 网卡每秒能处理的消息数(消息速率)有上限,每个消息还有固定的处理开销;块很小时,受限于消息速率而不是带宽。办法:合并连续的块、调整布局让同一层的数据连续、批量提交、多个 QP 和多张网卡并行。
先看一个六格小剧场,再读正文:
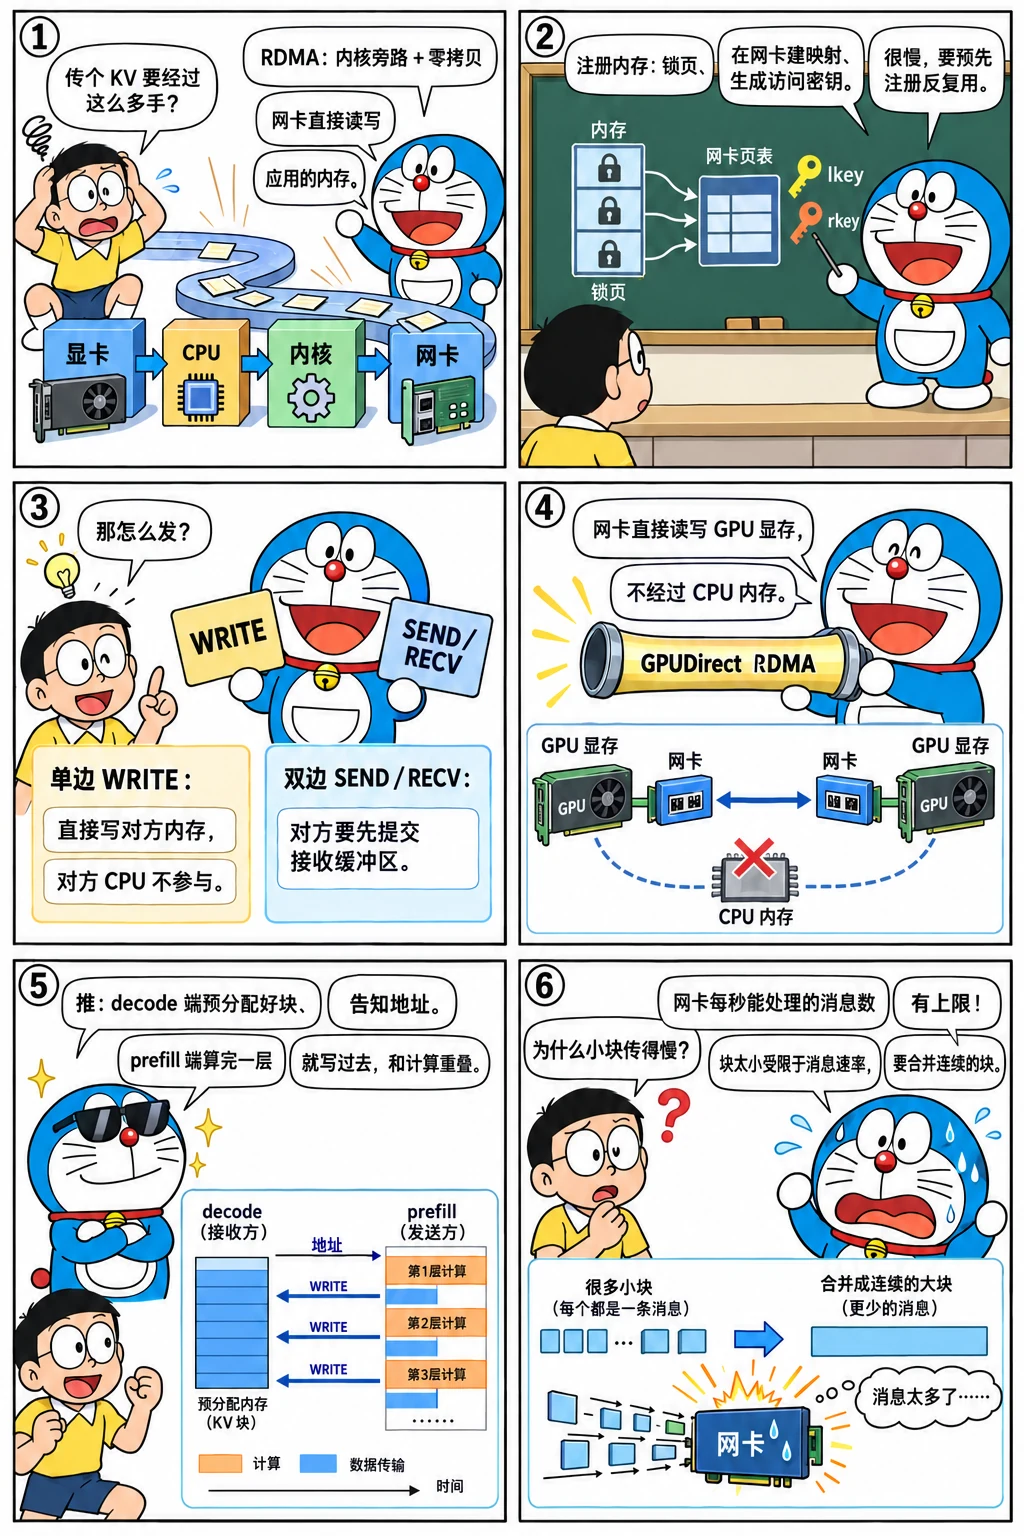
为什么是 RDMA
用 TCP 发数据,要经过发送方内核的协议栈、把数据从用户缓冲区拷到内核缓冲区、网卡中断接收方 CPU、再拷回用户缓冲区——每一步都消耗 CPU、增加延迟。RDMA 去掉了这些:
- 内核旁路:用户态程序直接把请求写进网卡的队列(通过内存映射的"门铃"寄存器),不需要系统调用;
- 零拷贝:网卡直接从用户的内存读数据、直接写进对端用户的内存,中间没有内核缓冲区;
- CPU 卸载:可靠传输、重传、分包都在网卡硬件里完成。单边操作(READ / WRITE)甚至完全不需要对端 CPU 参与。
加上 GPUDirect RDMA,"用户的内存"可以是显存:网卡直接从一台机器的 GPU 读、写进另一台机器的 GPU。
verbs 编程模型
RDMA 的编程接口叫 verbs(libibverbs),核心对象:
| 对象 | 作用 |
|---|---|
| PD(保护域) | 把下面几种资源归到一组,只有同一个 PD 里的 QP 能访问同一个 PD 里注册的内存 |
| MR(内存区域) | ibv_reg_mr 注册一段内存:固定物理页(不能被换出)、让网卡建立地址翻译表,返回本地密钥 lkey 和远程密钥 rkey |
| QP(队列对) | 一个发送队列 + 一个接收队列,相当于一条"连接"。常用类型是 RC(可靠连接,一对一、保证顺序和送达) |
| CQ(完成队列) | 请求完成后,网卡往这里写一条完成记录(CQE),程序轮询它 |
| WR(工作请求) | 程序往 QP 里提交的一个操作:SEND、RECV、WRITE、READ、原子操作 |
建立连接需要一次带外交换:两边通过普通的 TCP、HTTP 或者 etcd 这样的元数据服务,交换 QP 编号、网卡地址(LID / GID),以及要访问的内存的地址和 rkey,然后把 QP 的状态依次切换到 INIT → RTR(可以接收)→ RTS(可以发送)。推理框架里所谓的 "bootstrap 服务"做的就是这件事。
操作分两类:
- 双边:SEND / RECV。接收方必须事先提交 RECV 请求、准备好缓冲区;数据到达后接收方收到一条完成记录。适合传控制消息;
- 单边:WRITE / READ。发起方只需要知道对端内存的地址和
rkey,直接读写,对端的 CPU 完全不知道发生了什么。适合大块数据。 - WRITE_WITH_IMM:写数据的同时附带一个 32 位的立即数,对端会收到一条完成记录——这是"单边写 + 通知对方写完了"的标准做法。RC 连接保证同一个 QP 上的操作按顺序生效,所以最后一个写带上立即数,对端收到通知时,前面的数据一定都已经到了。
用模拟器走一遍 KV 推送
下面的模拟器只模拟语义(注册、单边写、完成队列、密钥检查),不模拟网络。场景是 PD 分离:decode 实例启动时把整个 KV 池注册一次;请求到来时它分配好块,把地址和 rkey 通过带外通道告诉 prefill 实例;prefill 算完后用单边写把 KV 直接写进这些块,最后一个写带上立即数通知 decode:
import itertools


class RemoteAccessError(Exception):
    pass


class Nic:
    """一张网卡的替身:只模拟 RDMA 的语义(注册内存、单边写、完成队列),不模拟网络"""
    _keys = itertools.count(0x1000)

    def __init__(self, name):
        self.name, self.mrs, self.cq = name, {}, []

    def reg_mr(self, buf):
        """注册内存:固定物理页、让网卡能直接访问,返回 (起始地址, rkey);这里用 rkey 当"地址空间"的编号"""
        rkey = next(self._keys)
        self.mrs[rkey] = buf
        return 0, rkey

    def post_write(self, peer, data, remote_addr, rkey, imm=None, signaled=False):
        """单边写:直接写进对端已注册的内存,对端 CPU 不参与;imm 不为空时对端收到一条完成通知"""
        buf = peer.mrs.get(rkey)
        if buf is None or remote_addr + len(data) > len(buf):
            raise RemoteAccessError(f"{peer.name} 拒绝访问:rkey={rkey:#x},地址 {remote_addr}+{len(data)}")
        buf[remote_addr:remote_addr + len(data)] = data
        if imm is not None:
            peer.cq.append(("RECV_RDMA_WITH_IMM", imm))
        if signaled:
            self.cq.append(("RDMA_WRITE", len(data)))

    def poll_cq(self):
        done, self.cq = self.cq, []
        return done


BLOCK = 8                                        # 每个 KV 块 8 字节(示意)
decode, prefill = Nic("decode"), Nic("prefill")
pool = bytearray(BLOCK * 6)                      # decode 实例的 KV 池:启动时整块注册一次
addr, rkey = decode.reg_mr(pool)

# 带外握手(bootstrap):decode 为请求分配第 4、1、5 号块,把地址和 rkey 告诉 prefill
blocks = [4, 1, 5]
kv = [bytes([65 + i]) * BLOCK for i in range(len(blocks))]      # prefill 算出的 3 块 KV:b"AAAAAAAA"、b"BBBB..."、...
for i, (b, data) in enumerate(zip(blocks, kv)):
    last = i == len(blocks) - 1
    prefill.post_write(decode, data, addr + b * BLOCK, rkey, imm=7 if last else None, signaled=last)

print("decode 的完成队列:", decode.poll_cq())             # 只有最后一次带立即数的写产生通知
print("prefill 的完成队列:", prefill.poll_cq())           # 只对最后一个请求要了完成事件(selective signaling)
print("decode 的 KV 池:", bytes(pool).decode().replace("\x00", "."))
for bad in [(rkey + 1, 0), (rkey, BLOCK * 6)]:
    try:
        prefill.post_write(decode, b"x" * BLOCK, bad[1], bad[0])
    except RemoteAccessError as e:
        print("出错:", e)
decode 的完成队列: [('RECV_RDMA_WITH_IMM', 7)]
prefill 的完成队列: [('RDMA_WRITE', 8)]
decode 的 KV 池: ........BBBBBBBB................AAAAAAAACCCCCCCC
出错: decode 拒绝访问:rkey=0x1001,地址 0+8
出错: decode 拒绝访问:rkey=0x1000,地址 48+8
几个值得注意的地方:
- decode 的 CPU 只在最后收到一条通知,三次写入对它都是"透明"的;
- prefill 只对最后一个写请求要了完成事件(selective signaling):每个请求都产生完成记录会增加网卡和 CPU 的开销,同一个 QP 上后面的完成意味着前面的也完成了;
- 写越界或
rkey不对,网卡会直接拒绝(真实的错误码是IBV_WC_REM_ACCESS_ERR,而且出错后 QP 会进入错误状态,需要重建连接)。rkey就是远端内存的"访问凭证",泄露它等于允许对方任意读写这段内存; - 真实系统里,"写完了"的通知也可以不用立即数,而是再写一个标志位让对端轮询,或者用双边 SEND 发一条控制消息。
推还是拉? 上面是 prefill 推(WRITE)。也可以让 decode 拉(READ):prefill 算完后把 KV 的地址告诉 decode,decode 自己读。推的好处是 prefill 可以逐层写出去,和后面层的计算重叠,写完就能释放 KV;拉的好处是 decode 可以按自己的节奏和内存余量决定什么时候取。两种做法都有人用:SGLang 的 PD 传输是 decode 先分配好块、由 prefill 推;vLLM 的 NIXL connector 默认是拉——prefill 算完后把块号交给 decode,由 decode 发起 READ(NixlPullConnector),0.30 版本又加入了由 prefill 用 WRITE 推送的 NixlPushConnector。
内存注册的代价
ibv_reg_mr 要把每一页固定在物理内存里,并让网卡建立虚拟地址到物理地址的翻译表,注册几十 GB 的内存可能要几百毫秒到几秒;注册过的内存越多,网卡的翻译表缓存越容易不命中。所以:
- 启动时一次性注册整个 KV 池、整块权重缓冲区,而不是每个请求注册一次;
- 显存的注册要通过 GPUDirect RDMA 的驱动(
nvidia-peermem或 dma-buf); - 用大页(2 MB / 1 GB)减少翻译表项;
- 这也意味着 KV 池的大小和位置在启动后最好固定——动态扩缩容的 KV 池要么预留、要么付出重新注册的代价。
请求数与消息速率
网卡除了带宽上限,还有消息速率上限:每个工作请求都有固定的处理开销,程序提交请求(写 WQE、敲门铃)也要时间。KV 是按页存放的,页很小的时候,传输就变成了海量的小请求。估算一个 4K 提示词的 KV(70B、TP=8,每卡要传 160 MiB)在不同组织方式下要多少条请求:
LAYERS, PROMPT, HEAD_BYTES = 80, 4096, 128 * 2   # 70B:80 层;4K 提示词;TP=8 时每卡 1 个 KV 头,一个 token 的 K 是 256 字节
BW, PER_WR = 50e9, 0.1e-6                        # 一张 400G 网卡;每条 WR 的发起开销(单线程、单 QP 的量级,示意)
total = LAYERS * PROMPT * 2 * HEAD_BYTES         # K 和 V
print(f"一个 4K 提示词每卡要传 {total / 2**20:.0f} MiB,纯带宽时间 {total / BW * 1e3:.1f} ms")

plans = [                                        # (页大小, 每条 WR 覆盖几页, K 和 V 是否一起传)
    ("页大小 1,每层每 token 的 K、V 各一条", 1, 1, False),
    ("页大小 16,每层每页的 K、V 各一条", 16, 1, False),
    ("页大小 16,K、V 相邻存放,每层每页一条", 16, 1, True),
    ("页大小 16,合并地址连续的 8 页", 16, 8, True),
    ("每层一条(两边的页都连续)", PROMPT, 1, True),
]
for name, page, merge, kv_together in plans:
    n_wr = LAYERS * (PROMPT // (page * merge)) * (1 if kv_together else 2)
    t = max(total / BW, n_wr * PER_WR)           # 带宽和发起速率,谁慢谁决定时间
    print(f"{name}:{n_wr} 条 WR,每条 {total / n_wr / 1024:g} KiB,约 {t * 1e3:.1f} ms")
一个 4K 提示词每卡要传 160 MiB,纯带宽时间 3.4 ms
页大小 1,每层每 token 的 K、V 各一条:655360 条 WR,每条 0.25 KiB,约 65.5 ms
页大小 16,每层每页的 K、V 各一条:40960 条 WR,每条 4 KiB,约 4.1 ms
页大小 16,K、V 相邻存放,每层每页一条:20480 条 WR,每条 8 KiB,约 3.4 ms
页大小 16,合并地址连续的 8 页:2560 条 WR,每条 64 KiB,约 3.4 ms
每层一条(两边的页都连续):80 条 WR,每条 2048 KiB,约 3.4 ms
页大小为 1(按 token 管理 KV;SGLang 不指定 --page-size 时就是 1,部分注意力后端会改成 64 等)时,如果逐 token 传输,请求数是带宽时间的 20 倍——这时瓶颈根本不在网络带宽。常见的对策:
- 合并连续的块:源和目标地址都连续的一段合并成一个请求。decode 分配 KV 时尽量给连续的块,收益会很明显;SGLang 的 PD 传输会先把源和目标都连续的片段合并起来(
disaggregation/common/utils.py的group_concurrent_contiguous); - 调整布局:K 和 V 相邻存放、同一层的多个页相邻存放,都能减少请求数;有的系统专门为传输准备一块"层优先、请求连续"的中转缓冲区,在 GPU 上先整理、再一次发出;
- 批量提交:一次提交一串请求、只敲一次门铃(
ibv_post_send接受请求链表);只对最后一个请求要完成事件; - 多个 QP、多张网卡并行:一张网卡、一个 QP 的消息速率有限,传输引擎会把请求分散到多个 QP 和机器上的多张网卡(按 GPU 与网卡的拓扑就近选择)。
模型里每条请求 0.1 µs 的开销只是示意;真实的消息速率取决于网卡型号、QP 数量、提交线程数,要在自己的机器上用 ib_write_bw、ib_write_lat(perftest 工具集)测出来。
GPU 自己发起 RDMA
上面的流程里,发起 RDMA 的是 CPU:GPU 算完 KV,CPU 再提交写请求。这对 PD 传输足够了,但对 MoE 的 all-to-all 这类"每层都要、数据量小、延迟敏感"的通信,CPU 参与会成为瓶颈——GPU 要先同步回 CPU,CPU 再去操作网卡。
IBGDA(InfiniBand GPUDirect Async)让 GPU 线程直接构造工作请求、直接敲网卡的门铃,整个通信在 GPU kernel 内部完成,CPU 完全不参与。NVSHMEM 用它实现"在 kernel 里调用 put / get",DeepEP 的低延迟模式就建立在这之上——这是下一章的内容。
怎么讲清楚
讲到 RDMA,先讲三个关键词:内核旁路、零拷贝、单边操作;再讲编程模型:注册内存得到 rkey、建立 QP、带外交换地址和密钥、提交 WRITE / READ、轮询完成队列;最后落到推理场景:KV 池启动时一次性注册、decode 预分配块后由 prefill 逐层推送、最后一个写带立即数通知、小块要合并以避开消息速率瓶颈、多网卡按拓扑并行。能讲出"页大小为 1 时逐 token 传输会被消息速率卡住"这类量化判断,比背概念有说服力得多。
练习
1. 为什么"最后一个写带立即数"就够了? 如果 prefill 用两个不同的 QP 并行写 KV(为了用满两张网卡),这个做法还成立吗?
参考答案
RC 类型的 QP 保证同一个 QP 上的写操作按提交顺序在对端生效,所以最后一个写的通知到达时,同一个 QP 上之前的写都已完成。跨 QP 没有顺序保证:QP1 上的通知到了,QP2 上的数据可能还在路上。多 QP 时要么每个 QP 各发一个通知、接收方等齐所有通知(计数),要么在所有 QP 的写都完成后(发送方看到各自的完成事件)再单独发一条通知。
2. 页大小的取舍。 既然页越大传输越高效,为什么推理引擎不把页设得很大(比如 256 个 token)?
参考答案
页大小影响的不只是传输:页越大,内部碎片越多(每个请求最后一页平均浪费半页),前缀缓存的共享粒度越粗(只能以整页为单位共享前缀),分页注意力的 kernel 也要适配。SGLang 默认页大小为 1 就是为了 token 级的前缀共享(Radix Cache)。所以更常见的做法是保持小页,在传输时合并连续块、或者在 GPU 上整理到中转缓冲区再发送;也有系统为 PD 分离单独选用较大的页。
小结
- RDMA 靠内核旁路、零拷贝和硬件卸载获得低延迟、高带宽;单边 READ / WRITE 不需要对端 CPU 参与。
- verbs 的核心对象:PD、MR(
lkey/rkey)、QP(常用 RC)、CQ、WR;建连要带外交换 QP 信息、地址和密钥。 - KV 推送:decode 预分配并告知地址,prefill 逐层单边写,最后一个写带立即数通知;同一个 QP 内有序,跨 QP 要另行同步。
- 内存注册很贵,KV 池和缓冲区要启动时一次性注册;显存注册要通过 GPUDirect RDMA 驱动。
- 小块多时瓶颈是消息速率而不是带宽:合并连续块、调整布局、批量提交、多 QP 多网卡并行。
- IBGDA 让 GPU 直接发起 RDMA,是 NVSHMEM 和 DeepEP 低延迟模式的基础。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题