多模态推理
视觉语言模型(VLM)在语言模型前面接了一个视觉编码器:图片先被切成小块、编码成一串"图像 token",再与文字 token 拼在一起交给语言模型。对推理系统来说,这带来了新的成本与新的问题:一张图变成多少个 token、视觉编码器要算多久、图像 token 的位置怎么编码、同一张图出现多次时能否复用。这一章在真实的 Qwen3.5-0.8B(原生多模态:同一个模型既读文字也看图)上逐一测量,再讨论推理引擎中的对应设计。
自测:能答上来就可以跳过本章
- 一张 1280×720 的图片在 Qwen3.5 中会变成多少个 token?分辨率翻倍呢?
- 视觉编码器的计算在一次请求的 prefill 中占多大比例?
- M-RoPE 是什么?一张 196 个 token 的图片会让后续文字的位置前进多少?
- 什么是 encoder cache?为什么多模态请求的前缀缓存需要特殊处理?
自测参考答案(先自己答,再展开对照)
- Qwen3.5 用 16×16 的 patch、2×2 合并,每个图像 token 约对应 32×32 个像素:1280×720 的高取整成 704,得到 44×80 个 patch,合并后 880 个 token。分辨率翻倍,token 数变成约 4 倍。
- 视觉编码器参数不多,却要占 prefill 时间的三分之一到一半(图像 token 多、编码器要处理全部 patch);它只在 prefill 运行一次。
- 多模态 RoPE:用时间、高、宽三个位置分量编码图像 token(文字 token 三个分量相同,退化成普通的 RoPE)。一张 14×14、196 个 token 的图片,只让后续文字的位置前进 14(从图像里最大的位置加一继续),而不是 196。
- encoder cache 缓存视觉编码器的输出,同一张图片(多轮对话、分块 prefill)不用重新编码。前缀缓存要把图片内容的哈希纳入键:图片在 token 序列里只是一串相同的占位 token,不同的图片会得到相同的 token 序列,只看 token 就会命中别的图片的 KV。
先看一个六格小剧场,再读正文:
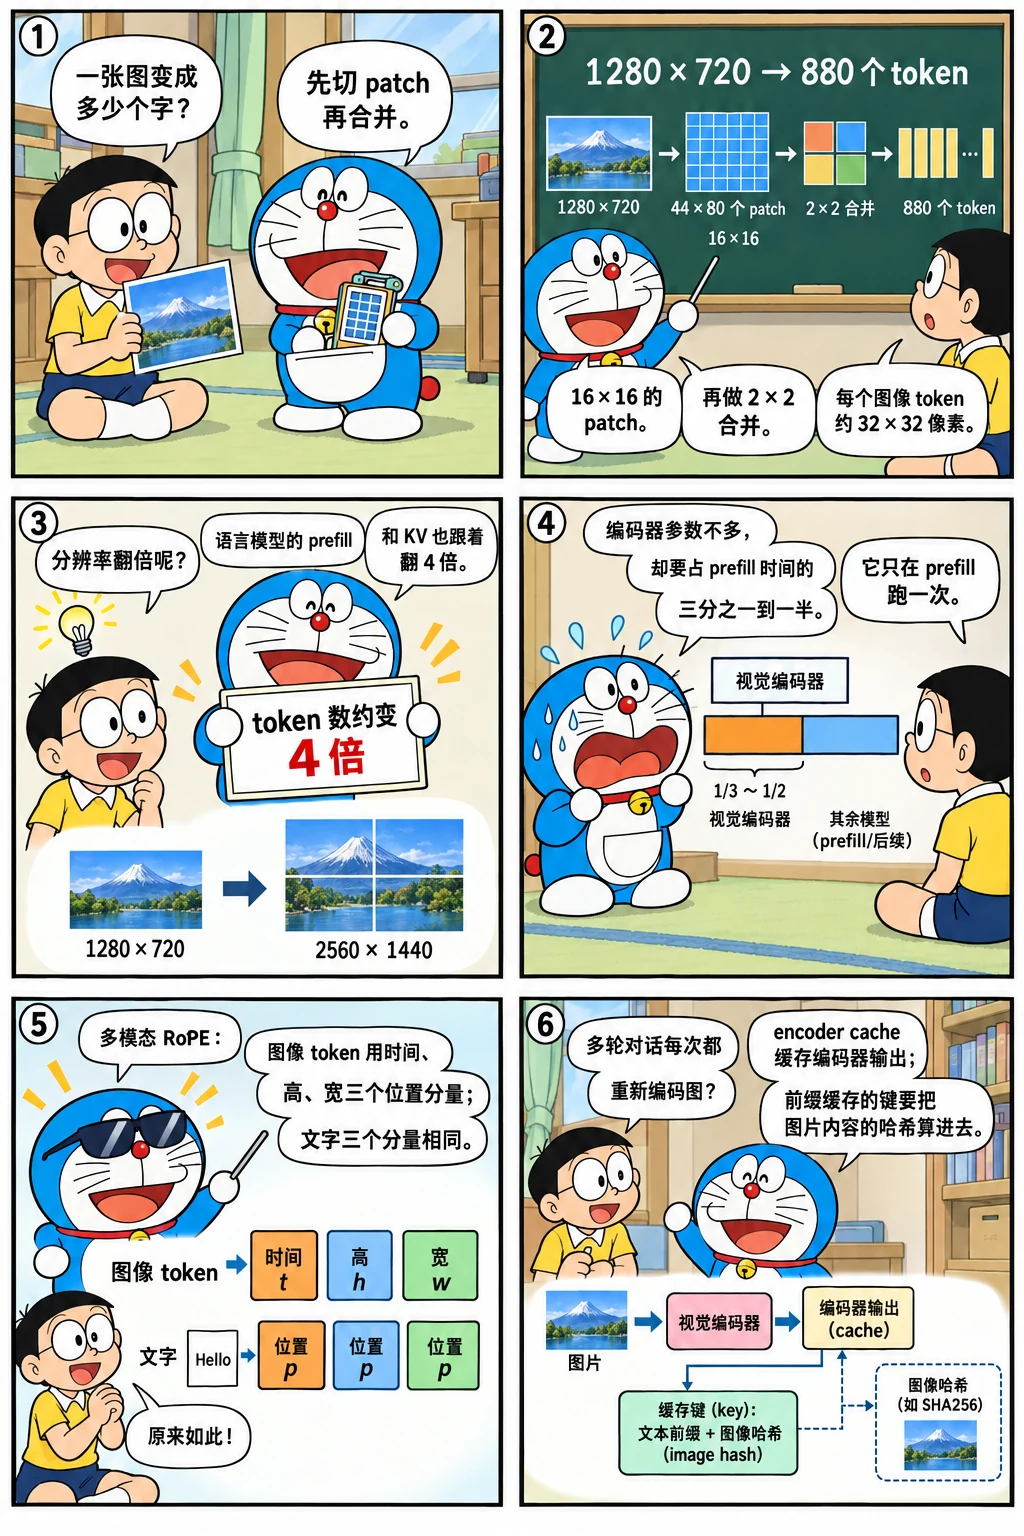
一张图变成多少个 token
Qwen3.5 的视觉编码器(与 Qwen3-VL 同一种结构)是一个 12 层的 ViT:图片按 16×16 像素切成小块(patch),编码之后,相邻的 2×2 个 patch 再合并成一个 token 交给语言模型。所以图像 token 数约等于 像素数 / (32 × 32),并且会随分辨率动态变化(不再把所有图片缩放到固定大小):长宽先取整到 32 的倍数,像素总数再限制在一个范围内,太小的图会被放大(至少 65536 个像素,约 256×256):
import hashlib
import time
import torch
from PIL import Image, ImageDraw, ImageFont
from transformers import AutoModelForImageTextToText, AutoProcessor

torch.set_num_threads(16)
path = "models/Qwen3.5-0.8B"
processor = AutoProcessor.from_pretrained(path)
image_pad = processor.tokenizer.convert_tokens_to_ids("<|image_pad|>")
for w, h in [(224, 224), (448, 448), (896, 896), (1280, 720)]:
    out = processor(text=["<|vision_start|><|image_pad|><|vision_end|>"], images=[Image.new("RGB", (w, h), "white")],
                    return_tensors="pt")
    t, gh, gw = out["image_grid_thw"][0].tolist()
    n_tokens = (out["input_ids"] == image_pad).sum().item()
    print(f"{w:4d}×{h:<4d}:{gh}×{gw} 个 patch → 合并后 {n_tokens:4d} 个图像 token")
 224×224 :16×16 个 patch → 合并后   64 个图像 token
 448×448 :28×28 个 patch → 合并后  196 个图像 token
 896×896 :56×56 个 patch → 合并后  784 个图像 token
1280×720 :44×80 个 patch → 合并后  880 个图像 token
224×224 的图被放大到了 256×256(低于像素下限),1280×720 的高被取整成 704。分辨率翻倍,token 数变成 4 倍。一张高清截图可以轻松产生上千个 token,比大部分文字提示词还长;视频是很多帧,更多。图像 token 在语言模型里与文字 token 一样占用 prefill 计算和 KV Cache,所以控制图像分辨率(max_pixels 等参数)是多模态服务最直接的成本旋钮。
换分辨率,看 patch 数、token 数和编码器的计算量:
视觉编码器要算多久
加载完整的模型,画一张带文字和图形的图片,提问,并分别计时:只跑视觉编码器、完整的 prefill(视觉编码 + 语言模型处理所有 token)、以及生成回答:
model = AutoModelForImageTextToText.from_pretrained(path, dtype=torch.float32).eval()
vision_params = sum(p.numel() for p in model.model.visual.parameters())
print(f"参数量:视觉编码器 {vision_params / 1e6:.0f}M,总计 {sum(p.numel() for p in model.parameters()) / 1e6:.0f}M")

image = Image.new("RGB", (448, 448), "white")
draw = ImageDraw.Draw(image)
draw.text((40, 40), "Prefill", fill="black", font=ImageFont.load_default(size=48))
draw.text((40, 120), "Decode", fill="black", font=ImageFont.load_default(size=48))
draw.ellipse([150, 250, 300, 400], fill="red")

def build(question):
    messages = [{"role": "user", "content": [{"type": "image"}, {"type": "text", "text": question}]}]
    text = processor.apply_chat_template(messages, tokenize=False, add_generation_prompt=True, enable_thinking=False)
    return processor(text=[text], images=[image], return_tensors="pt")

inputs = build("图片里写了哪两个英文单词?下面画的是什么形状、什么颜色?")
with torch.no_grad():
    t0 = time.perf_counter()
    model.model.get_image_features(inputs["pixel_values"], inputs["image_grid_thw"])
    vision_s = time.perf_counter() - t0
    t0 = time.perf_counter()
    model(**inputs)
    prefill_s = time.perf_counter() - t0
    generated = model.generate(**inputs, max_new_tokens=30, do_sample=False)
n_image = (inputs["input_ids"] == image_pad).sum().item()
print(f"输入 {inputs['input_ids'].shape[1]} 个 token(其中图像 {n_image} 个)")
print(f"视觉编码 {vision_s:.2f} s,完整 prefill {prefill_s:.2f} s:视觉编码约占 {vision_s / prefill_s:.0%}")
print("回答:", processor.batch_decode(generated[:, inputs["input_ids"].shape[1]:], skip_special_tokens=True)[0])
参数量:视觉编码器 101M,总计 853M
输入 226 个 token(其中图像 196 个)
视觉编码 0.22 s,完整 prefill 0.63 s:视觉编码约占 35%
回答: 图片里写了“Prefill”和“Decode”两个英文单词。下面画的是一个红色的圆形。
模型正确读出了文字、识别了图形(这是一个 0.8B 的小模型,字写得太大或太花哨时它也会读错)。视觉编码器只有约 1 亿参数(语言部分约 7.5 亿),却占了 prefill 时间的三分之一左右:它要对每个 patch(合并之前,是图像 token 数的 4 倍)做完整的 Transformer 计算,12 层都是全注意力。视觉编码器更大的模型比例更高,例如 Qwen2.5-VL-3B 的视觉编码器约 6.7 亿参数,同样的测量里占到 prefill 的一半左右。这部分计算只在 prefill 发生一次,decode 阶段完全不涉及视觉编码器。
图像 token 的位置:M-RoPE
文字 token 的位置是一维的;图像 token 有高和宽两个方向,视频还有时间方向。Qwen 的多模态模型从 Qwen2-VL 起使用 M-RoPE(多维 RoPE):每个 token 有(时间、高、宽)三个位置分量,RoPE 的频率分成三组,分别用这三个分量旋转。Qwen2-VL、Qwen2.5-VL 按频率从高到低切成连续的三段;Qwen3-VL 和 Qwen3.5 改成交错分配(时间、高、宽轮流占用一个频率),让每个方向都覆盖从高到低的全部频段,Qwen3.5 的 config 里是 mrope_interleaved: true、mrope_section: [11, 11, 10](它只对每个头的前 64 维做旋转,共 32 个频率)。先看三个分量是怎么算的:
position_ids, _ = model.model.get_rope_index(inputs["input_ids"], inputs["mm_token_type_ids"],
                                             image_grid_thw=inputs["image_grid_thw"])
ids = inputs["input_ids"][0]
first, last = (ids == image_pad).nonzero()[0].item(), (ids == image_pad).nonzero()[-1].item()
show = lambda a, b: [tuple(position_ids[:, 0, i].tolist()) for i in range(a, b)]
print("图像之前的文字 (时间, 高, 宽):", show(first - 2, first))
row = inputs["image_grid_thw"][0, 2].item() // 2                      # 合并之后每行的 token 数
print("图像的前 3 个 token:", show(first, first + 3), " 第二行开头:", show(first + row, first + row + 1))
print("图像的最后一个 token:", show(last, last + 1), " 图像之后的文字:", show(last + 1, last + 3))
图像之前的文字 (时间, 高, 宽): [(2, 2, 2), (3, 3, 3)]
图像的前 3 个 token: [(4, 4, 4), (4, 4, 5), (4, 4, 6)]  第二行开头: [(4, 5, 4)]
图像的最后一个 token: [(4, 17, 17)]  图像之后的文字: [(18, 18, 18), (19, 19, 19)]
文字 token 的三个位置分量相同(退化为普通的一维 RoPE);图像 token 的时间分量固定为图像的起始位置,高、宽分量是起始位置加上它在 14×14 网格中的行号、列号;图像之后的文字从"图像中最大的位置 + 1"继续。于是一张 196 个 token 的图片,只让后续文字的位置前进了 14,而不是 196。对推理引擎来说,这意味着位置不能再用 token 的序号直接得到,需要按这套规则计算三维位置,并在 decode 时正确地延续(vLLM、SGLang 中都有专门的 M-RoPE 位置计算)。
复用:encoder cache 与前缀缓存
多轮对话中,同一张图片会在每一轮的请求里重复出现。视觉编码的结果只取决于图片本身,可以按图片内容的哈希缓存起来,这就是 encoder cache。给模型的 get_image_features 套一层缓存,同一张图问两个不同的问题:
cache = {}
original = model.model.get_image_features
def cached_image_features(pixel_values, image_grid_thw=None, **kwargs):
    key = hashlib.sha256(pixel_values.numpy().tobytes()).hexdigest()   # 按图片内容做键
    if key not in cache:
        cache[key] = original(pixel_values, image_grid_thw, **kwargs)
    return cache[key]
model.model.get_image_features = cached_image_features

with torch.no_grad():
    for question in ["描述这张图。", "图中的圆是什么颜色?"]:
        batch = build(question)
        t0 = time.perf_counter()
        model(**batch)
        print(f"{question}  prefill {time.perf_counter() - t0:.2f} s(缓存中的图片数:{len(cache)})")
第二次请求跳过了视觉编码,prefill 时间少了三分之一以上,正是视觉编码所占的那一部分。前缀缓存同样适用于多模态请求,但要注意:图像 token 在输入序列中都是同一个占位符 <|image_pad|>,两张不同的图片会产生完全相同的 token 序列。如果只按 token 做哈希,就会把一张图的 KV 错误地用在另一张图上。所以推理引擎在计算块哈希时要把图片的内容哈希作为额外的键(vLLM 的 extra_keys 中包含多模态输入的哈希,见前缀缓存)。
推理引擎中的设计
- 调度:视觉编码也要算力,vLLM 的调度器单独维护一个编码器的计算预算(
max_num_encoder_input_tokens)和 encoder cache(EncoderCacheManager),在调度 prefill 时决定哪些图片本步需要编码(见 vLLM 源码导读中_try_schedule_encoder_inputs); - 分块 prefill 与图片:一张图的图像 token 最好在同一个分块里处理完,否则编码结果要跨步保存;
- EPD 分离:更进一步,把视觉编码(Encode)也拆成独立的实例,与 prefill、decode 分开部署和扩缩容(vLLM 的 EC connector、SGLang 的
disaggregation/encoder都在做这件事); - 预处理:图片解码、缩放、切 patch 是 CPU 上的工作,高并发时可能成为瓶颈,需要多进程或 GPU 预处理;
- CUDA Graph:视觉编码器的输入形状随图片分辨率变化,通常不录制,或者按分辨率分桶录制。
源码对照
- vLLM:多模态的输入处理在
vllm/multimodal/;调度器中的 encoder 预算与EncoderCacheManager(vllm/v1/core/encoder_cache_manager.py);worker 侧的mm_encoder_model_runner.py;EPD 分离的vllm/distributed/ec_transfer/;块哈希的多模态额外键在kv_cache_utils.py的_gen_mm_extra_hash_keys。 - SGLang:
srt/multimodal/(各模型的处理器)、srt/managers/mm_utils.py(图像嵌入的缓存与拼接)、srt/mem_cache/multimodal_cache.py,以及srt/disaggregation/encoder/。
怎么讲清楚
"多模态推理和纯文本推理有什么不同?":token 数(动态分辨率,token 数随像素线性增长,是最大的成本旋钮)→ 视觉编码(只在 prefill,但可能占 prefill 的一半;encoder cache 复用;EPD 分离)→ 位置编码(M-RoPE,位置不再等于序号)→ 缓存正确性(图像占位符相同,前缀缓存的哈希必须包含图片内容)→ 预处理(CPU 瓶颈)。能用本章的数字(1280×720 约 900 个 token,视觉编码占 prefill 的三分之一到一半)说明量级,会很有说服力。
练习
1. 限制分辨率。 一个服务收到的图片大多是手机截图(1170×2532)。按 Qwen3.5 的规则大约会产生多少个图像 token?如果把 max_pixels 限制为 1280×32×32,会变成多少?代价是什么?
参考答案
1170 × 2532 / (32 × 32) ≈ 2893 个 token(实际会按 32 的倍数取整,略有出入);限制到 1280 × 32 × 32 个像素时,最多约 1280 个 token,prefill 和 KV 成本降到一半以下。代价是图片被缩小,细小的文字可能看不清,OCR 类任务的准确率下降。可以按任务类型设置不同的上限,或者让客户端先裁剪出感兴趣的区域。
2. 为什么 decode 时不需要视觉编码器? 多模态请求的 decode 阶段与纯文本请求有区别吗?
参考答案
视觉信息在 prefill 时已经编码成图像 token,并经过语言模型的每一层,存进了 KV Cache(Qwen3.5 这样的混合模型里,线性注意力层把它们汇总进了固定大小的状态)。decode 时新 token 通过注意力读取这些 KV,就"看到"了图片,不需要再运行视觉编码器。所以 decode 阶段与纯文本几乎没有区别,唯一的不同是位置要按 M-RoPE 的规则延续,以及 KV Cache 更长(包含图像 token)。
小结
- 图像 token 数 ≈ 像素数 / (32×32)(Qwen3.5 / Qwen3-VL:16×16 的 patch、2×2 合并;Qwen2.5-VL 是 28×28),随分辨率动态变化;分辨率是多模态服务的第一成本旋钮。
- 视觉编码器参数不多,却占 prefill 时间的三分之一到一半;它只在 prefill 运行,可以用 encoder cache 复用。
- M-RoPE 用时间、高、宽三维位置编码图像 token(Qwen3-VL、Qwen3.5 把三组频率交错分配),图像之后的文字位置从最大值加一继续。
- 前缀缓存必须把图片内容的哈希纳入键;引擎还需要编码器预算、encoder cache、EPD 分离与预处理优化。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题