专家并行与 DP Attention
DeepSeek-V3 有 256 个路由专家、6710 亿参数,一张卡放不下,张量并行又会被 MLA 和通信拖累。主流的部署方式是:注意力部分做数据并行(每张卡处理不同的请求,DP Attention),MoE 部分做专家并行(每张卡放一部分专家,EP),两者之间用 all-to-all 交换 token。这一章用 4 个进程在 CPU 上实现 EP + DP Attention 的一层 MoE,验证与单进程结果一致;再讨论负载均衡(EPLB)、DeepEP 与计算通信重叠。
自测:能答上来就可以跳过本章
- EP 中一个 MoE 层有哪两次通信?各传什么?
- 为什么 DeepSeek 这类模型的注意力部分用 DP 而不是 TP?
- 专家负载不均衡时会怎样?EPLB 用什么方法缓解?
- DeepEP 的"普通模式"和"低延迟模式"分别用于什么阶段?
- 什么是两批重叠(two-batch overlap)?它隐藏的是什么?
自测参考答案(先自己答,再展开对照)
- dispatch:把每个 token 的隐藏向量发给它选中的专家所在的卡;combine:把专家的输出送回 token 原来所在的卡,按门控权重加权求和。两次都是 all-to-all。
- DeepSeek 用 MLA,所有头共享一份潜向量 KV,TP 按头切分切不开它,每张卡都要存完整的一份,KV 容量不随卡数增加。DP Attention 让各卡处理不同的请求,每张卡只存自己请求的 KV,再和 MoE 层的 EP 组合。
- 负载最重的卡决定每一层的时间,其他卡空等;热门专家所在的卡还可能放不下那么多 token。EPLB 根据统计的专家负载,复制热门专家(冗余专家)并重新摆放专家的位置,让各卡的负载均衡。
- 普通模式(高吞吐):按节点去重、两跳转发,需要一次 CPU 同步,用于训练和 prefill;低延迟模式:直发目标卡、固定槽位,可以录进 CUDA Graph,用于 decode。
- 把一个 batch 拆成两个 micro-batch,一个在做注意力和专家计算时,另一个的 dispatch / combine 在网络上传输,两者交替进行。它隐藏的是 EP 的 all-to-all 通信时间。
先看一个六格小剧场,再读正文:
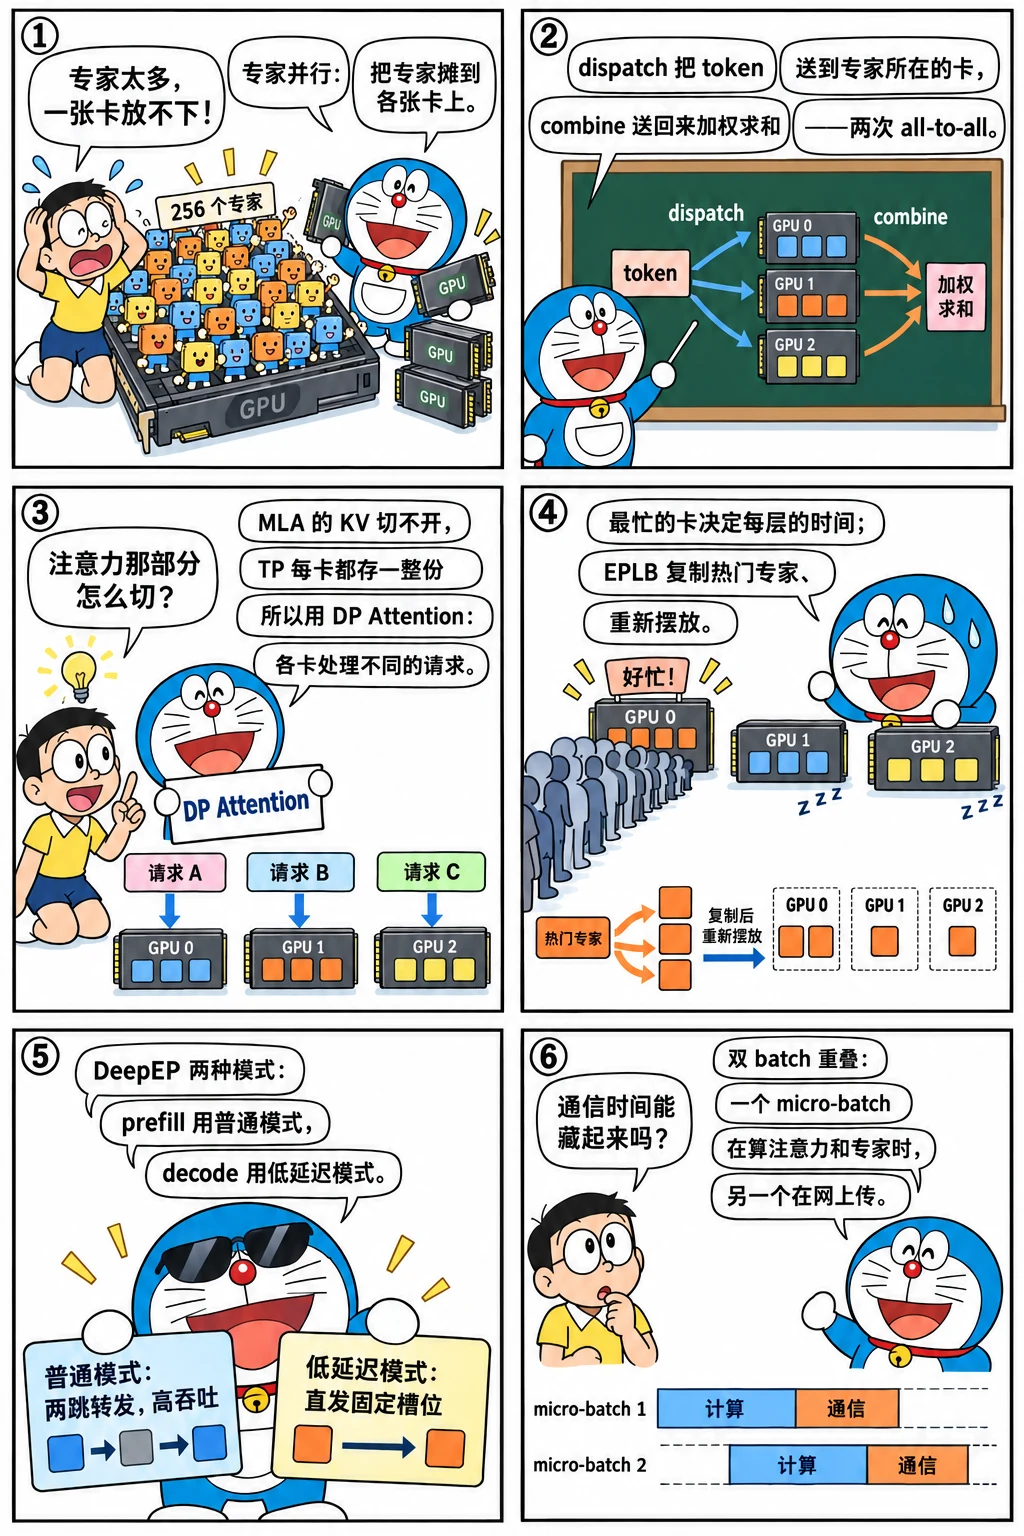
EP 与 DP Attention
大模型手册的 MoE 一章讲过 MoE 层的计算:路由器为每个 token 选出 top-k 个专家,把 token 分组交给专家计算,再按路由权重加回来。专家并行把 E 个专家平均放到 n 张卡上,每张卡 E/n 个。一个 MoE 层变成:
- 路由:每张卡为自己的 token 算出要去哪些专家(路由器很小,每张卡一份);
- dispatch(all-to-all):把每个 token 发到它的专家所在的卡;
- 专家计算:每张卡用自己的专家,按专家分组计算收到的 token;
- combine(all-to-all):把结果发回 token 原来所在的卡,按路由权重求和。
那注意力部分呢?如果做 TP,每张卡都要处理全部请求的 token,然后在 MoE 前后还要转换数据分布;而且 MLA 的潜在 KV 无法按头切分,TP 时每张卡都要存完整的 KV Cache(见张量并行)。DP Attention 的做法是:注意力部分每张卡处理不同的请求,各自维护自己请求的 KV Cache,完全没有冗余;到了 MoE 层,所有卡通过 all-to-all 组成一个大的 EP 组。
        卡 0            卡 1            卡 2            卡 3
    请求 A、B 的      请求 C 的       请求 D、E 的     请求 F 的         ← DP:各卡处理不同请求
    注意力(本地 KV)  注意力(本地 KV)  注意力(本地 KV)  注意力(本地 KV)
          └───────────── dispatch:all-to-all ─────────────┘
     专家 0~3         专家 4~7        专家 8~11       专家 12~15        ← EP:各卡放不同专家
          └───────────── combine:all-to-all ──────────────┘
    下一层注意力 ……
实现
复用大模型手册的 moe.py(MoE.route 负责路由,forward_grouped 是单进程的参考实现):
"""ep.py —— 专家并行(EP)+ DP Attention 的最小实现:两次 all-to-all(dispatch 与 combine)。

用法:torchrun --nproc-per-node 4 --master-addr 127.0.0.1 --master-port 29500 ep.py
每个 rank 处理自己的一批 token(DP Attention:注意力部分各 rank 处理不同的请求),
MoE 层的 E 个专家平均分给各 rank;token 按路由结果发给专家所在的 rank,算完再发回来。
"""

import os

import torch
import torch.distributed as dist

from moe import MoE

D, D_FF, N_EXPERTS, TOP_K = 64, 128, 16, 2


def all_to_all(x: torch.Tensor, send_counts: list[int]) -> tuple[torch.Tensor, list[int]]:
    """先交换"各发多少",再按这个数量交换数据。"""
    world = dist.get_world_size()
    counts = torch.tensor(send_counts)
    recv = torch.empty(world, dtype=torch.long)
    dist.all_to_all_single(recv, counts, [1] * world, [1] * world)
    recv_counts = recv.tolist()
    out = torch.empty((sum(recv_counts),) + tuple(x.shape[1:]), dtype=x.dtype)
    dist.all_to_all_single(out, x.contiguous(), recv_counts, send_counts)
    return out, recv_counts


def ep_forward(moe: MoE, x: torch.Tensor, rank: int, world: int) -> tuple[torch.Tensor, int]:
    per_rank = N_EXPERTS // world
    weights, idx, _ = moe.route(x)                                     # 路由器在每个 rank 上都有一份
    flat_expert = idx.flatten()                                        # [N*k] 每个 (token, 槽位) 要去的专家
    flat_token = torch.arange(x.shape[0]).repeat_interleave(TOP_K)
    dest = flat_expert // per_rank                                     # 专家所在的 rank
    order = dest.argsort(stable=True)                                  # 按目标 rank 排好,才能按段发送
    send_counts = torch.bincount(dest, minlength=world).tolist()

    # dispatch:把 token 的隐藏状态和"要去哪个本地专家"发到专家所在的 rank
    recv_x, recv_counts = all_to_all(x[flat_token[order]], send_counts)
    recv_e, _ = all_to_all(flat_expert[order] - dest[order] * per_rank, send_counts)

    # 本地计算:按专家分组,每个本地专家对分到它的所有 token 做一次矩阵乘法
    y = torch.empty_like(recv_x)
    for e in range(per_rank):
        sel = (recv_e == e).nonzero().flatten()
        if len(sel):
            y[sel] = moe.experts[rank * per_rank + e](recv_x[sel])

    # combine:把结果发回 token 原来所在的 rank,再按路由权重加回原位置
    back, _ = all_to_all(y, recv_counts)
    out = torch.zeros_like(x)
    out.index_add_(0, flat_token[order], back * weights.flatten()[order, None])
    return out + sum(s(x) for s in moe.shared), recv_x.shape[0]


def main():
    dist.init_process_group("gloo")
    rank, world = dist.get_rank(), dist.get_world_size()
    torch.manual_seed(0)
    moe = MoE(D, D_FF, N_EXPERTS, TOP_K)                              # 所有 rank 用同一个种子,得到同一份完整权重
    torch.manual_seed(100 + rank)
    n_tokens = [96, 32, 64, 128][rank % 4]                             # 各 rank 的 batch 大小不同(DP)
    x = torch.randn(n_tokens, D)
    with torch.no_grad():
        out, n_received = ep_forward(moe, x, rank, world)

    # 在 rank 0 上汇总所有 token,用单进程的完整 MoE 计算作为参考(各 rank 大小不同,用对象收集)
    gathered = [None] * world
    dist.all_gather_object(gathered, (x, out, n_received))
    if rank == 0:
        xs, outs, loads = zip(*gathered)
        with torch.no_grad():
            ref = moe.forward_grouped(torch.cat(xs))
        err = (torch.cat(outs) - ref).abs().max().item()
        print(f"EP={world}:每个 rank {N_EXPERTS // world} 个专家;各 rank 的 token 数 {[len(t) for t in xs]}")
        print(f"各 rank 收到的 (token, 专家) 对数:{list(loads)}(总数 = token 数 × top-{TOP_K} = {sum(len(t) for t in xs) * TOP_K})")
        print(f"与单进程完整 MoE 的最大误差:{err:.1e}")
    dist.destroy_process_group()


if __name__ == "__main__":
    main()
all_to_all 分两步:先交换"我要发给你多少",各卡据此分配接收缓冲区,再交换数据本身。每个 (token, 专家) 对都要发一次隐藏状态,所以 dispatch 的数据量是 token 数 × top-k × hidden。
4 个进程,16 个专家,top-2,各卡的 token 数不同(DP 下每张卡的负载本来就不一样):
import os
import socket
import subprocess
import sys

with socket.socket() as s:                       # 找一个空闲端口。不用 --standalone:它要做主机名的反向解析,macOS 上常常卡住
    s.bind(("127.0.0.1", 0))
    port = s.getsockname()[1]
result = subprocess.run([sys.executable, "-m", "torch.distributed.run", "--nproc-per-node", "4",
                         "--master-addr", "127.0.0.1", "--master-port", str(port), "build/code/ep.py"],
                        capture_output=True, text=True, env={**os.environ, "OMP_NUM_THREADS": "2"}, timeout=1200)
print(result.stdout.strip())
assert float(result.stdout.split("最大误差:")[1]) < 1e-5
EP=4:每个 rank 4 个专家;各 rank 的 token 数 [96, 32, 64, 128]
各 rank 收到的 (token, 专家) 对数:[160, 165, 179, 136](总数 = token 数 × top-2 = 640)
与单进程完整 MoE 的最大误差:0.0e+00
结果与单进程完全一致。注意各卡收到的计算量(第二行)与各卡自己的 token 数(第一行)没有关系:卡 1 自己只有 32 个 token,却要为全体算 165 个 (token, 专家) 对。EP 下每张卡的计算量由路由决定。
负载均衡:EPLB
路由器的选择在推理时不受控制。如果某些专家特别"热门",它们所在的卡就要处理多得多的 token,其他卡算完了只能等它:一层的时间由最慢的那张卡决定。
训练时的负载均衡损失(大模型手册 MoE 一章)只能让平均情况大致均衡,实际负载还会随输入分布变化。推理引擎的办法是 EPLB(Expert Parallelism Load Balancer):统计一段时间内各专家的负载,然后
- 冗余专家:把最热的几个专家复制多份,放到不同的卡上,它们的 token 平分给各个副本;
- 重新放置:把专家(含副本)重新分配到各卡,使每张卡的总负载尽量接近。
用一个偏斜的负载分布模拟一下(64 个专家、8 张卡,额外 8 个冗余槽位):
import heapq
import random

random.seed(0)
num_experts, num_gpus, num_redundant = 64, 8, 8
load = [1 / (i + 1) ** 0.8 for i in range(num_experts)]      # 类 Zipf 分布:少数专家很热
random.shuffle(load)

def imbalance(gpu_loads):
    return max(gpu_loads) / (sum(gpu_loads) / len(gpu_loads))

per_gpu = num_experts // num_gpus
naive = [sum(load[g * per_gpu:(g + 1) * per_gpu]) for g in range(num_gpus)]

# 1. 冗余:反复把"单个副本负载最大"的专家再复制一份
replicas = [1] * num_experts
for _ in range(num_redundant):
    hottest = max(range(num_experts), key=lambda e: load[e] / replicas[e])
    replicas[hottest] += 1
items = sorted((load[e] / replicas[e] for e in range(num_experts) for _ in range(replicas[e])), reverse=True)

# 2. 放置:从大到小,每个副本放到当前负载最小、且还有空位的卡上
slots = (num_experts + num_redundant) // num_gpus
heap = [(0.0, g, 0) for g in range(num_gpus)]                 # (负载, 卡号, 已放数量)
for w in items:
    skipped = []
    while True:
        l, g, n = heapq.heappop(heap)
        if n < slots:
            break
        skipped.append((l, g, n))
    heapq.heappush(heap, (l + w, g, n + 1))
    for s in skipped:
        heapq.heappush(heap, s)
balanced = [l for l, _, _ in heap]
print(f"按顺序放置:最忙的卡是平均负载的 {imbalance(naive):.2f} 倍")
print(f"冗余 {num_redundant} 个专家 + 重新放置:{imbalance(balanced):.2f} 倍")
最忙的卡从平均负载的 2.26 倍降到 1.00 倍,MoE 部分的时间缩短了一半以上。代价是冗余专家占用额外的显存,以及重新放置时要搬运专家权重(通常异步进行,或在负载变化不频繁时周期性执行)。
通信:DeepEP 与计算通信重叠
EP 的每一层都有两次 all-to-all,它们的规模有多大?以 DeepSeek-V3(hidden 7168,top-8)为例,每张卡每步 decode 128 个 token:
hidden, top_k, tokens = 7168, 8, 128
dispatch = tokens * top_k * hidden * 1          # dispatch 用 FP8 传输,每个数 1 字节
combine = tokens * top_k * hidden * 2           # combine 用 BF16
for name, bw in [("NVLink(约 450 GB/s)", 450e9), ("InfiniBand 400 Gb/s(约 50 GB/s)", 50e9)]:
    print(f"{name}:每层 dispatch + combine 共 {(dispatch + combine) / 1e6:.0f} MB,约 {(dispatch + combine) / bw * 1e6:.0f} μs")
NVLink(约 450 GB/s):每层 dispatch + combine 共 22 MB,约 49 μs
InfiniBand 400 Gb/s(约 50 GB/s):每层 dispatch + combine 共 22 MB,约 440 μs
这是"所有 (token, 专家) 对都跨卡发送"的上限估计。跨机器时,每层几百微秒,乘以 58 个 MoE 层,就是几十毫秒,比 decode 一步的计算时间还长。几项关键技术都是为了对付这个问题:
- 限制跨机器的路由:DeepSeek-V3 训练时就约束每个 token 最多发往 4 个节点,并且同一个节点只发一次,到节点内再通过 NVLink 转发给多个专家,跨机流量大幅减少;
- DeepEP:DeepSeek 开源的 EP 通信库。普通模式针对 prefill:大批量、高吞吐,同时利用 NVLink(机内)和 RDMA(机间)的带宽;低延迟模式针对 decode:纯 RDMA、小消息延迟极低,并且可以被 CUDA Graph 录制;
- 两批重叠(two-batch overlap,TBO):把一个批次拆成两个微批次,一个在做注意力或专家计算时,另一个在做 all-to-all 通信,交替进行,把通信时间藏在计算后面;
- PD 分离:prefill 和 decode 的最佳 EP 规模与通信模式完全不同,分开部署才能各自最优(见 PD 分离)。
源码对照
- vLLM:MoE 层在
vllm/model_executor/layers/fused_moe/(FusedMoE及多种专家计算 kernel);all-to-all 的实现在vllm/distributed/device_communicators/all2all.py,由--all2all-backend选择:deepep_high_throughput(DeepEP 普通模式,适合 prefill)、deepep_low_latency(低延迟模式,适合 decode)、pplx、flashinfer_nvlink_*等,默认是allgather_reducescatter;EPLB 在vllm/distributed/eplb/(--enable-eplb)。数据并行 + 专家并行用--data-parallel-size和--enable-expert-parallel开启。 - SGLang:
--enable-dp-attention开启 DP Attention,--ep-size设置 EP 规模,--moe-a2a-backend deepep选择 DeepEP;相关代码在srt/layers/dp_attention.py、srt/layers/moe/、srt/eplb/,两批重叠在srt/batch_overlap/(--enable-two-batch-overlap)。SGLang 团队的博客详细记录了在 96 张 H100 上用 PD 分离 + 大规模 EP 部署 DeepSeek 的过程,值得一读。
怎么讲清楚
"怎么部署 DeepSeek-V3 这样的大 MoE 模型?",按五步讲:显存(671B 参数,FP8 约 700 GB,至少一台 8 卡 H200 或多机)→ 并行(注意力 DP 以避免 MLA 的 KV 冗余,MoE 用 EP,all-to-all 连接两者)→ 通信(DeepEP:prefill 用普通模式、decode 用低延迟模式;两批重叠隐藏通信;限制跨节点路由)→ 负载(EPLB:冗余专家 + 重新放置)→ 分离(PD 分离,prefill 和 decode 用不同的 EP 规模)。每一点都能说出"为什么",就讲到位了。
练习
1. 为什么 decode 需要大 EP? 256 个专家、top-8,一张卡上的 decode batch 为 64。如果只用 8 张卡做 EP(每卡 32 个专家),每个专家平均分到多少个 token?用 256 张卡(每卡 1 个专家)呢?这对专家计算的效率意味着什么?
参考答案
全部 8 张卡共 512 个 token,产生 512 × 8 = 4096 个 (token, 专家) 对,平均每个专家 16 个 token。无论 EP 多大,每个专家分到的 token 数取决于全局 batch;但 EP 越大,全局 batch(DP 的总和)越大:256 张卡、每卡 64 个 token,全局 16384 个 token,每个专家平均 512 个。专家计算是 [专家的 token 数, hidden] × [hidden, d_ff] 的 GEMM,token 太少时是访存受限的 GEMV,读一遍专家权重只算十几个 token;token 多了才能接近计算受限。所以大规模 EP 的意义不只是放得下,更是让每个专家攒够 token,提高计算效率。
2. DP Attention 的负载问题。 DP Attention 下,某一步卡 0 有 100 个 decode 请求,卡 1 只有 10 个。会发生什么?
参考答案
注意力部分卡 1 很快就算完了,但 MoE 层的 all-to-all 是集合通信,所有卡必须同时参与,卡 1 只能等卡 0。更麻烦的是 CUDA Graph 与 all-to-all 要求各卡的形状一致,所以通常会把各卡的 batch 填充到同样大小(SGLang 中称为 MLP sync,没有请求的卡也要执行一次 IDLE 前向)。因此 DP Attention 需要在各 DP rank 之间均衡请求(按请求数和 KV 用量路由),vLLM 的 DPLBAsyncMPClient 和 SGLang 的 DataParallelController 都在做这件事。
训练侧的专家并行
训练时 all-to-all 也要反向传播,负载均衡则靠辅助损失或无辅助损失的偏置调整。分布式训练手册的 MoE 与专家并行一章实现了带 autograd 的 dispatch / combine,并模拟了 DeepSeek-V3 的偏置均衡。
小结
- EP 把专家分到各卡,每个 MoE 层两次 all-to-all:dispatch 发送 token,combine 收回结果。
- DP Attention 让各卡处理不同请求,避免 MLA 的 KV 冗余,与 EP 组合是大 MoE 模型的主流部署方式。
- 负载不均衡让最慢的卡决定每层时间,EPLB 用冗余专家和重新放置来均衡。
- 跨机 all-to-all 代价很高:限制路由的节点数、DeepEP 的两种模式、两批重叠、PD 分离共同应对。
本章练习题(2 道)
在浏览器里直接写代码、跑测试;也可以在本地用 python practice/judge.py 判题。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题