注意力后端矩阵与页式 KV
2024 年 9 月的注意力后端接口有两个实现;到 2025 年 8 月的 v0.5.0rc0 有十几个,基准提交里有三十多个:FlashInfer、FlashAttention 3、FlashMLA、cutlass MLA、TRT-LLM MLA、AITER、Ascend、Intel、各种混合与稀疏注意力。同一时期,KV 池从"每页一个 token"变成可配置的页大小(2025 年 3 月 #4356),这一改动牵动了分配器、基数树、投机解码和 PD 分离。这一章讲后端矩阵是怎么长出来的、页大小为什么拖到 2025 年才做、以及多硬件支持怎样从"AMD 能跑"变成 hardware_backend/ 目录。
自测:能答上来就可以跳过本章
- 后端数量从 2 到 30 多,新后端主要分几类?各解决什么?
- 页大小为 1 有什么代价?改成大于 1 要动哪些模块?
- 今天的
AttentionBackend接口比 2024 年多了哪几类方法?各为哪个功能服务? - 多硬件支持的代码放在哪里?和注意力后端是什么关系?
自测参考答案(先自己答,再展开对照)
- 按硬件(AITER 给 AMD、Ascend 给昇腾、Intel 的 CPU / XPU)、按注意力结构(MLA 的 FlashMLA / cutlass MLA / TRT-LLM MLA / FlashInfer MLA;混合模型的 hybrid 后端;稀疏注意力的 NSA / DSA、double sparsity、dual chunk)、按 kernel 库(FlashInfer、FlashAttention 3、Triton、纯 torch)。
- 元数据大(请求表每个 token 一项)、注意力 kernel 按 token 间接寻址、许多外部 kernel(FA3、FlashMLA)本来就按页设计。改动:
paged_allocator.py新的分配器按页分配、基数树的键按页对齐(匹配只到页边界)、ScheduleBatch的分配与释放、投机解码的候选页复制、HiCache 的备份按页、PD 的传输按页。 - 图相关的更细分(
init_forward_metadata_in_graph/out_graph、可中断的捕获、弹性重捕获)、投机解码相关(draft_extend_metadata_captured_in_graph、verify_mask、update_verify_buffers_to_fill_after_draft)、混合批次(forward_mixed)、共享前缀读(shared_read_ends、chunked prefix)、稀疏注意力的索引元数据(get_indexer_metadata)。 hardware_backend/目录(基准提交 95 个文件)放各家硬件的平台适配(设备查询、通信、kernel 选择),注意力后端是其中一层:每种硬件通常对应一个或几个注意力后端,由平台层决定默认选择。
先看一个六格小剧场,再读正文:
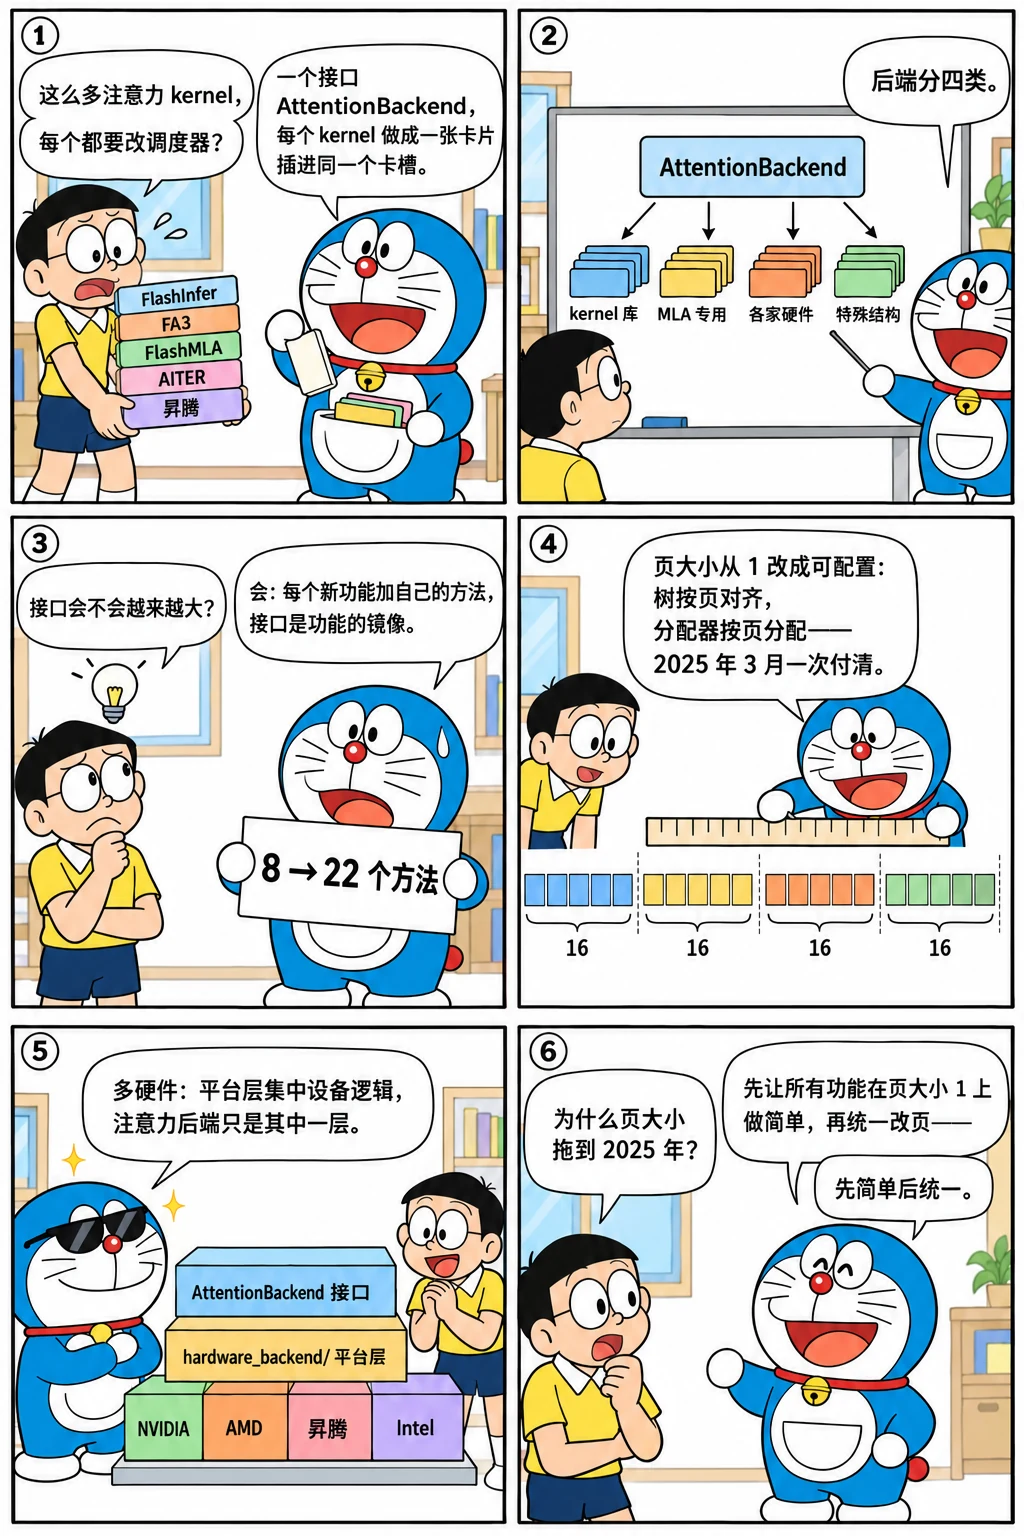
后端矩阵
REF=${REF:-29f6d408c0}
for t in v0.4.0 v0.4.6 v0.5.0rc0 "$REF"; do
  printf '%-11s %2d 个:' "$t" "$(git ls-tree -r --name-only "$t" -- python/sglang/srt/layers/attention | grep -c '_backend\.py$')"
  git ls-tree -r --name-only "$t" -- python/sglang/srt/layers/attention | grep '_backend\.py$' | sed 's|.*/||; s|_backend\.py||' | tr '\n' ' ' | cut -c1-150; echo
done
v0.4.0       4 个:double_sparsity flashinfer torch_native triton

v0.4.6       8 个:base_attn double_sparsity flashattention flashinfer flashinfer_mla flashmla torch_native triton

v0.5.0rc0   17 个:aiter ascend base_attn cutlass_mla double_sparsity dual_chunk_flashattention flashattention flashinfer flashinfer_mla flashmla hybrid_attn intel_amx t

29f6d408c0  34 个:aiter base_attn cutedsl_mla deepseek_v4 deepseek_v4_trtllm dots_hybrid dsa_topk paged_mqa_logits dsa flashattention flashinfer flashinfer_mla flashmla
2025 年上半年的几个节点:
for h in 36f6fc5093 c76040e31b a53fe428f9 b6944f97a6 5d7edc8e55 26c0f13126 20c90be23d 1c63e79756 e983e43248 51d25405a7; do
  git log -1 --date=short --format='%ad  %h  %s' $h | cut -c1-96
done
2025-02-10  36f6fc5093  feat: enable ragged fa3 by default on hopper 12.4+ (#3442)
2025-03-12  c76040e31b  Support page size > 1 (#4356)
2025-03-17  a53fe428f9  Support FlashMLA backend (#4472)
2025-03-19  b6944f97a6  Support FlashMLA backend cuda graph (#4514)
2025-03-23  5d7edc8e55  Support FA3 as Attention backend by using `--attention-backend fa3` (#46
2025-03-27  26c0f13126  Support Page Size > 1 for FA3 (#4832)
2025-03-28  20c90be23d  [Feature] Support FA3 backend for MLA (#4831)
2025-03-31  1c63e79756  use fa3 in sgl-kernel (#4954)
2025-04-02  e983e43248  Add Eagle Speculative Decoding to FA3 Backend (#4951)
2025-03-04  51d25405a7  ROCm: update aiter and its usage to fused moe (bloat16, fp8, fp8 block-q
- FlashAttention 3:2 月先在 Hopper 上默认用 FA3 的 ragged kernel 做 prefill(#3442),3 月 23 日 #4680 成为完整的后端
--attention-backend fa3,4 天后支持页大小大于 1(#4832)和 MLA(#4831),3 月 31 日 FA3 搬进 sgl-kernel 编译(#4902 / #4954),4 月 2 日支持 EAGLE(#4951)。一个后端从"能用"到"全功能"大约两周。 - MLA 专用后端:FlashMLA(#4472,3 月 17 日)两天后支持 CUDA Graph;cutlass MLA、TRT-LLM MLA、FlashInfer MLA 随后——MLA 的 decode kernel 成了各家比拼的地方。
- AMD:AITER(#4053、#4075,3 月初)接管 ROCm 上的 MoE 和 GEMM;注意力后端
aiter_backend.py在 v0.5.0rc0 已经存在。
接口本身也在长。基准提交的 base_attn_backend.py:
REF=${REF:-29f6d408c0}
echo "v0.4.0:$(git show v0.4.0:python/sglang/srt/layers/attention/__init__.py | grep -c '    def ') 个方法"
echo "今天:$(git show "$REF:python/sglang/srt/layers/attention/base_attn_backend.py" | grep -c '    def ') 个方法,其中和 cuda_graph 有关的 $(git show "$REF:python/sglang/srt/layers/attention/base_attn_backend.py" | grep '    def ' | grep -ci 'graph') 个、和投机解码有关的 $(git show "$REF:python/sglang/srt/layers/attention/base_attn_backend.py" | grep '    def ' | grep -ciE 'draft|verify') 个"
git show "$REF:python/sglang/srt/layers/attention/base_attn_backend.py" | grep '    def ' | sed 's/^ *def //; s/(.*//' | tr '\n' ' ' | cut -c1-400; echo
v0.4.0:8 个方法
今天:22 个方法,其中和 cuda_graph 有关的 10 个、和投机解码有关的 3 个
max_of init_forward_metadata init_forward_metadata_out_graph init_forward_metadata_in_graph draft_extend_metadata_captured_in_graph shared_read_ends prepare_prefill_shared_read_snapshot prepare_full_cuda_graph_chunked_prefix init_cuda_graph_state validate_elastic_cuda_graph_recapture init_forward_metadata_for_breakable_cuda_graph_capture prepare_forward_metadata_for_breakable_cuda_graph_replay get
和第 10 章的八个方法比,多出来的几类正好对应后来的功能:图的捕获变得可分段、可重捕获(piecewise CUDA graph、弹性 EP);投机解码的 draft / verify 要自己的掩码和缓冲区;混合批次(forward_mixed);共享前缀的读取(多个请求共享同一段 KV 时只读一次);稀疏注意力的索引元数据(DeepSeek 的 DSA)。后端接口是整个系统功能的镜像。
页大小:一个拖了一年的决定
初版的"每页一个 token"让基数树能在任意位置切分(第二章)。它的代价在 2024 年就清楚了:请求表每个 token 一项、kernel 按 token 间接寻址、外部 kernel 大多按页设计。2025 年 H1 路线图把 "page size > 1 #4356" 列为条目,3 月 12 日合入:
git show --stat=100 --format='%ad %an %s' --date=short c76040e31b | grep -v '^$' | cut -c1-96
2025-03-12  Lianmin Zheng  Support page size > 1 (#4356)
 python/sglang/srt/layers/quantization/fp8_kernel.py            |   2 +-
 python/sglang/srt/managers/schedule_batch.py                   | 271 ++++++++++++++++++--------
 python/sglang/srt/managers/schedule_policy.py                  |  15 +-
 python/sglang/srt/managers/scheduler.py                        | 125 +++++++------
 python/sglang/srt/managers/scheduler_output_processor_mixin.py |  13 +-
 python/sglang/srt/managers/tp_worker_overlap_thread.py         |   5 +-
 python/sglang/srt/mem_cache/base_prefix_cache.py               |  14 +-
 python/sglang/srt/mem_cache/chunk_cache.py                     |  56 ++----
 python/sglang/srt/mem_cache/hiradix_cache.py                   |   6 +-
 python/sglang/srt/mem_cache/memory_pool.py                     |  78 ++++++--
 python/sglang/srt/mem_cache/paged_allocator.py                 | 283 ++++++++++++++++++++++++++
 python/sglang/srt/mem_cache/radix_cache.py                     | 153 ++++++++++++----
 python/sglang/srt/model_executor/cuda_graph_runner.py          |   4 +
 python/sglang/srt/model_executor/forward_batch_info.py         |  20 +-
 python/sglang/srt/model_executor/model_runner.py               |  27 ++-
 python/sglang/srt/server_args.py                               |   2 +
 python/sglang/srt/utils.py                                     |   7 +
 test/srt/run_suite.py                                          |   1 +
 test/srt/test_dp_attention.py                                  |   6 +-
 test/srt/test_gptqmodel_dynamic.py                             |   1 +
 test/srt/test_mla_deepseek_v3.py                               |   2 +-
 test/srt/test_page_size.py                                     |  46 +++++
 test/srt/test_retract_decode.py                                |  18 ++
 23 files changed, 874 insertions(+), 281 deletions(-)
改动最大的三处:新的 paged_allocator.py(283 行,按页分配、alloc_extend / alloc_decode 处理"最后一页还有空位"的情况)、radix_cache.py 的键按页对齐(匹配只到页边界,节点的分裂也按页)、schedule_batch.py 的分配与释放。接着是一连串"X + page size > 1":PD(#5561)、FA3(#4832)、EAGLE(#4908)、撤回(#4914)、HiCache(#4581)、大页的 OOM(#4913)——每个已有功能都要重新考虑页边界。为什么拖到 2025 年?因为页大小为 1 时所有这些功能都不需要考虑对齐,先做功能、再统一改页,比一开始就按页做让每个功能都更复杂要划算;代价是改的时候要一次性付清。
多硬件:从"AMD 能跑"到 hardware_backend/
REF=${REF:-29f6d408c0}
git log --reverse --date=short --format='%ad  %h  %s' "$REF" | grep -iE '^\S+\s+\S+\s+.*(\bamd\b|rocm)' | head -1 | cut -c1-96
git log --reverse --date=short --format='%ad  %h  %s' "$REF" | grep -iE 'ascend|\bnpu\b' | head -1 | cut -c1-96
git log --reverse --date=short --format='%ad  %h  %s' "$REF" | grep -iE '\bcpu backend\b|intel.*cpu|cpu.*intel' | head -1 | cut -c1-96
git log --reverse --date=short --format='%ad  %h  %s' "$REF" | grep -iE '\bxpu\b' | head -1 | cut -c1-96
echo "hardware_backend/ 子目录:$(git ls-tree --name-only "$REF" python/sglang/srt/hardware_backend/ | sed 's|.*/||' | tr '\n' ' ')"
2024-09-17  3a6e04185b  [Feature, Hardware] Enable SGLang on AMD GPUs via PyTorch for ROCm (#142
2025-05-07  00c2c1f08b  [Feature] Support for Ascend NPU backend (#3853)
2025-05-31  888cb175a6  Add intel_amx backend for Radix Attention for CPU (#6408)
2024-10-13  5d638c92f5  [Feature, Hardware] Enable SGLang on XPU GPUs via PyTorch (#1480)
hardware_backend/ 子目录:cpu gpu mlx musa npu xpu
2024 年 9 月 AMD 的第一个提交之后,多硬件支持长期是散落各处的 if is_hip() 分支;2025 年各家硬件(AMD 的 AITER、昇腾、Intel 的 CPU 与 XPU、后来的 TPU 走独立的 sglang-jax)各自贡献 kernel 和后端,分支越来越多。基准提交的 hardware_backend/ 和 platforms/ 把平台相关的逻辑(设备查询、默认后端选择、通信库、内存查询)集中起来,注意力后端只是平台适配的一层。这是推理系统手册多硬件支持一章讲的 platform 抽象在 SGLang 里的形状。
设计取舍
- 后端接口随功能生长,而不是一开始就设计完整。 八个方法够用了一年;每个新功能加自己需要的方法,接口成为功能的镜像。代价是实现一个新后端要面对二十多个方法(多数有默认实现或可以不支持)。
- 页大小后做。 先用 page size 1 让所有功能简单,2025 年一次性改页并逐个功能适配。
- 外部 kernel 优先。 FA3、FlashMLA、FlashInfer 都是外部库,SGLang 只写后端适配和元数据;自己的 Triton 后端保证任何平台都能跑、也是新功能的试验田(第 14 章)。
后来怎么样了
- 2025 下半年:NSA / DSA 稀疏注意力后端(DeepSeek-V3.2 的索引器)、混合模型(Mamba、线性注意力 + 全注意力)的 hybrid 后端与对应的内存池、Blackwell 的 TRT-LLM 后端;
- 页大小的默认值仍是 1(兼容最好),MLA 与 FA3 等后端在页大小 > 1 时更快,文档按后端给推荐值;
hardware_backend/到基准提交有 95 个文件,platforms/8 个;TPU 用独立的 sglang-jax 仓库(2025-12 的文档)。
练习
1. 后端的注册。 在基准提交里找到注意力后端的注册表(按名字选后端的地方),数一数支持的名字,并找出哪些后端只在特定硬件上可用。
参考思路
git grep -n 'attention_backend' 29f6d408c0 -- python/sglang/srt/server_args.py 看 choices 列表,git grep -n 'def _get_attention_backend\|ATTENTION_BACKENDS' 29f6d408c0 -- python/sglang/srt/model_executor 看注册与选择逻辑。
2. 页对齐的代价。 页大小 16 时,一个 100 个 token 的前缀能命中基数树上多少 token?剩下的怎么办?
参考答案
匹配只到页边界:最多 96 个(6 整页),剩下 4 个重算。页越大,前缀缓存的粒度越粗,命中的 token 越少;这是 kernel 效率与缓存粒度的折中。
3. 一个后端的两周。 用 git log --date=short --format='%ad %h %s' -- python/sglang/srt/layers/attention/flashattention_backend.py | tail -30 看 FA3 后端的前 30 个提交,按"功能 / 修复 / 性能"分类。
参考思路
会看到页大小、MLA、EAGLE、滑动窗口、CUDA Graph 的功能提交和一批精度 / 同步相关的修复——新后端融入系统的典型路径。
怎么讲清楚
"推理引擎怎么支持多种注意力 kernel 和多种硬件?"——用 SGLang 的接口讲:后端接口把"元数据怎么准备(含 CUDA Graph 的捕获与回放)"和"前向怎么算"交给实现,新后端只加文件;接口随功能生长(投机解码、混合批、稀疏索引各加方法)。页大小的故事说明"先简单后统一"的取舍。多硬件则靠平台层集中设备相关逻辑,注意力后端只是其中一层。
小结
- 后端从 2 个到 30 多个:按硬件、按注意力结构、按 kernel 库三类;接口方法数从 8 个长到 22 个,是系统功能的镜像。
- 页大小 > 1(#4356,2025-03-12):新分配器、页对齐的树、随后每个功能逐一适配;拖到 2025 年是有意的取舍。
- 多硬件从散落的分支变成
hardware_backend/与platforms/,注意力后端是平台适配的一层。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题