从 Chatbot Arena 到一篇论文:SGLang 要解决什么问题
SGLang 不是作为"又一个推理引擎"诞生的。2023 年底的论文把它定义为一种语言加一个运行时:语言用来写由多次模型调用、控制流和结构化输出组成的"LM 程序",运行时则利用程序的结构(共享前缀、固定格式、并行分支)把这些程序跑得更快。这一章读论文和最早的两个提交,弄清作者最初的问题定义,再把论文的每一节对应到初始代码的目录上。后面所有章节讲的演变,都是从这个起点出发的。
自测:能答上来就可以跳过本章
- 论文说的"LM 程序"是什么?它给推理系统带来了哪两个传统引擎没有针对的难题?
- 论文的三个运行时技术分别利用了 LM 程序的什么结构?
- 为什么说 SGLang 是"前端语言与运行时协同设计",而不是先有引擎再加 API?
- 初始代码里哪些目录对应论文的哪些章节?哪些论文里的东西后来淡出了?
自测参考答案(先自己答,再展开对照)
- 由多次 LLM 调用、Python 控制流和结构化输入输出组成的程序(多轮对话、智能体、思维树、JSON 抽取……)。两个难题:写起来繁琐(字符串拼接、提示词调试、脆弱的输出解析、多模态、并行),跑起来低效(引擎只看到一个个独立请求,不知道它们共享前缀、输出有固定格式)。
- RadixAttention 利用多次调用之间的共享前缀(KV 缓存复用);压缩有限状态机利用结构化输出里的确定性片段(一次前向解码多个 token);API 投机执行利用 API 模型调用之间的连续性(多生成一些 token 留给后面的调用)。
- 运行时需要的信息(哪些请求共享前缀、输出必须匹配什么格式、哪些分支可以并行)只有程序层知道;语言把这些信息显式地表达出来(
gen的regex、fork/join、select),运行时据此优化。初始提交里语言(lang/)和运行时(srt/)同时出现,而且运行时的 HTTP 接口是按语言的需要设计的(max_new_tokens=0的请求用来预热前缀)。 lang/对应前端语言与解释器 / 编译器;srt/managers/router/radix_cache.py与scheduler.py对应 RadixAttention 和缓存感知调度;srt/constrained/对应压缩 FSM;backend/openai.py对应 API 投机执行。后来淡出的是前端语言和编译器:运行时成了主角,前端在 2025 年被简化成可选组件。
先看一个六格小剧场,再读正文:
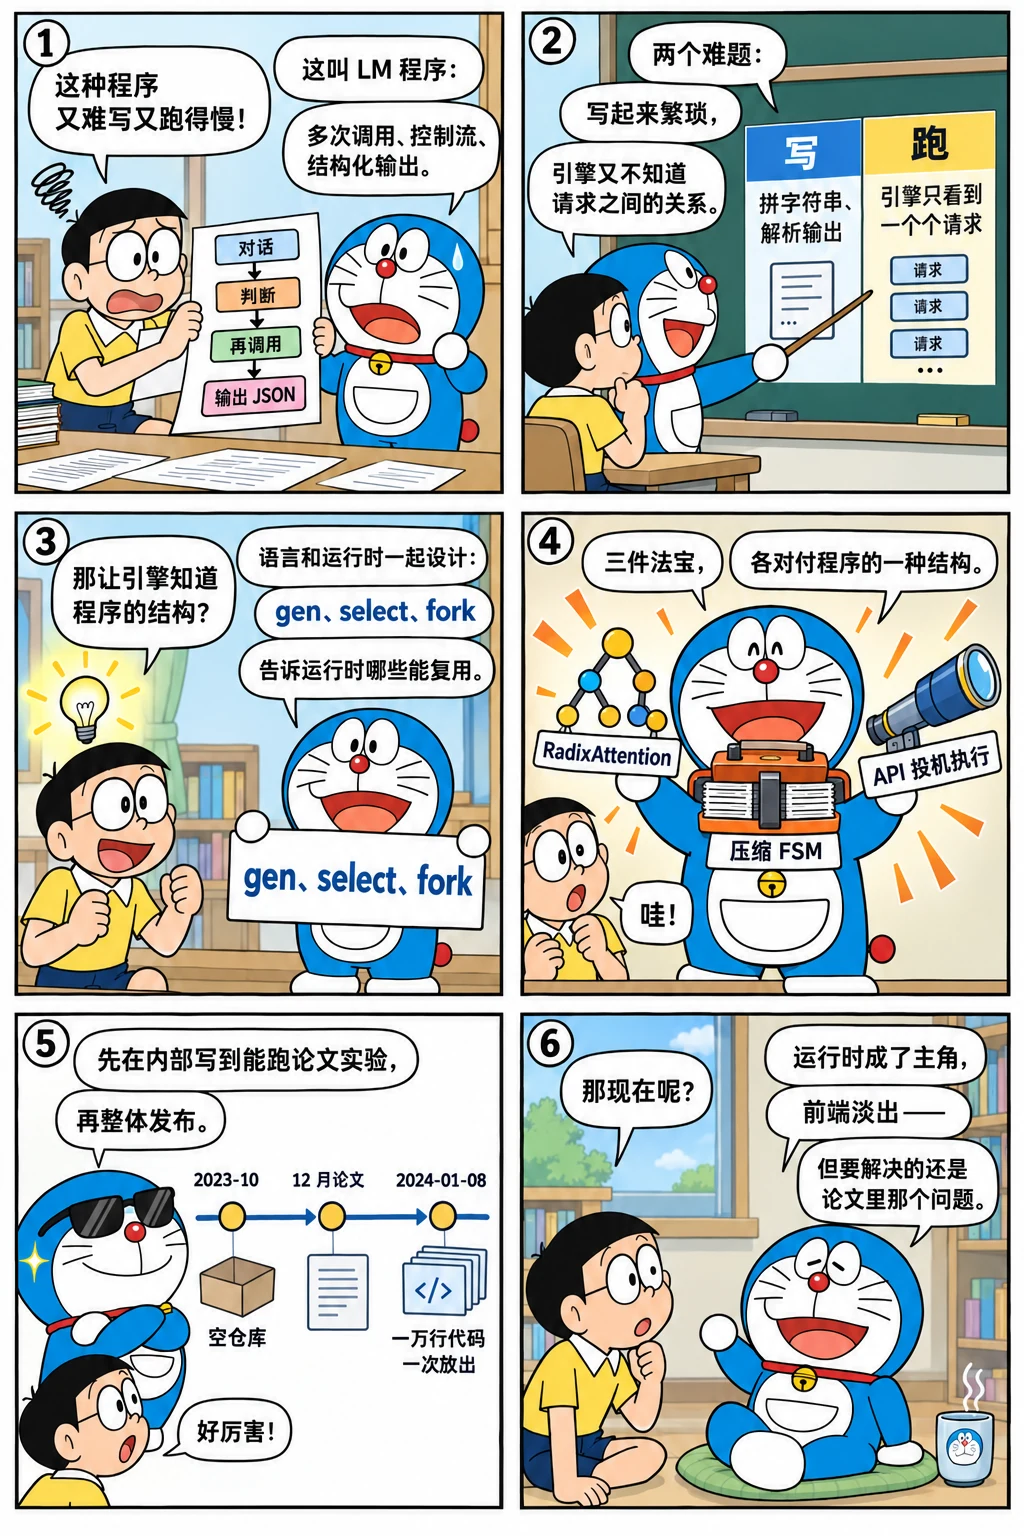
四个月:空仓库、论文、代码、博客
先用 git 看仓库的头两个提交。本书所有命令都在 SGLang 仓库根目录执行,$REF 是固定的基准提交(见首页):
REF=${REF:-29f6d408c0}
git log --reverse --date=short --format='%ad  %h  %<(15)%an %s' "$REF" | head -4
2023-10-09  f6d40df0ee  Ying Sheng      Initial commit
2024-01-08  22085081bb  Lianmin Zheng   release initial code
2024-01-09  ead5b39f82  Liangsheng Yin  Add flashinfer && Oultines (#1)
2024-01-08  93eeb543ba  Lianmin Zheng   Update readme.md
2023 年 10 月 9 日的第一个提交只有三个文件:.gitignore、Apache 2.0 的 LICENSE 和一行 # sglang 的 README。真正的代码在三个月后的 2024 年 1 月 8 日一次性放出(22085081bb,"release initial code"),中间的 12 月 12 日论文第一版上了 arXiv(2312.07104),1 月 17 日 LMSYS 发了介绍博客,同一天打了第一个 tag v0.1.5(更早的 v0.1.3 在 16 日)。也就是说,代码不是在公开仓库里一点点长出来的,而是先在内部写到能跑论文实验,再整体发布。初始提交的规模:
git show --stat=10 --format= 22085081bb | tail -1
git ls-tree -r --name-only 22085081bb | cut -d/ -f1 | sort | uniq -c | sort -rn
 145 files changed, 17802 insertions(+), 2 deletions(-)
     56 benchmark
     52 python
     18 test
     11 examples
      2 playground
      2 docs
      1 format.sh
      1 README.md
      1 LICENSE
      1 .gitmodules
      1 .gitignore
145 个文件、1.78 万行,其中 python/ 52 个文件是全部实现,benchmark/ 56 个文件是论文实验(MMLU、HellaSwag、生成式智能体、思维树、JSON 解码、多轮对话、LLaVA……每个目录一个 bench_sglang.py 和一个 bench_other.py),test/ 18 个文件。这个比例本身就说明了项目的来源:它是为了验证一篇论文的主张而写的。
论文的问题定义:LM 程序
论文(v2 的标题是 SGLang: Efficient Execution of Structured Language Model Programs,v1 叫 Efficiently Programming Large Language Models using SGLang,初始 README 里引用的还是 v1 的标题)开篇定义了"LM 程序":
应用正从单次调用变成由多次 LLM 调用、控制流和结构化输入输出组成的程序。
典型例子:多轮对话(每一轮都带着完整历史)、智能体(ReAct 循环里反复调用)、思维树 / 骨架思维(同一个前缀分出多个分支)、LLM 评审(同一道题多次打分)、JSON 抽取(输出必须符合模式)、少样本评测(成百上千个问题共享同一段示例)。论文指出两个难题:
| 难题 | 具体表现 | 论文的回答 |
|---|---|---|
| 写起来难 | 字符串拼接、提示词反复调试、输出解析脆弱、多模态输入、手工实现并行 | 一门嵌在 Python 里的前端语言:gen、select、fork/join、image、角色标记 |
| 跑起来慢 | 引擎按独立请求优化吞吐和延迟,不知道请求之间共享前缀、输出有固定格式 | 运行时三件套:RadixAttention、压缩 FSM、API 投机执行 |
这个定义决定了 SGLang 和同期 vLLM 的差别:vLLM 的出发点是"一个请求怎么服务得更高效"(PagedAttention 解决 KV 显存碎片),SGLang 的出发点是"一组有结构的请求怎么跑得更快"。两者后来互相吸收(vLLM 加了前缀缓存,SGLang 加了分页),但起点不同,很多早期设计只有放回这个起点才好理解。
运行时的三个想法
RadixAttention:把 KV 缓存当成一棵树。 传统做法是请求结束就释放 KV;论文把所有请求的 token 序列组织成一棵基数树(radix tree),节点的值是 KV 缓存在显存里的位置。新请求先在树上匹配最长前缀,命中的部分不再计算。几个配套决定都来自"LM 程序"这个场景:
- 树上的节点按最近访问时间做 LRU 淘汰,叶子优先,被正在运行的请求引用的节点(引用计数大于 0)不能淘汰;
- 调度时优先处理匹配前缀最长的请求(longest-prefix-first),论文还证明了对一批请求按树的深度优先顺序处理可以达到最优命中率(定理 3.1,前提是缓存容量不小于最长请求);
- 多卡数据并行时,路由器维护一棵"元树"记录每个 worker 的子树,把请求发给前缀命中最多的 worker。
论文报告的命中率在各基准上为 50% 到 99%;在 LMSYS 自己的 Chatbot Arena 生产流量上,LLaVA-NeXT-34B 的命中率 52.4%,Vicuna-33B 为 74.1%,首 token 延迟平均降低 1.7 倍。管理这棵树的 CPU 开销很小:100 个无复用请求共 74.3 秒,树操作只占 0.2 秒。下一章会看到,初版代码的 KV 池是按 token 分页的(每页一个 token),正是为了让树上任意位置都能切开。
压缩有限状态机:一次前向解码多个 token。 正则约束解码的常规做法(Outlines)是把正则编译成 FSM,每一步只允许 FSM 当前状态能接受的 token。论文观察到 JSON 模式里大段文本是确定的(键名、引号、冒号),对应 FSM 里一连串只有一条出边的状态,于是把这样的边压缩成一条,一次"跳"过整段确定的字符串,论文叫 jump-forward。代价是跳过的字符串和前面的文本拼起来之后要重新分词,否则 token 边界和模型训练时见到的不一致。这是第四章的主题,它后来的命运也最曲折。
API 投机执行:对闭源模型也能省调用。 对 OpenAI 这类只有 API 的模型,运行时让一次调用多生成一些 token(忽略停止条件),后面的 gen 如果恰好是续写,就直接复用,省下一次调用的延迟和输入费用。这个想法只在前端层实现,和运行时无关。
前端:两种执行方式
论文的前端有两种执行模式,初始代码里都有:
- 解释器:程序里的每个原语(
+=文本、gen、select)提交到一个后台线程异步执行,Python 代码不等结果就继续往下走,拿变量时才阻塞——这就是lang/interpreter.py里的StreamExecutor; - 编译器 / 追踪器:先用假参数把程序跑一遍,记录下原语构成的图,再做优化后执行。论文举的优化例子是"代码移动":让 GPT-4 把可共享的常量文本挪到前面,在 15 个模板里有 12 个把可共享前缀平均延长了 60 个 token。这对应
lang/tracer.py和lang/compiler.py。
第五章读这部分代码。先记住一个结论:追踪器的一个实际用途是提取程序的常量前缀,批量运行前先把前缀发给运行时预热缓存。
评估告诉我们作者在乎什么
论文在 A10G(24 GB)上用 Llama-7B,大模型用张量并行,对比 Guidance v0.1.8、vLLM v0.2.5 和 LMQL v0.7.3。工作负载清单很说明问题:5-shot MMLU、20-shot HellaSwag、ReAct 智能体、生成式智能体、思维树(GSM-8K)、骨架思维、LLM 评审、JSON 解码、多轮对话、DSPy RAG、LLaVA 图像和视频任务,再加一个 ShareGPT 做"无结构"对照。头条数字:吞吐最高 6.4 倍、延迟最高降低 3.7 倍;压缩 FSM 让 JSON 解码吞吐提高 1.6 倍,前提是 FSM 预处理的结果能被一批请求复用,否则反而慢 2.4 倍。
这些工作负载后来都成了仓库里 benchmark/ 的目录名,也解释了初版代码的很多"偏科":没有抢占、没有分块 prefill、调度器只有 70 行,但前缀匹配、树的淘汰、正则约束、select 用的归一化对数概率、多模态输入的缓存,一个不少——因为论文的实验需要它们。
把论文对应到代码
用一段脚本数一数初始提交里各模块的规模(Python 文件和行数):
import collections, subprocess
REF0 = "22085081bb"
files = subprocess.run(["git", "ls-tree", "-r", "--name-only", REF0, "--", "python/sglang"], capture_output=True, text=True).stdout.split()
GROUPS = [("lang/ 前端语言", "python/sglang/lang/"), ("backend/ 外部后端", "python/sglang/backend/"),
          ("srt/managers/router/ 调度与执行", "python/sglang/srt/managers/router/"), ("srt/managers/ 分词与进程", "python/sglang/srt/managers/"),
          ("srt/constrained/ 约束解码", "python/sglang/srt/constrained/"), ("srt/layers/ 注意力算子", "python/sglang/srt/layers/"),
          ("srt/models/ 模型", "python/sglang/srt/models/"), ("srt/ 其他(内存池、参数、服务)", "python/sglang/srt/"), ("顶层(api、test、utils)", "python/sglang/")]
count = collections.Counter(); lines = collections.Counter()
for f in files:
    if not f.endswith(".py"):
        continue
    n = subprocess.run(["git", "show", f"{REF0}:{f}"], capture_output=True, text=True).stdout.count("\n")
    group = next(name for name, prefix in GROUPS if f.startswith(prefix))
    count[group] += 1; lines[group] += n
print(f"{'模块':<34}{'文件':>4}{'行数':>7}")
for name, _ in GROUPS:
    print(f"{name:<34}{count[name]:>4}{lines[name]:>7}")
print(f"{'合计':<34}{sum(count.values()):>4}{sum(lines.values()):>7}")
模块                                  文件     行数
lang/ 前端语言                           6   1841
backend/ 外部后端                        7   1082
srt/managers/router/ 调度与执行           6   1645
srt/managers/ 分词与进程                  4    404
srt/constrained/ 约束解码                4   1278
srt/layers/ 注意力算子                    6   1190
srt/models/ 模型                       3    907
srt/ 其他(内存池、参数、服务)                   7    960
顶层(api、test、utils)                   8    906
合计                                  51  10213
对照论文:
| 论文章节 | 初始代码 | 后来的位置 |
|---|---|---|
| 2 前端语言、解释器、编译器 | lang/(1655 行)、api.py、backend/ |
python/sglang/lang/,2025-08 起成为可选组件 |
| 3.1 RadixAttention、缓存感知调度 | srt/managers/router/radix_cache.py、scheduler.py、srt/memory_pool.py、srt/layers/radix_attention.py |
srt/mem_cache/、srt/managers/schedule_policy.py、srt/layers/radix_attention.py |
| 3.2 压缩 FSM | srt/constrained/(从 Outlines 改编的 FSM 代码) |
srt/constrained/ 的多后端(Outlines、xgrammar、llguidance) |
| 3.3 API 投机执行 | backend/openai.py(#48,2024-01-25 加入) |
python/sglang/lang/backend/openai.py |
| 5 评估 | benchmark/ 下 14 个目录 |
benchmark/,大部分目录仍在 |
运行时的三类进程(分词、路由 / 调度、反分词)和 ZMQ 通信也在初始提交里,这是下一章的内容。
设计取舍:为什么协同设计
把语言和运行时放在一个仓库里,而不是像 LangChain 那样只做前端、像 vLLM 那样只做引擎,是初版最大的决定。它带来三件事:
- 信息跨层传递。 前端知道哪些文本是常量前缀(追踪器)、哪些
gen有格式约束(regex)、哪些分支共享上下文(fork),这些都变成运行时能用的信号。初版的 HTTP 接口里有max_new_tokens=0的请求(只预热缓存不生成)和/concate_and_append_request(把 fork 出来的分支的 KV 拼回主干),都是为前端服务的接口。 - 评测口径是程序而不是请求。 论文的所有数字都是"一个 LM 程序跑完要多久",吞吐和延迟的定义跟着程序走。这让 RadixAttention 这种"只在有共享结构时才有收益"的技术有了合适的舞台。
- 代价是前端的维护。 一门语言要有解释器、追踪器、编译器、多种后端和聊天模板;当运行时成了用户真正要的东西,这部分就成了负担。
作者的原话
初始 README 把 SGLang 定义为"为大语言模型设计的结构化生成语言(structured generation language)……通过前端语言与运行时的协同设计让交互更快、更可控",并在末尾注明"学习了 Guidance、vLLM、LightLLM 等项目的设计并复用了部分代码"。README 的 Roadmap 列了五项:function call、constrained decoding、quantization、S-LoRA、more models——其中 constrained decoding 在代码里其实已经有了正则版,这里指的是更完整的 JSON / 语法支持。
后来怎么样了
- 定义变了。 到基准提交
29f6d408c0,README 的第一句是 "SGLang is an open-source inference framework for LLMs and multimodal models, optimized for agentic workloads, RL rollouts, and large-scale serving"。"语言"不见了,"推理框架"成了身份;但"agentic workloads"仍然是论文里"LM 程序"的延续。 - 前端淡出。 2025-08-10 的 "Simplify frontend language (#9029)" 把
api.py挪进lang/,前端成为可选安装的组件;lang/目录三年里只有 160 个左右的提交,而srt/managers/有 2700 多个。 - 三个想法的命运各不相同。 RadixAttention 成为整个系统的基石,一路长成分层缓存和分布式存储(第 16 章);压缩 FSM 的 jump-forward 在 2025-03 被从调度器里删掉,功能转移到 xgrammar 这类语法库内部(第四章);API 投机执行留在前端里,几乎没有再动。
- 评测口径回归请求。 后来的博客比较的是
bench_serving.py的吞吐和延迟,和 vLLM 一样按请求算;"程序"视角的评测随前端一起淡出。
练习
1. 论文和代码的时间差。 用 git 找出初始提交之后、第一个 tag 之前的提交数和作者,判断"先内部写好再发布"的说法是否站得住。
参考答案
git log --reverse --date=short --format='%ad %h %an %s' v0.1.3:22085081bb 之后到 v0.1.3(2024-01-16)只有十来个提交,作者是 Lianmin Zheng、Liangsheng Yin、Ying Sheng 等论文作者,内容是 README、安装方式、几个示例和 fix radix cache match (#7)。核心代码一次到位,之后才是公开迭代,说法成立。
2. 论文的基准在仓库里留下了什么。 列出初始提交里 benchmark/ 的子目录,再看基准提交里哪些还在、哪些没了。
参考答案
git ls-tree --name-only 22085081bb benchmark/ 得到 14 个目录(dspy、generative_agents、gsm8k、hellaswag、latency_throughput、line_retrieval、llava_bench、llm_judge、long_json_decode、mmlu、mtbench、multi_chain_reasoning、react、tree_of_thought 等);git ls-tree --name-only 29f6d408c0 benchmark/ 里这些目录大多还在,新增了 kernels、deepseek、gpt-oss 等与 kernel 和特定模型相关的目录。可以看到基准从"LM 程序"扩展到了"算子与模型"。
3. 从 README 看定位的变化。 用 git log -S 找出 README 第一句话从 "structured generation language" 变成 "fast serving framework" 的提交,并读一下那次提交信息。
参考思路
git log --date=short --format='%ad %h %s' -S'structured generation language' -- README.md 会列出引入和删除这句话的提交;最后一个删除它的提交就是定位改变的时间点(2024 年年中,和 v0.2 的发布接近)。读它的 diff 能看到新的自我描述。
怎么讲清楚
"SGLang 和 vLLM 的设计出发点有什么不同?"——先说起点:vLLM 从单请求的显存效率出发(PagedAttention),SGLang 从一组有结构的请求出发(LM 程序:共享前缀、固定格式、并行分支),所以它第一天就有基数树前缀缓存、按 token 分页和正则约束解码。再说收敛:两者后来互相吸收了对方的核心(vLLM 的前缀缓存、SGLang 的分页与抢占),今天的差别更多在工程细节而不是理念。能把"起点不同、终点相近"讲清楚,比背功能列表有说服力。
小结
- SGLang 诞生于一篇论文:把多次调用、控制流和结构化输出组成的"LM 程序"当作优化对象,语言和运行时协同设计。
- 运行时三个想法各对应程序的一种结构:RadixAttention 对共享前缀、压缩 FSM 对确定性片段、API 投机执行对调用连续性。
- 代码在 2024-01-08 一次性发布(145 个文件、1.78 万行),论文的每一节都能在初始目录里找到对应物。
- 后来运行时成为主角,前端淡出;三个想法里 RadixAttention 一路壮大,jump-forward 退出调度器,API 投机执行原地不动。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题