面试怎么讲 SGLang
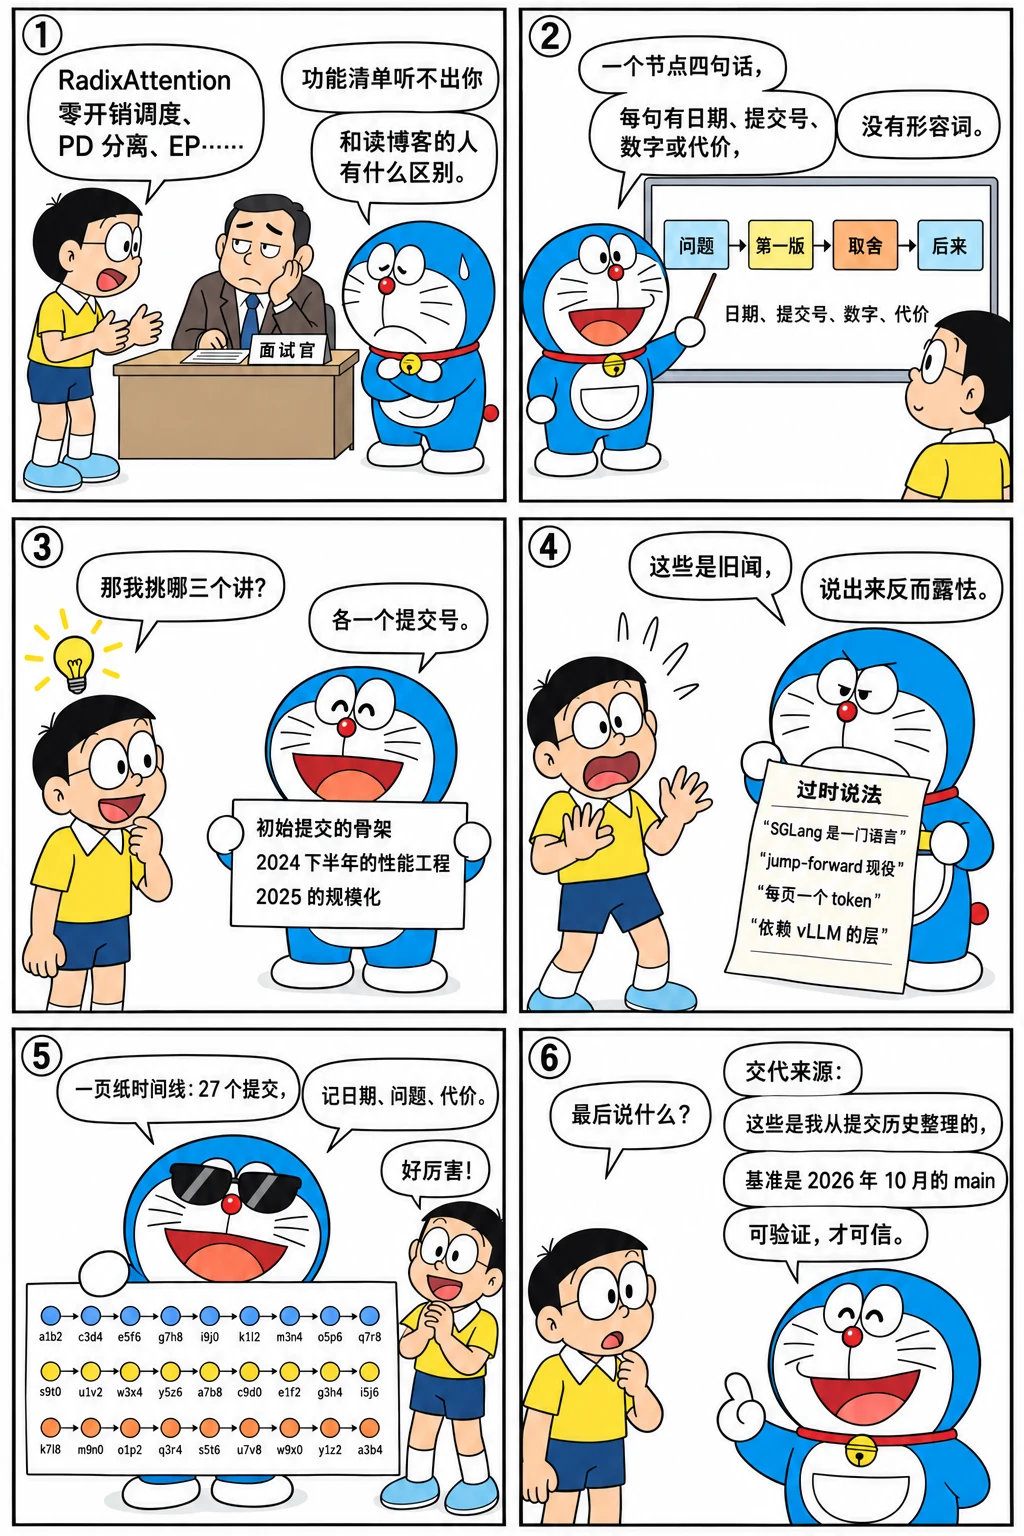
面试里讲一个开源项目,最常见的失败是把它讲成功能清单:RadixAttention、零开销调度、PD 分离、EP……每个词都对,却听不出你和一个读过官方博客的人有什么区别。这本书的材料能让你换一种讲法:按时间讲"问题 → 第一版 → 取舍 → 后来怎么改",每个节点落到提交号和代价上。这一章给出一套讲法的模板、十二个高频问题的回答提纲(都指回具体章节)、以及几个容易说错的地方。
自测:能答上来就可以跳过本章
- 用三分钟讲 SGLang 的架构,你会选哪三个节点?
- "SGLang 比 vLLM 快在哪"这个问题怎么答才不像背博客?
- 被追问"重叠调度的代价"时,你能举出哪几个具体的提交?
- 哪些说法是过时的、面试时不要再说?
自测参考答案(先自己答,再展开对照)
- 推荐:初始提交的骨架(三类进程、两级 KV 池、预估准入)→ 2024 下半年的性能工程(CUDA Graph 默认、重叠调度与未来 token、目录分层)→ 2025 的规模化(PD 分离作为大规模 EP 的前提,worker / mixin 不碰主干)。每个节点一个提交号、一个代价。
- 分阶段、给条件:v0.2 时的 3.1 倍来自 CUDA Graph 默认、动态准入与撤回、连续 decode(小 batch、Llama-70B、vLLM 0.5.2);v0.4 的 1.1 倍来自重叠调度;DeepSeek 场景的收益来自 DP attention + EP + PD + TBO + EPLB。再说一句今天两者互相吸收、差距主要在工程细节。
- 竞态(#1712)、CUDA 非法内存访问(#2048 / #2070)、撤回(#1860)、约束解码(#2095 / #2377)、混批(#2158)、多模态一度禁用(#2235)——从第一个提交到默认开启用了一个月。
- "SGLang 是一门语言"(前端已是可选组件)、"用 jump-forward 加速结构化输出"(2025-03 删除,功能在语法库里)、"每页一个 token"(页大小可配)、"依赖 vLLM 的层"(已拿回)、"通过 rpyc 调度"(2024-07 去掉)。
先看一个六格小剧场,再读正文:
讲法的模板
一个节点用四句话:当时的问题 → 第一版怎么做 → 取舍是什么 → 后来怎么改。例如重叠调度:
2024 年 10 月之前调度器每步要等 GPU 算完再组下一批,小 batch 时 GPU 有空隙(问题)。#1687 起把前向放到另一个线程、调度器提前一步,下一批里还没采样出的 token 用负数占位、前向线程在 GPU 上解析(第一版)。代价是所有依赖"结果已知"的逻辑都要改,默认开启前花了一个月修撤回、约束解码、混批的竞态(取舍)。v0.4 博客给的数字是 1.1 倍;2025 年投机解码 v2 把草稿和验证也纳入了同一套重叠(后来)。
四句话里有日期、提交号、数字和代价,没有形容词。准备五到六个这样的节点,按面试官的方向挑三个讲。
十二个高频问题
| 问题 | 回答提纲 | 章 |
|---|---|---|
| SGLang 和 vLLM 的设计出发点有什么不同? | 起点不同(LM 程序 vs 单请求显存效率),终点相近;初版第一天就有基数树、按 token 分页、正则约束 | 1 |
| RadixAttention 怎么实现? | 树节点存一段 token 和槽位;匹配 / 插入在边中间分裂;准入时锁、结束时插入去重;叶子 LRU;发布 8 天修的匹配 bug | 3 |
| 结构化输出怎么加速? | FSM 掩码;压缩 FSM / jump-forward 归约成新请求;2025-03 删掉自研、交给 xgrammar | 4 |
| 多卡时调度怎么一致? | 每个 rank 重复调度、只广播输入;DP attention 每步同步形状、IDLE 陪跑 | 6、13 |
| SGLang 为什么快? | 按版本分:v0.2 三个来源;v0.4 重叠;DeepSeek 场景五件套;条件要说清 | 9、12、18 |
| 推理引擎的模块怎么划分? | 按生命周期分目录,批次三层,注意力只选后端;带来的三样好处 | 10 |
| MLA 推理怎么算、怎么存? | 潜向量 + RoPE 维;权重吸收;第二种池,树不改 | 11 |
| 投机解码怎么集成? | 做成 worker;槽位先申请后回滚;树形掩码一次验证;与撤回 / DP / 页大小的磨合 | 15 |
| KV 缓存怎么做多级? | 节点带 host_value;控制器两线程按层搬;三种写策略;存储层用内容哈希做键 | 16 |
| PD 分离怎么实现? | decode 先握手预分配;prefill 按 chunk 单边写;81 行传输接口;三个动机 | 17 |
| DeepSeek-V3 怎么高吞吐部署? | PD + 两种 DeepEP 模式 + 两种 GEMM 布局 + TBO + EPLB;博客的数字与来源 | 18 |
| 推理引擎怎么支持 RL? | 三种换权重、保持地址的释放 / 恢复、SPMD 嵌入;接口的来历 | 22 |
每一行的"提纲"都能展开成上面的四句话;章节里"怎么讲清楚"的提示框是更长的版本。
容易说错的地方
- 把前端当现状。 "SGLang 是一门语言"是 2024 年初的定义,今天的 README 说它是推理框架;提前端可以,要说明它已是可选组件(第五章)。
- 把博客的数字当普适结论。 3.1 倍有模型、GPU、基线版本和 batch 范围的条件;说数字就带条件。
- 把 jump-forward 当现役功能。 2025-03-03 的 #4032 删掉了调度器里的实现,xgrammar 在库内做同样的事。
- 把"每个 rank 重复调度"说成浪费。 它是有意的:用 CPU 换一致性,省掉每步的元数据广播。
- 把 PD 分离只说成降延迟。 博客的三个动机里两个关于 DeepEP 与 DP attention——它是大规模 EP 的前提。
- 把 sgl-kernel 说成"自研所有 kernel"。 主力注意力与 GEMM 来自外部库,自写的是融合算子与胶水。
- 引用过时的路径。
srt/managers/router/、controller/、hiradix_cache.py、sgl-kernel/顶层目录都已不在;说历史路径时注明年份。
一页纸的时间线
面试前可以把这张表过一遍:
for h in 22085081bb 01ca82d765 26f0bedc8f 0463f7fb52 d774acad5c 665815969a cdcbde5fc3 e1eae1fd15 f86c1e611f 99ec439da4 dbec2f1847 7d671e4ad2 976bc302e5 cbedd1db1d 419a57e771 815dce0554 6c7a152c5a c76040e31b c7c7dbebbe f44db16c8e 0d47788025 70c471a868 ce32bc2ba9 53ca15529a 7bc1dae095 b36afed4a7 49dfa1d891; do
  git log -1 --date=short --format='%ad  %h  %s' $h | cut -c1-80
done | sort
2024-01-08  22085081bb  release initial code
2024-01-16  01ca82d765  fix radix cache match (#7)
2024-02-05  26f0bedc8f  jump-forward rename (#144)
2024-05-27  0463f7fb52  Support data parallelism (static) (#480)
2024-07-13  665815969a  Enable cuda graph by default (#612)
2024-07-18  d774acad5c  Remove the dependency of rpyc (#646)
2024-07-29  cdcbde5fc3  Code structure refactor (#807)
2024-08-05  e1eae1fd15  Support MLA for DeepSeek-V2 with Triton - step 1 (#905)
2024-09-29  f86c1e611f  Move scheduler code from tp_worker.py to scheduler.py (#
2024-09-30  99ec439da4  Organize Attention Backends (#1547)
2024-10-16  dbec2f1847  Launch a thread to overlap CPU and GPU (#1687)
2024-11-16  976bc302e5  Support DP MLA (#1970)
2024-11-19  7d671e4ad2  Enable overlap by default (#2067)
2024-11-23  cbedd1db1d  [router] cache-aware load-balancing router v1 (#2114)
2024-11-30  419a57e771  minor: add sgl-kernel dir (#2261)
2025-01-02  815dce0554  Eagle speculative decoding part 4: Add EAGLE2 worker (#2
2025-02-23  6c7a152c5a  Hierarchical Caching for SGLang (#2693)
2025-03-12  c76040e31b  Support page size > 1 (#4356)
2025-03-19  f44db16c8e  [Feature] Integrate DeepEP into SGLang (#4232)
2025-03-21  c7c7dbebbe  [PD] Release initial code (#4654)
2025-05-25  0d47788025  Support overlapping two batches (#4068)
2025-06-16  70c471a868  [Refactor] OAI Server components (#7167)
2025-07-26  ce32bc2ba9  Extract update_weights from RL Engine to SGLang to keep
2025-09-11  53ca15529a  Implement Standalone gRPC Server for SGLang Python Sched
2025-10-10  b36afed4a7  Separate allocation logic from scheduler (#11313)
2025-11-06  7bc1dae095  WIP: initial multimodal-gen support (#12484)
2025-12-05  49dfa1d891  [model-gateway] change sgl-router to sgl-model-gateway (
27 个提交按时间排好,对应本书 27 章里各自最该记住的那一个。记日期、记它解决的问题、记它的代价,就足够在任何追问下把故事讲下去。
练习
1. 录一遍。 挑三个节点,按"问题 → 第一版 → 取舍 → 后来"各讲一分钟,录音回听:有没有出现没有日期和代价的句子?
2. 反向准备。 把十二个问题各写一个"面试官可能的追问",用本书的脚本找到回答它所需的那条命令。
参考思路
例如"重叠调度为什么要负数占位而不是等结果"的追问,可以用 git show b48edff67f 里的 resolve_future_token_ids 回答;"PD 的 decode 为什么预分配整段"用 v0.4.6 的 _pre_alloc。
3. 更新。 面试前把 REF 换成最新的 main,跑一遍上一章的 keyword-first.sh,看有没有新概念值得加进你的时间线。
怎么讲清楚
最后一条建议:主动交代你的信息来源。"这些是我从仓库的提交历史里整理的,基准是 2026 年 10 月的 main"——它让面试官知道你的结论可验证,也给了对方一个方向:追问细节时你有提交号可以答。
小结
- 讲法:问题 → 第一版 → 取舍 → 后来,每个节点有日期、提交号、数字、代价。
- 十二个高频问题各有提纲和对应章节;几个过时说法不要再说。
- 27 个提交的一页纸时间线,面试前过一遍。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题