自己做源码考古:本书用的 git 工具箱
这本书的每一个结论都来自几条 git 命令。这一章把它们整理成一套可以复用的方法:怎样固定基准、怎样数提交、怎样找一个目录或一个概念第一次出现的时间、怎样追踪一个文件的改名、怎样在 19000 个提交里搜一个字符串、怎样读 PR 与路线图。所有脚本都在你的克隆上可运行,换一个 REF 就能把本书的数字更新到今天——或者换一个仓库,去考古别的项目。
自测:能答上来就可以跳过本章
- 为什么要固定一个基准提交?为什么本书不用 tag 当基准?
--diff-filter=A找"第一次出现"有什么坑?怎么补救?git log -S和git log -G有什么区别?什么时候用哪个?- 提交标题里的 PR 号和 PR 的实际时间可能差多久?怎么判断一个功能"开始做"和"合入"的时间?
自测参考答案(先自己答,再展开对照)
main每天都在动,不固定基准的话任何数字都不可复现;本书用29f6d408c0(2026-10-02 的 main)。tag 不行是因为 SGLang 的 release tag 打在发布分支上、不一定是 main 的祖先(git merge-base --is-ancestor v0.5.21 main返回假),从 tag 数提交会漏掉 main 上的一部分。- 文件通过改名进入新路径时,
--diff-filter=A看不到(它是 R),于是"第一次出现"会显示为空或晚于真实时间。补救:加-M(检测改名)并用--diff-filter=AR,或者对单个文件用git log --follow,或者直接按目录查第一次出现(目录级的git log -- dir/不受改名影响)。 -S找"这个字符串的出现次数发生变化"的提交(增删都算,但在文件内移动不算),适合找一个标识符的引入与删除;-G对每个提交的 diff 做正则匹配,更宽、更慢,适合找改动过某种写法的所有提交。- PR 号在开 PR 时分配、合入时才进历史,大功能可能差几个月(EAGLE 的 #2150 在 2024-11 开、2025-01-02 合;HiCache 的 #2693 在 2024-12 开、2025-02-23 合)。"开始做"看 PR 号相邻的提交日期或 PR 页面的创建时间,"合入"看提交日期;两者的差就是开发周期。
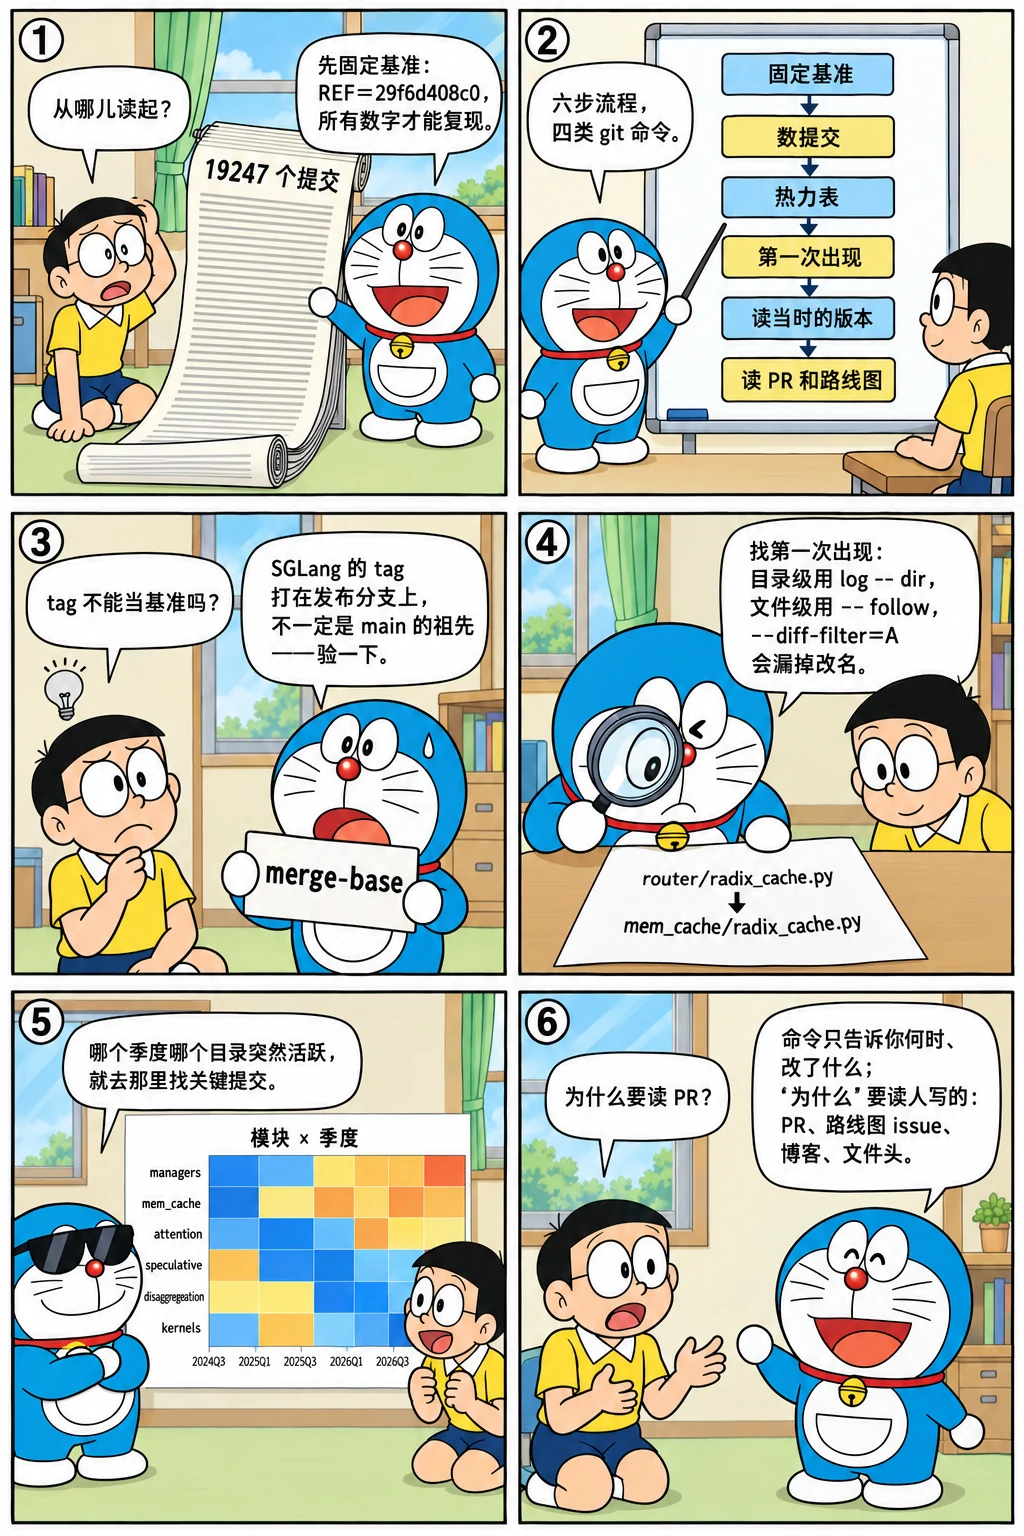
先看一个六格小剧场,再读正文:
固定基准
REF=${REF:-29f6d408c0}
echo "基准:$(git log -1 --date=short --format='%H %ad' "$REF")"
BASE=$(git log -1 --date=short --format=%ad "$REF")                   # 基准日:tag 也只数这一天及以前打的,上游以后再发版输出不变
echo "到基准为止的提交数:$(git rev-list --count "$REF"),tag 数:$(git for-each-ref --format='%(creatordate:short)' refs/tags | awk -v d="$BASE" '$1 <= d' | wc -l)"
echo "v0.5.21 是 main 的祖先吗:$(git merge-base --is-ancestor v0.5.21 "$REF" && echo 是 || echo 否)"
echo "第一个提交:$(git log --reverse --date=short --format='%ad %h %an %s' "$REF" | head -1 | cut -c1-70)"
基准:29f6d408c01c457113cbecd8773aff64398fb7c2 2026-10-02
到基准为止的提交数:19247,tag 数:165
v0.5.21 是 main 的祖先吗:否
第一个提交:2023-10-09 f6d40df0ee Ying Sheng Initial commit
本书所有脚本的第一行都是 REF=${REF:-29f6d408c0}:不传就用基准,传了就按你的来。核对脚本(sglang/tools/check_code.py)在克隆上重跑每个脚本并逐行比对输出;引用的代码块用 title="路径 @ 提交 L起-止" 标明来源,由脚本按提交号重新截取核对。
数提交:按月、按年、按作者
import collections, os, subprocess
REF = os.environ.get("REF", "29f6d408c0")
dates = subprocess.run(["git", "log", "--date=short", "--format=%ad", REF], capture_output=True, text=True).stdout.split()
by_month = collections.Counter(d[:7] for d in dates)
by_year = collections.Counter(d[:4] for d in dates)
print("按年:", dict(sorted(by_year.items())))
peak = max(by_month.items(), key=lambda kv: kv[1])
print(f"按月:共 {len(by_month)} 个月,最多的是 {peak[0]}({peak[1]} 个)")
for m in ("2024-01", "2024-07", "2025-01", "2025-07", "2026-01", "2026-07"):
    print(f"  {m}: {by_month.get(m, 0):5d} {'#' * (by_month.get(m, 0) // 40)}")
按年: {'2023': 1, '2024': 1619, '2025': 6796, '2026': 10831}
按月:共 35 个月,最多的是 2026-09(1642 个)
  2024-01:    88 ##
  2024-07:   223 #####
  2025-01:   305 #######
  2025-07:   433 ##########
  2026-01:   954 #######################
  2026-07:  1238 ##############################
git shortlog -sn A..B 给两个 tag 之间的作者排行(第九章用过);按年份数提交和作者,本书用 --date=short --format='%ad %aN' 再按日期前缀分组(第 24 章用过),而不是 --since / --until:它们按本机时区解释,而且只写日期不写时间时取的是"那天的当前时刻"(--since=2025-01-01 在上午跑和晚上跑结果不同),数字会随运行时刻漂移。注意合并方式:SGLang 用 squash 合并,一个 PR 一个提交,所以"提交数"约等于"PR 数";用 rebase 合并的仓库要先 --first-parent。
找第一次出现
目录或文件第一次出现:
REF=${REF:-29f6d408c0}
first() { git log --reverse --date=short --format='%ad %h %s' "$REF" -- "$1" | head -1 | cut -c1-80; }
printf '%-46s %s\n' python/sglang/srt/mem_cache/ "$(first python/sglang/srt/mem_cache)"
printf '%-46s %s\n' python/sglang/srt/disaggregation/ "$(first python/sglang/srt/disaggregation)"
printf '%-46s %s\n' python/sglang/srt/mem_cache/radix_cache.py "$(first python/sglang/srt/mem_cache/radix_cache.py)"
echo "-- 用 --follow 追踪 radix_cache.py 的改名:"
git log --follow --reverse --date=short --format='%ad %h %s' "$REF" -- python/sglang/srt/mem_cache/radix_cache.py | head -1 | cut -c1-80
python/sglang/srt/mem_cache/                   2024-07-29 cdcbde5fc3 Code structure refactor (#807)
python/sglang/srt/disaggregation/              2025-03-21 c7c7dbebbe [PD] Release initial code (#4654)
python/sglang/srt/mem_cache/radix_cache.py     2024-07-29 cdcbde5fc3 Code structure refactor (#807)
-- 用 --follow 追踪 radix_cache.py 的改名:
2024-07-29 cdcbde5fc3 Code structure refactor (#807)
目录级的 git log -- dir/ 不受改名影响,是最可靠的"目录何时出现";单个文件要 --follow——radix_cache.py 在 mem_cache/ 里的第一个提交是 2024-07-29 的目录重构,--follow 才能追到 2024-01-08 的初始提交。写作本书时的分析脚本一开始用 --diff-filter=A 扫全部提交,十几个通过改名进入新路径的文件都显示为"未出现"——这就是上面自测第 2 题的坑。
概念第一次出现(在提交标题里搜关键词):
REF=${REF:-29f6d408c0}
for kw in 'chunk(ed)? prefill' 'overlap' 'xgrammar' 'disagg' 'deepep' 'eplb' 'diffusion'; do
  printf '%-22s %s\n' "$kw" "$(git log --reverse --date=short --format='%ad %h %s' "$REF" | grep -iE "$kw" | head -1 | cut -c1-78)"
done
chunk(ed)? prefill     2024-07-29 2ec39ab712 Chunked prefill support (#797)
overlap                2024-10-16 dbec2f1847 Launch a thread to overlap CPU and GPU (#1687)
xgrammar               2024-10-26 b77a02cdfd [Performance] Support both xgrammar and outlines for con
disagg                 2025-04-11 c35dcfdb30 [PD] fix: skip warmup request in disaggregation mode to
deepep                 2025-03-19 f44db16c8e [Feature] Integrate DeepEP into SGLang (#4232)
eplb                   2025-05-20 f0653886a5 Expert distribution recording without overhead for EPLB
diffusion              2025-11-07 32f7982800 sglang diffusion announcement (#12856)
标题搜索便宜、够用,但只对命名稳定的概念有效;更准的是搜代码:
REF=${REF:-29f6d408c0}
echo "-- -S:引入和删除 'import rpyc' 的提交"
git log --reverse --date=short --format='%ad %h %s' -S'import rpyc' "$REF" -- python/sglang/srt | cut -c1-80
echo "-- -S:future_token_ids_map 第一次出现"
git log --reverse --date=short --format='%ad %h %s' -S'future_token_ids_map' "$REF" | head -1 | cut -c1-80
-- -S:引入和删除 'import rpyc' 的提交
2024-01-08 22085081bb release initial code
2024-05-27 0463f7fb52 Support data parallelism (static) (#480)
2024-07-18 d774acad5c Remove the dependency of rpyc (#646)
-- -S:future_token_ids_map 第一次出现
2024-10-16 dbec2f1847 Launch a thread to overlap CPU and GPU (#1687)
-S 的输出通常只有两三行:引入、(可能的)搬家、删除——一个概念的生命周期。
看一个提交、一个版本
echo "-- 一个提交改了哪些文件(-M 识别改名):"
git show --stat=90 -M --format='%ad %an %s' --date=short cdcbde5fc3 | sed -n '1p;/=>/p' | head -8 | cut -c1-90
echo "-- 某个版本的某个文件有多少行:"
printf '%s\n' "$(git show v0.2.0:python/sglang/srt/managers/controller/tp_worker.py | wc -l) 行(tp_worker.py @ v0.2.0)"
echo "-- 两个版本之间某目录的提交数:"
echo "$(git rev-list --count v0.4.0..v0.4.6 -- python/sglang/srt/mem_cache) 个(mem_cache/,v0.4.0 → v0.4.6)"
-- 一个提交改了哪些文件(-M 识别改名):
2024-07-29 Liangsheng Yin Code structure refactor (#807)
 .../{controller/manager_multi.py => controller_multi.py}  |  2 +-
 .../manager_single.py => controller_single.py}            |  2 +-
 .../schedule_heuristic.py => policy_scheduler.py}         | 24 +++++-----
 .../{controller/infer_batch.py => schedule_batch.py}      |  4 +-
 python/sglang/srt/managers/{controller => }/tp_worker.py  | 26 +++++------
 python/sglang/srt/{ => mem_cache}/flush_cache.py          |  2 +-
 python/sglang/srt/{ => mem_cache}/memory_pool.py          |  0
-- 某个版本的某个文件有多少行:
800 行(tp_worker.py @ v0.2.0)
-- 两个版本之间某目录的提交数:
46 个(mem_cache/,v0.4.0 → v0.4.6)
git show 提交:路径 不需要检出就能读任何版本的文件,本书引用的代码都是这样截的;git show --stat -M 看一次重构搬了什么(=> 是改名);git rev-list --count A..B -- 路径 数一段时间里某个模块的活跃度。第三章用 git show <提交> -- 路径 读一个 bug 修复的 diff,第 24 章用 git log --format= --name-only 数每个目录的改动次数。
模块 × 时间的热力表
import collections, os, re, subprocess
REF = os.environ.get("REF", "29f6d408c0")
MODS = [("managers", r"^python/sglang/srt/managers/"), ("mem_cache", r"^python/sglang/srt/mem_cache/"), ("layers/attention", r"^python/sglang/srt/layers/attention"),
        ("speculative", r"^python/sglang/srt/speculative/"), ("disaggregation", r"^python/sglang/srt/disaggregation/"), ("sgl-kernel/kernels", r"^sgl-kernel/|^python/sglang/kernels/"),
        ("router/gateway", r"^rust/|^sgl-router/|^sgl-model-gateway/"), ("multimodal_gen", r"^python/sglang/multimodal_gen/")]
pats = [(n, re.compile(p)) for n, p in MODS]
table, cur, touched = collections.defaultdict(collections.Counter), None, set()
out = subprocess.run(["git", "log", "--date=short", "--format=@%ad", "--name-only", REF], capture_output=True, text=True).stdout
for line in out.splitlines():
    if line.startswith("@"):
        for m in touched: table[cur][m] += 1
        d = line[1:]; cur = f"{d[:4]}Q{(int(d[5:7]) - 1) // 3 + 1}"; touched = set()
    elif line.strip():
        for n, p in pats:
            if p.search(line): touched.add(n)
for m in touched: table[cur][m] += 1
qs = sorted(q for q in table if q >= "2024Q3")
print("模块 \\ 季度".ljust(20) + "".join(q.rjust(7) for q in qs))
for n, _ in MODS:
    print(n.ljust(20) + "".join(str(table[q][n] or "·").rjust(7) for q in qs))
模块 \ 季度              2024Q3 2024Q4 2025Q1 2025Q2 2025Q3 2025Q4 2026Q1 2026Q2 2026Q3 2026Q4
managers                184    193    141    207    243    339    276    499    516      4
mem_cache                18     21     31     43    110    123    109    269    500     14
layers/attention         13     40     75     88    103    158    173    291    481     15
speculative               ·      1     36     38     40     81     41    227    268      4
disaggregation            ·      ·      2     95     51     78    107    181    278      6
sgl-kernel/kernels        ·     23    188    145    193    136     79     79    556     16
router/gateway            ·     53     14     17    213    410    148     29     95      4
multimodal_gen            ·      ·      ·      ·      ·    191    366    345    590      2
一个提交若改动了某模块下的文件就算该模块一次。这张表是本书分期的依据:哪个季度哪个目录突然活跃,就去那个季度找关键提交。git log --name-only 扫全部提交要一分钟左右——只需要树对象,用 --filter=blob:none 的克隆也能跑。
读人写的东西
命令只能告诉你"什么时候、改了什么","为什么"要读人写的:
- 提交信息与 PR 描述:
git show 提交 --format=%B -s看完整信息;PR 页面https://github.com/sgl-project/sglang/pull/<号>有讨论和评审。本书用 PR 号开的时间和合入的时间差估计开发周期。 - 路线图 issue:SGLang 每季度一份(#634、#1487、#4042、#7736、#12799……),列出计划的功能和负责人,是"当时想做什么"的最好来源;对照提交历史能看出哪些按计划做了、哪些延期或放弃。
- 博客与论文:功能的动机和数字(本书引用的 LMSYS 博客和论文),注意它们是发布时的叙述,细节以代码为准。
- 文件头:
Adapted from ...这类注释告诉你代码的来源(第八章数了 129 个)。
把方法用到别的仓库
这套方法不依赖 SGLang。换一个仓库要调整的只有三处:基准提交、MODS 里的路径模式、关键词列表。vLLM、TensorRT-LLM、llama.cpp 都可以用同样的脚本画出自己的热力表和"第一次出现"清单——推理系统手册的源码导读讲 vLLM 今天的结构,用这里的方法可以补出它的历史。
练习
1. 更新本书。 把 REF 换成今天的 main(先 git fetch),重跑 by-month.py 和 module-quarter.py,看 2026 Q4 之后哪个模块最活跃。
参考思路
REF=origin/main python3 by-month.py;热力表多出新的季度列。
2. 考古一个目录。 选 python/sglang/srt/lora/:第一次出现、提交最多的季度、最大的一次改动(按 --shortstat 的增删行数)、今天的文件数。
参考思路
git log --reverse ... -- python/sglang/srt/lora | head -1;git log --format='%ad' --date=short -- dir | cut -c1-7 | sort | uniq -c;git log --shortstat --format='%h %ad %s' -- dir 找最大的一次。
3. 换一个仓库。 克隆 vLLM,把 MODS 改成 vllm/v1/core/、vllm/v1/worker/、vllm/attention/、csrc/,画出它的热力表,找出 V1 调度器(vllm/v1/core/sched/)第一次出现的提交。
参考思路
方法相同;注意 vLLM 的合并方式和 tag 策略可能不同,--first-parent 和"tag 是否在 main 上"要重新确认。
怎么讲清楚
"你是怎么读大项目源码的?"——给出流程而不是感受:固定基准 → 按月提交量找活跃期 → 模块 × 季度热力表定位目录 → 目录与关键词的第一次出现 → git show 提交:路径 读当时的版本 → 读 PR、路线图和博客补"为什么"。再举一个你用这套方法得到的具体结论(比如 SGLang 的 jump-forward 在 2025-03 被删、功能转移到 xgrammar),面试官就知道你真的做过。
小结
- 固定基准提交(不用发布分支上的 tag),所有数字可复现。
- 四类问题四类命令:数提交(
log --format+ 计数)、第一次出现(目录级log -- dir、文件级--follow、标题 grep、-S)、看一个版本(show 提交:路径、--stat -M)、模块 × 时间热力表(--name-only)。 - "为什么"要读人写的:提交信息、PR、路线图 issue、博客、文件头;方法可以搬到任何仓库。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题