初始提交:一万行代码里的运行时长什么样
2024 年 1 月 8 日的提交 22085081bb 是 SGLang 的"创世纪":51 个 Python 文件、一万行出头,其中运行时 SRT 只有 31 个文件、6400 行。但今天 SGLang 的骨架——三类进程、ZMQ 消息、extend 前向模式、按 token 分页的两级 KV 池、调度器主循环——全都在这一万行里。这一章把初版运行时从进程到算子过一遍,每段代码都按提交号原样截取,读完你会知道后面三年的几十万行是往哪个骨架上长的。
自测:能答上来就可以跳过本章
- 初版有哪几类进程?它们之间用什么通信?模型执行在哪个进程里?
ForwardMode的三个取值分别是什么?为什么需要EXTEND而不只是 prefill 和 decode?- 初版的 KV 池为什么分成
ReqToTokenPool和TokenToKVPool两级?页大小是多少? - 初版的调度主循环一步做什么?它怎么决定新请求能不能进入 batch?
自测参考答案(先自己答,再展开对照)
- 主进程跑 FastAPI 和
TokenizerManager(分词、收结果);一个路由进程跑RouterManager的事件循环,并通过 rpyc 驱动每个 TP rank 一个的模型进程ModelRpcServer(调度 + 执行都在这里);一个反分词进程DetokenizerManager。分词 → 路由 → 反分词 → 分词之间用 ZMQ 的 PUSH/PULL(TCP),路由与模型进程之间用 rpyc。 PREFILL、EXTEND、DECODE。EXTEND是"前缀已经在缓存里、只算新增部分"的前向:有了前缀缓存,一个请求的 prefill 通常只需要计算未命中的后缀,注意力要同时读缓存里的前缀 KV 和本次新算的 KV,所以需要一个专门的 Triton kernel(extend_attention_fwd)。ReqToTokenPool是一张[请求槽, 上下文长度]的表,记录请求的第 i 个 token 的 KV 在哪个槽位;TokenToKVPool按槽位存每层的 K/V,并用引用计数管理槽位。页大小是 1 个 token,这样基数树可以在任意 token 处分裂节点、任意前缀都能复用。- 每步先尝试组一个新的 fill(extend)batch:对等待队列里每个请求做前缀匹配、按策略排序,再按"新增 token + 预计还要生成的 token(乘以估计比例)是否放得下"逐个接纳;组不出来就对运行中的 batch 连做 10 步 decode。接纳时把命中的树节点引用计数加一,防止被淘汰。
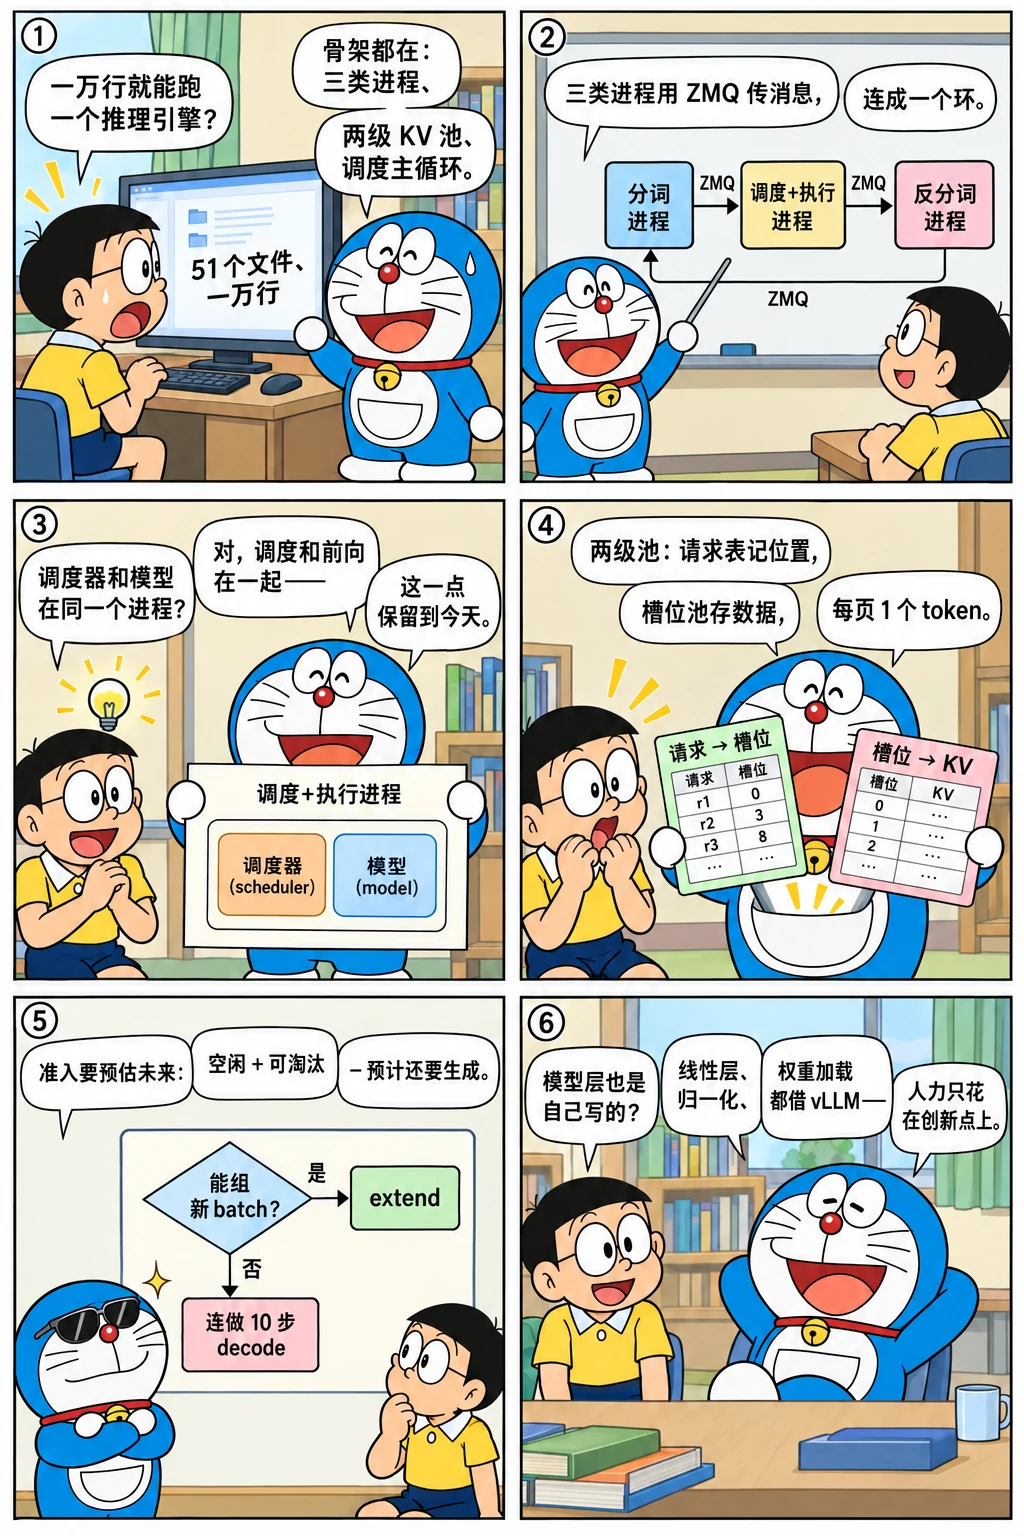
先看一个六格小剧场,再读正文:
51 个文件的分布
先列出运行时每个文件的行数:
import subprocess
REF0 = "22085081bb"
files = subprocess.run(["git", "ls-tree", "-r", "--name-only", REF0, "--", "python/sglang/srt"], capture_output=True, text=True).stdout.split()
rows = []
for f in files:
    if f.endswith(".py"):
        rows.append((subprocess.run(["git", "show", f"{REF0}:{f}"], capture_output=True, text=True).stdout.count("\n"), f.removeprefix("python/sglang/srt/")))
for n, f in sorted(rows, reverse=True):
    print(f"{n:5d}  {f}")
print(f"{sum(n for n, _ in rows):5d}  合计({len(rows)} 个文件)")
  586  constrained/regex.py
  497  managers/router/model_rpc.py
  458  managers/router/model_runner.py
  385  constrained/fsm.py
  378  models/mixtral.py
  371  layers/extend_attention.py
  326  managers/router/infer_batch.py
  324  layers/token_attention.py
  316  models/llama2.py
  266  constrained/tokenizer.py
  222  server.py
  220  managers/router/radix_cache.py
  219  managers/tokenizer_manager.py
  217  utils.py
  213  models/llava.py
  181  layers/context_flashattention_nopad.py
  164  hf_transformers_utils.py
  158  layers/radix_attention.py
  138  server_args.py
  111  memory_pool.py
   88  managers/io_struct.py
   85  managers/detokenizer_manager.py
   81  sampling_params.py
   79  layers/get_selected_logprob.py
   77  layers/logits_processor.py
   73  managers/router/scheduler.py
   71  managers/router/manager.py
   41  constrained/fsm_cache.py
   27  model_config.py
   12  managers/openai_protocol.py
 6384  合计(30 个文件)
按职责分成五块:进程与通信(server.py、managers/)、调度与批次(managers/router/model_rpc.py、infer_batch.py、scheduler.py、radix_cache.py)、执行(managers/router/model_runner.py、memory_pool.py、layers/)、模型(models/ 三个文件:Llama 2、Mixtral、LLaVA)、约束解码(constrained/)。最大的三个文件是从 Outlines 改编的正则 FSM(586 行)、调度主循环 model_rpc.py(497 行)和 model_runner.py(458 行)。
进程:三类角色与两种通信
server.py 的 launch_server 一口气把进程拉起来:分配端口,主进程里建 TokenizerManager,再 fork 出路由进程和反分词进程,通过 Pipe 等它们报告 "init ok":
主进程同时跑 uvicorn(HTTP)。TokenizerManager 收到 /generate 请求后分词,用 ZMQ 的 PUSH 把 TokenizedGenerateReqInput 发给路由进程,然后在 rid_to_state 里等结果(每个请求一个 asyncio.Event)。路由进程的 RouterManager 只有 71 行,两个协程:一个收请求攒进列表,一个循环地把攒下的请求交给模型进程走一步:
await asyncio.sleep(0.001) 这一行值得注意:每步之后让出 1 毫秒去收新请求,这是最朴素的"调度与收包交错"。model_client.step 背后是 rpyc 远程调用:ModelRpcClient 为每个 TP rank 起一个进程跑 ModelRpcServer,exposed_step 在模型进程里执行调度和前向。所以初版的"调度器"实际上住在模型进程里,路由进程只是一个搬运工——这个结构后来被反复重构(第六章),但"调度和模型执行在同一个进程"这一点一直保留到今天的 Scheduler。
反分词进程把 token id 变成字符串再 PUSH 回主进程,三个进程构成一个环:tokenizer → router → detokenizer → tokenizer。为什么要把反分词单独放一个进程?因为流式输出时每生成一两个 token 就要 decode 一次,放在调度进程里会拖慢 GPU;放在主进程里又会和 HTTP 事件循环抢 GIL。这个三进程结构从初版保留到今天。
一步:fill 或者 decode
ModelRpcServer.exposed_step 收下请求后调用 forward_step,这就是初版的调度主循环:
逻辑很直接:能组出新的 fill batch 就跑它(extend 前向),然后并进 running_batch;否则对 running_batch 连续做 10 步 decode。"连做 10 步"是一个早期特有的取舍:每一步都回到 Python 层检查新请求有开销,干脆一次做多步,代价是新请求最多等 10 个 decode 步才被处理。后来有了更细的调度和重叠执行,这个数字就消失了。
get_new_fill_batch 决定谁能进来。先对等待队列里每个请求做前缀匹配、按策略排序,然后估计可用空间:
        available_size = (
            self.token_to_kv_pool.available_size() + self.tree_cache.evictable_size()
        )
        new_ratio = self.scheduler.new_token_estimation_ratio()
        if self.running_batch:
            available_size -= sum(
                [
                    (r.max_new_tokens() - len(r.output_ids)) * new_ratio
                    for r in self.running_batch.reqs
                ]
            )
...
            if (
                req.adjust_input_len + req.max_new_tokens() + new_batch_total_tokens
                < available_size
                and req.adjust_input_len + new_batch_input_tokens
                < self.max_prefill_num_token
            ):
                delta = self.tree_cache.inc_ref_counter(req.last_node)
                available_size += delta

                if not (
                    req.adjust_input_len + req.max_new_tokens() + new_batch_total_tokens
                    < available_size
                ):
                    delta = self.tree_cache.dec_ref_counter(req.last_node)
                    available_size += delta
                else:
                    self.token_to_kv_pool.add_refs(req.prefix_indices)
                    can_run_list.append(req)
                    new_batch_total_tokens += (
                        req.adjust_input_len + req.max_new_tokens()
                    )
                    new_batch_input_tokens += req.adjust_input_len
两个细节决定了 SGLang 调度器的性格:
- 可用空间 = 空闲槽位 + 树上可淘汰的节点,再减去运行中请求"预计还会生成"的 token 数(剩余
max_new_tokens乘以new_token_estimation_ratio,默认 0.4)。也就是说它预估未来,宁可少接请求,也不等 decode 到一半没地方放——这就是今天new_token_ratio的祖先,和 vLLM"先接收、不够再抢占"的思路相反。 - 接纳一个请求时先
inc_ref_counter(req.last_node)把它命中的树节点锁住(不可淘汰),如果锁住之后发现空间反而不够(因为被锁的节点原本算在"可淘汰"里),就立刻解锁放弃。
能进入 batch 的请求交给 forward_fill_batch,结束的请求在 handle_finished_requests 里把自己的 KV 插回基数树(下一章)。
批次:Req、Batch 与三种前向模式
infer_batch.py 定义了请求和批次。ForwardMode 只有三个值:
| python/sglang/srt/managers/router/infer_batch.py @ 22085081bb L10-13 | |
|---|---|
EXTEND 是前缀缓存带来的概念:请求的前 len(prefix_indices) 个 token 已经在缓存里,本次只算剩下的部分。Batch.init_extend_batch 把每个请求的前缀槽位写进 req_to_token 表,再为新增 token 申请槽位:
注意这里的 input_ids = r.input_ids[len(r.prefix_indices):]——送进模型的只有未命中的后缀,seq_lens 是完整长度,prefix_lens 告诉注意力 kernel 前面有多少 KV 要从缓存里读。decode 时 update_for_decode 每个请求申请一个槽位,并且优先尝试申请连续的一段(alloc_contiguous),拿到连续区间就用切片写 KV,否则退回按索引写——一个为了让 KV 写入更快的小优化。
采样也在 Batch.sample 里:温度、logit bias、正则 FSM 的掩码、top-p / top-k,最后 torch.multinomial。所有请求的采样参数都事先拼成张量(temperatures、top_ps……),filter_batch 和 merge 时同步切片或拼接。今天的 ScheduleBatch + SamplingBatchInfo 就是从这里拆出来的。
内存:按 token 分页的两级池
memory_pool.py 只有 111 行,却是今天 mem_cache/ 一百多个文件的源头:
ReqToTokenPool 是请求到槽位的映射表([size, max_context_len] 的 int32 张量),TokenToKVPool 按槽位存每层的 K/V(每层一个 [size, 2, head_num, head_dim]),mem_state 是每个槽位的引用计数。几个决定:
- 页大小为 1。 每个 token 一个槽位,基数树可以在任意位置切开;代价是元数据大、注意力 kernel 要按 token 做间接寻址。直到 2025 年 3 月
Support page size > 1 (#4356)才支持更大的页。 - 分配靠
torch.nonzero。alloc在 GPU 上扫整个mem_state找空位,O(N) 但实现只有五行;后来被 CPU 侧的空闲列表取代(2024-10-02,Move status check in the memory pool to CPU (#1557))。 - 引用计数在池里,不在树里。 树节点的
ref_counter管"节点能否淘汰",池的mem_state管"槽位能否复用",两级各管一层,这个分工保留到今天的TokenToKVPoolAllocator。
池的大小由 ModelRunner.profile_max_num_token 算出:拿可用显存减去 mem_fraction_static 之外的部分,除以每个 token 的 KV 字节数。--mem-fraction-static 这个参数的语义从初版到今天没变。
执行:RadixAttention 与两套 kernel
模型代码里注意力层叫 RadixAttention,它不做任何树操作,只是根据前向模式选 kernel,并把本层的 K/V 写进池:
        from sglang.srt.managers.router.model_runner import global_model_mode

        self.use_flashinfer = "flashinfer" in global_model_mode

        if self.use_flashinfer:
            self.prefill_forward = self.prefill_forward_flashinfer
            self.extend_forward = self.prefill_forward_flashinfer
            self.decode_forward = self.decode_forward_flashinfer
        else:
            self.prefill_forward = self.prefill_forward_triton
            self.extend_forward = self.extend_forward_triton
            self.decode_forward = self.decode_forward_triton
...
    def store_kv_cache(self, cache_k, cache_v, input_metadata: InputMetadata):
        key_buffer = input_metadata.token_to_kv_pool.get_key_buffer(self.layer_id)
        value_buffer = input_metadata.token_to_kv_pool.get_value_buffer(self.layer_id)
        if input_metadata.out_cache_loc is not None:
            key_buffer[input_metadata.out_cache_loc] = cache_k
            value_buffer[input_metadata.out_cache_loc] = cache_v
        elif input_metadata.out_cache_cont_start is not None:
            key_buffer[
                input_metadata.out_cache_cont_start : input_metadata.out_cache_cont_end
            ] = cache_k
            value_buffer[
                input_metadata.out_cache_cont_start : input_metadata.out_cache_cont_end
            ] = cache_v
        else:
            raise RuntimeError()
三种模式对应三个 Triton kernel:context_attention_fwd(无前缀的 prefill)、extend_attention_fwd(带前缀的 extend,q 只有新增部分,k/v 从池里按 req_to_token 读)、token_attention_fwd(decode)。另一条路是 FlashInfer(--model-mode flashinfer),用它的分页 prefill / decode wrapper,页大小仍是 1。两套 kernel并存从第一天就开始了:Triton 版保证任何 GPU 都能跑、方便改,FlashInfer 版更快。今天的 layers/attention/ 下有十几个后端,但"注意力层只选后端、不管缓存"的分工就是这里定下的。
ModelRunner.load_model 用一张手写的表选模型类:
而模型定义本身大量借用 vLLM 的层实现:
并行线性层、RMSNorm、RoPE、词表并行的 embedding、权重加载器、张量并行的进程组初始化,全部 from vllm... import。这是初版最大的"借力":只写自己有创新的部分(调度、缓存、注意力 kernel),其余拿现成的。它的代价要到一年后才显现(第八章)。
多模态:用哈希把图片变成可缓存的前缀
初版就支持 LLaVA,而且和前缀缓存配合得很巧妙。请求带图片时,TokenizerManager 先算出 pixel_values 和图片的哈希,调度器把 prompt 里的 <image> 占位 token 替换成由哈希派生的一串 pad token:
这样同一张图片在 token 序列里总是同一串 id,基数树就能像缓存文本前缀一样缓存图片的 KV(论文里 LLaVA 的命中率就是这么来的)。真正的视觉特征在 extend 前向时按 image_offset 填进对应位置。这个"把不可哈希的输入映射成固定 token 序列"的技巧一直沿用,今天的 multimodal/ 仍用哈希做缓存键。
设计取舍
把初版放在 2024 年 1 月的背景下看,它的取舍很清楚:
| 取舍 | 初版的选择 | 为什么 |
|---|---|---|
| 自研 vs 借用 | 调度、缓存、注意力 kernel 自研;模型层、权重加载、并行通信借 vLLM | 把人力花在论文的创新点上 |
| 页大小 | 1 个 token | 树可以任意切分,命中率最高 |
| 调度 | 预估未来需求、保守接纳,没有抢占 | 实现简单,论文场景里请求长度相近 |
| 进程 | 调度与执行同进程,前后各一个辅助进程 | 避免调度器和 GPU 之间的额外跳转 |
| 通信 | ZMQ + rpyc | 现成、够用;rpyc 半年后被去掉 |
| 流式 | 每 2 步 decode 推一次(stream_interval) |
减少反分词和 HTTP 的开销 |
这些选择里,"调度与执行同进程""两级 KV 池""三类进程"活到了今天,"连做 10 步 decode""rpyc""torch.nonzero 分配""手写模型表"在一年内都被换掉了。
后来怎么样了
把初版的每个文件对应到基准提交 29f6d408c0 里的位置,并比较规模:
REF=${REF:-29f6d408c0}
printf '%-46s %6s\n' '今天的文件' '行数'
for f in python/sglang/srt/entrypoints/http_server.py python/sglang/srt/managers/tokenizer_manager.py python/sglang/srt/managers/scheduler.py \
         python/sglang/srt/managers/schedule_batch.py python/sglang/srt/managers/schedule_policy.py python/sglang/srt/managers/tp_worker.py \
         python/sglang/srt/model_executor/model_runner.py python/sglang/srt/mem_cache/radix_cache.py python/sglang/srt/mem_cache/memory_pool.py \
         python/sglang/srt/layers/radix_attention.py python/sglang/srt/managers/detokenizer_manager.py; do
  printf '%-46s %6d\n' "${f#python/sglang/srt/}" "$(git show "$REF:$f" | wc -l)"
done
今天的文件                                行数
entrypoints/http_server.py                       2942
managers/tokenizer_manager.py                    3944
managers/scheduler.py                            5969
managers/schedule_batch.py                       3993
managers/schedule_policy.py                      1645
managers/tp_worker.py                             746
model_executor/model_runner.py                   2438
mem_cache/radix_cache.py                          823
mem_cache/memory_pool.py                         5966
layers/radix_attention.py                         676
managers/detokenizer_manager.py                   561
| 初版(2024-01) | 今天(2026-10) | 中间的关键提交 |
|---|---|---|
server.py(FastAPI + 启动) |
entrypoints/http_server.py、entrypoints/engine.py |
2025-01-19 建立 entrypoints/,2025-06 OpenAI 服务重写 |
managers/router/manager.py + model_rpc.py |
managers/scheduler.py(近 6000 行)+ tp_worker.py |
#480 静态 DP(2024-05)、#646 去 rpyc(2024-07)、#807 目录重构(2024-07)、#1538 拆出 scheduler.py(2024-09) |
managers/router/infer_batch.py |
managers/schedule_batch.py + model_executor/forward_batch_info.py |
#807、#1543 InputMetadata → ForwardBatch(2024-09-30) |
managers/router/scheduler.py(策略) |
managers/schedule_policy.py |
#1543 改名,2025-01 #2571 重构 |
memory_pool.py |
mem_cache/memory_pool.py + mem_cache/allocator/ |
2024-08-01 建 mem_cache/,#4356 页大小 > 1(2025-03) |
layers/radix_attention.py + 三个 Triton 文件 |
layers/radix_attention.py + layers/attention/ 的十几个后端 |
#1381、#1547 注意力后端抽象(2024-09) |
models/ 3 个 |
models/ 280 多个 |
持续 |
练习
1. 谁在哪个进程。 读 22085081bb 的 server.py、manager.py 和 model_rpc.py 的 ModelRpcClient,画出 --tp-size 2 时一共有几个进程、各自跑什么。
参考答案
主进程(uvicorn + TokenizerManager)、路由进程(RouterManager + ModelRpcClient)、两个模型进程(各一个 ModelRpcServer,rpyc 的 ThreadedServer,exposed_init_model 时各自 init_process_group 加入 NCCL 组)、反分词进程,共 5 个。ModelRpcClient 对 tp_size > 1 用线程池并发地调用每个 rank 的 exposed_step,只取 rank 0 的返回值。
2. 10 步 decode 的消失。 用 git log -S'range(10)' 或 -S'for _ in range(10)' 找到"连做 10 步 decode"被去掉的提交,看看换成了什么。
参考思路
git log --date=short --format='%ad %h %s' -S'for _ in range(10)' -- python/sglang/srt/managers/ 列出引入和删除的提交;读删除那次的 diff,会看到主循环改成每步只做一次前向、靠 --stream-interval 和更细的调度处理新请求,为后来的重叠调度铺路。
3. 槽位分配的演变。 找出 TokenToKVPool.alloc 从 torch.nonzero 改成 CPU 侧空闲列表的提交,比较两种实现的复杂度和每次分配的开销。
参考思路
git log --date=short --format='%ad %h %s' -S'torch.nonzero' -- python/sglang/srt/memory_pool.py python/sglang/srt/mem_cache/memory_pool.py。2024-10-02 的 #1557 把空闲状态搬到 CPU:GPU 上的 nonzero 每次都是一次 kernel 启动加同步,改成 CPU 上维护空闲索引后分配是 O(1) 的切片,并且不再打断 GPU 流。
怎么讲清楚
讲"SGLang 的架构"的时候,用初版的骨架最稳:三类进程(分词、调度 + 执行、反分词)靠 ZMQ 连成环;调度器每步在"组新的 extend batch"和"给运行中的 batch 做 decode"之间选择,准入时预估未来需求;KV 用请求表 + 槽位池两级管理,页大小为 1 以配合基数树;注意力层只负责选 kernel 和写缓存。然后补一句今天的变化(重叠调度、页大小可配、几十个注意力后端),说明你知道它是怎么长的。
小结
- 初版 51 个文件、一万行,运行时 6400 行;三类进程 + ZMQ + rpyc,调度与执行同进程。
- 主循环一步要么组一个 extend batch,要么连做 10 步 decode;准入靠"空闲 + 可淘汰 − 预计还要生成"的估计。
-
EXTEND前向模式、按 token 分页的两级 KV 池、只选 kernel 不管缓存的RadixAttention,都为前缀缓存服务。 - 模型层整体借自 vLLM;图片用哈希映射成固定 token 串,使多模态输入也能命中前缀缓存。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题