多卡并行:把一步摊到几张卡上
视频模型单卡一条 720p 视频要二十多分钟,没有人会等;多卡并行在这里不是提吞吐的手段,而是把**单次生成的延迟**压到能用的程度。扩散模型的并行和 LLM 既像又不像:序列并行(Ulysses、Ring)几乎原样搬过来,张量并行能用但不划算,而 CFG 并行和 PipeFusion 这两种 LLM 没有的方法,恰恰利用了扩散特有的结构——两路前向彼此独立、相邻步的激活高度相似。这一章把每种并行的通信量算出来,在 CPU 上用一个进程模拟 Ulysses 的 all-to-all 验证正确性,再给出 xDiT 这类框架怎么把它们组合、各自在几张卡时划算。
自测:能答上来就可以跳过本章
- 扩散模型为什么要多卡?和 LLM 服务用多卡的目的有什么不同?
- CFG 并行是什么?它的通信量多大?为什么只能到 2 卡?
- Ulysses 和 Ring 两种序列并行各在什么时候通信、通信量怎么算?哪个更适合视频 DiT?
- PipeFusion 利用了什么性质?它和特征缓存的关系是什么?
- 张量并行为什么在 DiT 上不是首选?
自测参考答案(先自己答,再展开对照)
- 为了延迟:一步算力受限,一张卡再快也要几十秒到几十分钟,多卡把一步的计算切开同时做。LLM 服务多卡主要是为了放下模型和提高吞吐(张量并行、流水线),单请求延迟不是第一目标。
- CFG 的有条件、无条件两路只有输入条件不同,彼此独立,放到两张卡上各算一路,每步末尾交换一次输出(一个潜变量大小的张量,几 MB),几乎零通信就拿到接近 2 倍;但只有两路,所以上限 2 卡,再多要和别的并行组合。
- Ulysses:按 token 切,注意力前做 all-to-all 变成按头切(每卡持有全部 token 的一部分头),注意力后再 all-to-all 切回来,每层两次 all-to-all,每次搬 \(N d / P\) 量级;Ring:按 token 切,注意力时把 K、V 块沿环传一圈,每层传 \((P-1)/P\) 份 K、V,和算力重叠。头数够多时 Ulysses 通信少、实现简单;头数少或要上更多卡时用 Ring,两者可以叠(USP)。视频 DiT 通常先 Ulysses(卡数 ≤ 头数),不够再加 Ring。
- 相邻两步的激活高度相似:把图像按 patch 切成几段分到各卡(像流水线),每张卡算自己 patch 的注意力时,其他 patch 的 K、V 用上一步的旧值,这样各卡不用等彼此、异步地流水起来;通信只有每步传一次自己 patch 的 K、V,还能和计算重叠。它和特征缓存同源——都在拿时间维的冗余换计算或通信。
- 张量并行每层要两次 all-reduce(注意力后、MLP 后),通信量和 token 数成正比,视频模型十万 token 时每层几百 MB,而且 all-reduce 不能和计算重叠;序列并行的通信量只和 \(N d / P\) 相关、能重叠。张量并行的优势是切分权重省显存,对 12~14B 的 DiT 没那么必要。
先看一个六格小剧场,再读正文:
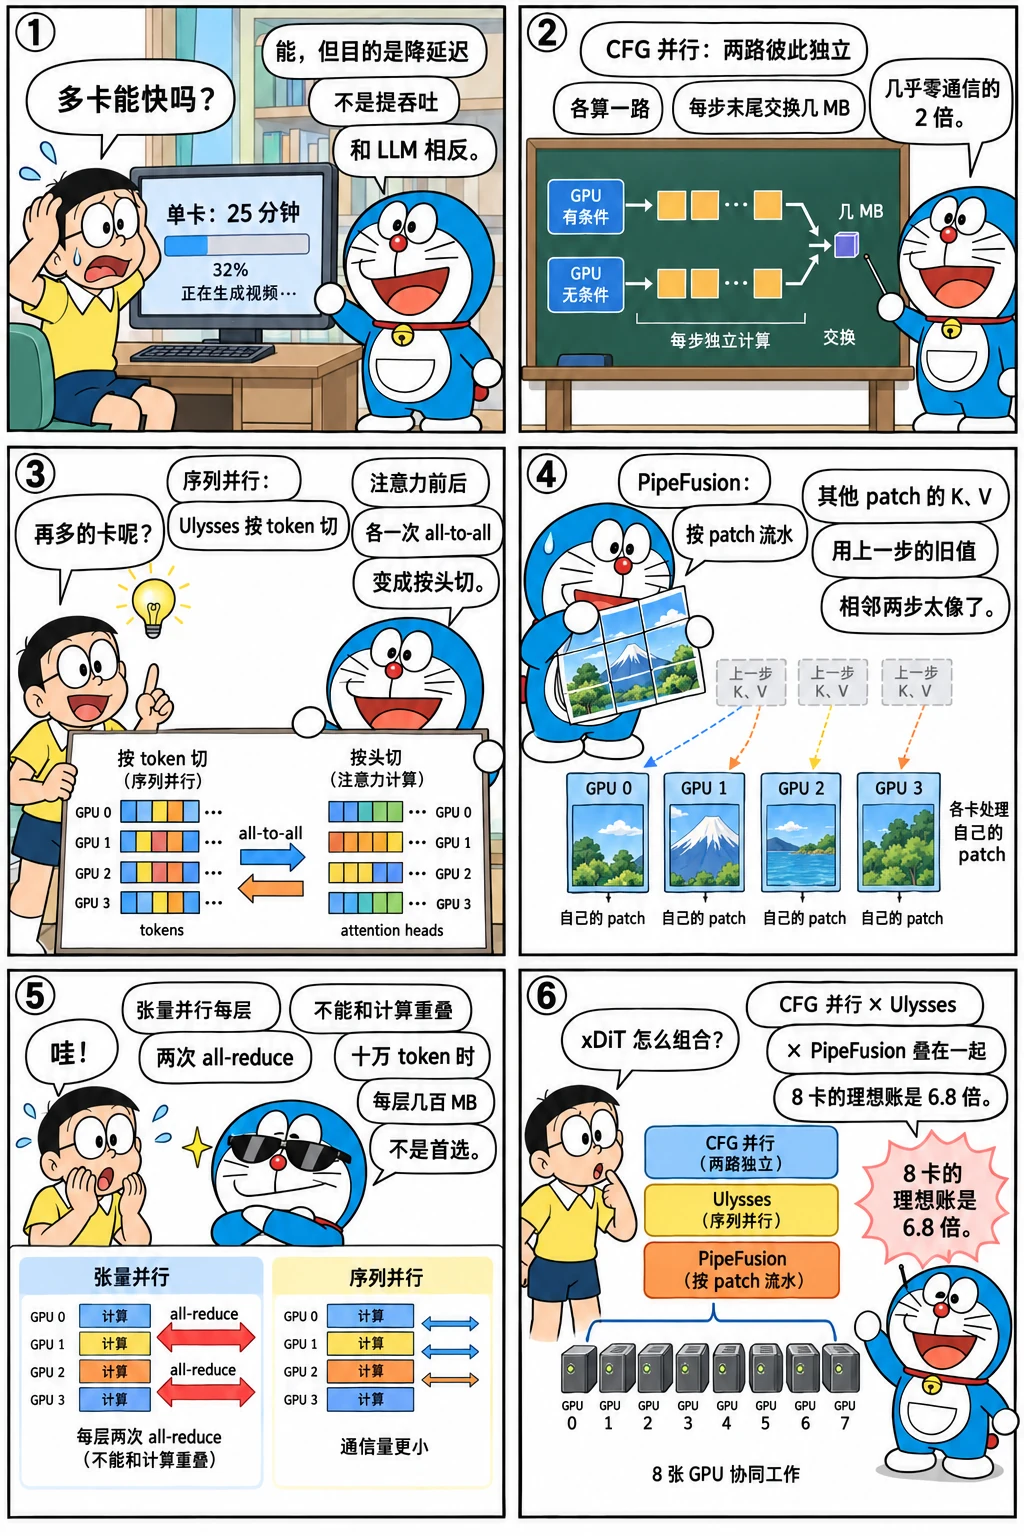
为什么要并行:延迟,不是吞吐
算账一章的结论:一步算力受限,batch 不能分摊成本。所以多卡的目的只有一个——把一次生成的延迟压下来。目标很明确:视频从 25 分钟到 3 分钟,图像从 5 秒到 1 秒。
能切的维度有五个:
| 并行 | 切什么 | 通信 | 上限 | 备注 |
|---|---|---|---|---|
| 数据并行 | 不同请求 | 无 | 卡数 | 只提吞吐,不降延迟 |
| CFG 并行 | 有条件 / 无条件两路 | 每步交换一次输出 | 2 | 几乎免费,先用 |
| 序列并行(Ulysses / Ring) | token | 每层 all-to-all 或环传 K、V | 头数 / 任意 | 视频模型的主力 |
| PipeFusion | patch + 时间步 | 每步传自己 patch 的 K、V | patch 数 | 用旧激活,异步流水 |
| 张量并行 | 权重的行 / 列 | 每层两次 all-reduce | 头数 | 省显存;DiT 上通信偏重 |
此外还有两件不在"去噪网络"里的并行:VAE 按 patch 并行解码(视频必需),文本编码器放到单独的卡上。
CFG 并行:最便宜的 2 倍
CFG 的两路前向除了条件不同完全一样,而且彼此不依赖——直到每步末尾做外推时才需要两路的输出。两张卡各算一路,每步交换一次输出:
import torch

def cfg_parallel_cost(latent_shape, steps, dtype_bytes=2):
    numel = 1
    for s in latent_shape:
        numel *= s
    per_step = numel * dtype_bytes                  # 每步每张卡发出自己那一路的预测
    return per_step, per_step * steps

for name, shape, steps in [("FLUX 1024²", (16, 128, 128), 28), ("Wan 720p 81 帧", (16, 21, 90, 160), 50)]:
    per, total = cfg_parallel_cost(shape, steps)
    print(f"{name:<16} 每步交换 {per / 2 ** 20:>6.1f} MB,整次生成 {total / 2 ** 20:>7.1f} MB——NVLink 上几乎可以忽略")
FLUX 1024²       每步交换    0.5 MB,整次生成    14.0 MB——NVLink 上几乎可以忽略
Wan 720p 81 帧    每步交换    9.2 MB,整次生成   461.4 MB——NVLink 上几乎可以忽略
代价是 2 张卡都要放下完整的模型,收益接近 2 倍,实现只有几十行。它的上限也很明确:只有两路,所以总是和别的并行组合着用:8 张卡 = CFG 2 × 序列并行 4。
序列并行:Ulysses 与 Ring
DiT 的主体和 LLM 的 Transformer 块相同,所以上下文并行那一章的 Ulysses 和 Ring Attention 原样可用。token 按卡切开,线性层和 MLP 天然各算各的(它们对每个 token 独立),只有注意力需要看到全部 token——两种方法在注意力这一步分别怎么做:
Ulysses:注意力前做一次 all-to-all,把"每卡持有全部头的一段 token"变成"每卡持有一部分头的全部 token",各卡独立算自己那几个头的完整注意力,再 all-to-all 换回来。用一个进程模拟 4 张卡,验证结果和不切完全一致:
import torch.nn.functional as F

torch.manual_seed(0)
B, H, N, D, P = 1, 8, 256, 32, 4                      # 8 个头、256 个 token、4 张"卡"
q, k, v = (torch.randn(B, H, N, D) for _ in range(3))
ref = F.scaled_dot_product_attention(q, k, v)

# 切 token:第 r 张卡持有 token [r*N/P, (r+1)*N/P) 的全部头
shards = [(q[:, :, r * N // P:(r + 1) * N // P], k[:, :, r * N // P:(r + 1) * N // P], v[:, :, r * N // P:(r + 1) * N // P]) for r in range(P)]

def all_to_all_heads(tensors):
    """all-to-all:输入每卡 [B, H, N/P, D](按 token 切),输出每卡 [B, H/P, N, D](按头切)"""
    out = []
    for r in range(P):                                 # 第 r 张卡收集所有卡上第 r 组头的 token 段,按 token 拼起来
        out.append(torch.cat([t[:, r * H // P:(r + 1) * H // P] for t in tensors], dim=2))
    return out

qh, kh, vh = (all_to_all_heads([s[i] for s in shards]) for i in range(3))
local_out = [F.scaled_dot_product_attention(qh[r], kh[r], vh[r]) for r in range(P)]   # 各卡:自己的头、全部 token

def all_to_all_tokens(tensors):                        # 换回来:每卡 [B, H/P, N, D] → [B, H, N/P, D]
    return [torch.cat([t[:, :, r * N // P:(r + 1) * N // P] for t in tensors], dim=1) for r in range(P)]

back = all_to_all_tokens(local_out)
full = torch.cat(back, dim=2)
print(f"Ulysses(4 卡模拟)和不切的结果一致:{torch.allclose(full, ref, atol=1e-5)}")
sent = sum(t.numel() for t in [s[i] for s in shards for i in range(3)]) * 2 * (P - 1) / P   # 每卡发出去的那 (P-1)/P 份
print(f"每层每卡发送约 {sent / P / 2 ** 10:.0f} KB(QKV 三个张量各 (P−1)/P 份),注意力后再发一次输出")
Ring:token 切法相同,但注意力时不交换头,而是把 K、V 块沿环传一圈,每收到一块就算一次局部注意力、用 log-sum-exp 合并(和 FlashAttention 的 online softmax 同一个公式,训练手册的上下文并行有可运行的实现)。它的通信能和计算重叠,而且不受头数限制。
把两者的每层通信量写出来,代入 FLUX 和 Wan:
def seq_parallel_comm(N, d, P, dtype=2):
    """每层每卡要发送的字节数"""
    ulysses = 2 * 4 * (N * d * dtype) * (P - 1) / P / P   # 两次 all-to-all,各搬 QKV(3)+O(1) 中自己要发出去的部分
    ring = 2 * (N * d * dtype) * (P - 1) / P              # K、V 各一份,绕环传 P−1 次,每次传 1/P
    return ulysses, ring

NVLINK = 300e9                                            # H100 NVLink 单卡双向约 900 GB/s,这里按单向有效 300 GB/s 估
print(f"{'模型 / 卡数':<22} {'Ulysses 每层':>12} {'Ring 每层':>10} {'Ulysses 每步(57/40 层)':>20} {'通信时间':>8}")
for name, N, d, L in [("FLUX 1024²", 4608, 3072, 57), ("Wan 720p 81 帧", 76112, 5120, 40)]:
    for P in (2, 4, 8):
        u, r = seq_parallel_comm(N, d, P)
        print(f"{name + ' / ' + str(P) + ' 卡':<22} {u / 2 ** 20:>9.1f} MB {r / 2 ** 20:>7.1f} MB {u * L / 2 ** 20:>17.0f} MB {u * L / NVLINK * 1e3:>6.1f} ms")
模型 / 卡数                  Ulysses 每层    Ring 每层  Ulysses 每步(57/40 层)     通信时间
FLUX 1024² / 2 卡            54.0 MB    27.0 MB              3078 MB   10.8 ms
FLUX 1024² / 4 卡            40.5 MB    40.5 MB              2308 MB    8.1 ms
FLUX 1024² / 8 卡            23.6 MB    47.2 MB              1347 MB    4.7 ms
Wan 720p 81 帧 / 2 卡       1486.6 MB   743.3 MB             59462 MB  207.8 ms
Wan 720p 81 帧 / 4 卡       1114.9 MB  1114.9 MB             44597 MB  155.9 ms
Wan 720p 81 帧 / 8 卡        650.4 MB  1300.7 MB             26015 MB   90.9 ms
对比一步的计算时间(FLUX 在 H100 上约 170 ms,Wan 约 15 s):Ulysses 每步的通信在 FLUX 上是几毫秒、在 Wan 上是百毫秒量级,都远小于计算——序列并行在 NVLink 内是划算的。Ring 的通信量看着更大,但它和计算完全重叠,所以实际开销常常更低;代价是实现复杂、小块的注意力效率略低。
选择的经验:头数够(FLUX 24 头、Wan 40 头)且卡数 ≤ 头数时先用 Ulysses;要跨机器或者卡数更多时用 Ring,或者两者叠加(Ulysses 在机内、Ring 在机间,xDiT 叫 USP)。
PipeFusion:用旧激活换掉同步
序列并行每一层都要同步一次。PipeFusion 走了另一条路:把图像按 patch 切成 \(P\) 段分到 \(P\) 张卡上,像流水线一样一张卡算完一段就把它传给下一张;关键的一步是——计算某个 patch 的注意力时,其他 patch 的 K、V 用上一个时间步的旧值。这样各卡不必等彼此,整个去噪过程异步地流水起来,每步的通信只有自己 patch 的 K、V,还能和计算重叠。
它成立的前提和特征缓存完全相同:相邻两步的激活高度相似。所以它的误差性质也一样:首尾几步要"预热"(全同步算),中间用旧值。用一个数字看它的通信优势:
def pipefusion_comm(N, d, L, P, dtype=2):
    """每步每卡:把自己 patch 的 K、V 发给其他卡,一共 L 层"""
    return L * 2 * (N / P) * d * dtype

for name, N, d, L in [("FLUX 1024²", 4608, 3072, 57), ("Wan 720p 81 帧", 76112, 5120, 40)]:
    for P in (4, 8):
        u, _ = seq_parallel_comm(N, d, P)
        print(f"{name:<16} {P} 卡:PipeFusion 每步每卡发 {pipefusion_comm(N, d, L, P) / 2 ** 20:>7.0f} MB,"
              f"Ulysses 每步 {u * L / 2 ** 20:>6.0f} MB,但 PipeFusion 不需要每层同步、可以跨 PCIe 机器")
FLUX 1024²       4 卡:PipeFusion 每步每卡发     770 MB,Ulysses 每步   2308 MB,但 PipeFusion 不需要每层同步、可以跨 PCIe 机器
FLUX 1024²       8 卡:PipeFusion 每步每卡发     385 MB,Ulysses 每步   1347 MB,但 PipeFusion 不需要每层同步、可以跨 PCIe 机器
Wan 720p 81 帧    4 卡:PipeFusion 每步每卡发   14866 MB,Ulysses 每步  44597 MB,但 PipeFusion 不需要每层同步、可以跨 PCIe 机器
Wan 720p 81 帧    8 卡:PipeFusion 每步每卡发    7433 MB,Ulysses 每步  26015 MB,但 PipeFusion 不需要每层同步、可以跨 PCIe 机器
PipeFusion 的通信量比 Ulysses 少两三倍,但它更大的价值在于没有每层的同步点:跨 PCIe、跨机器、带宽差的环境下,序列并行会被每层的 all-to-all 卡住,PipeFusion 仍能流水。代价是旧激活带来的误差(和缓存同样要控制),以及流水线的预热。
张量并行:能用,但不是首选
张量并行把每个线性层的权重按列或行切到各卡(见张量并行),注意力后和 MLP 后各一次 all-reduce。通信量:
def tp_comm(N, d, L, P, dtype=2):
    return L * 2 * 2 * (N * d * dtype) * (P - 1) / P      # 每层两次 all-reduce,环形实现每卡发 2(P−1)/P 份

for name, N, d, L in [("FLUX 1024²", 4608, 3072, 57), ("Wan 720p 81 帧", 76112, 5120, 40)]:
    u, _ = seq_parallel_comm(N, d, 4)
    print(f"{name:<16} 4 卡:张量并行每步每卡 {tp_comm(N, d, L, 4) / 2 ** 20:>7.0f} MB(不能与计算重叠),Ulysses {u * L / 2 ** 20:>6.0f} MB")
FLUX 1024²       4 卡:张量并行每步每卡    4617 MB(不能与计算重叠),Ulysses   2308 MB
Wan 720p 81 帧    4 卡:张量并行每步每卡   89194 MB(不能与计算重叠),Ulysses  44597 MB
张量并行的通信和 token 数成正比、每层两次、而且不能和计算重叠——比 Ulysses 多一倍,实际开销差得更多。它的优势是切分权重:14B 的模型切到 4 卡每卡只放 7 GB;但 DiT 的权重本来就放得下(最大也就二三十 GB),这个优势用不上。所以 xDiT 这类框架把张量并行放在最后:序列并行和 CFG 并行用完了、卡还有富余、或者单卡确实放不下权重时才用。
组合:xDiT 的做法
真实部署里这些并行是叠起来的。以 8 张 H100 跑 Wan 2.1-14B 720p 为例:
| 配置 | 说明 | 单条视频延迟(估) |
|---|---|---|
| 1 卡 | 25 分钟 | 基准 |
| CFG 2 | 两路分开 | ≈ 13 分钟 |
| CFG 2 × Ulysses 4 | 8 卡,每卡 1/4 的 token、一路 CFG | ≈ 3.5 分钟 |
| CFG 2 × Ulysses 4 + TeaCache | 再加缓存 | ≈ 2 分钟 |
| CFG 2 × Ulysses 4 + TeaCache + FP8 | 再加低精度 | ≈ 1.5 分钟 |
加速不是线性的:并行有通信和负载不均(文本 token 不好切、patch 边界),缓存有质量代价。各家公开的数字大致是 8 卡 6~7 倍,再叠缓存和量化到 10 倍以上。
xDiT(xDiT / xFuserd)是把这些组合做成配置的框架:--ulysses_degree 4 --ring_degree 2 --use_cfg_parallel --pipefusion_parallel_degree 2,各并行组的乘积等于卡数。它的设计正好是这一章的顺序:先 CFG,再序列并行,机间用 Ring 或 PipeFusion,张量并行垫底。SGLang Diffusion、vLLM-Omni 这些后来的框架也是同一套组合。
怎么讲清楚
讲"视频生成怎么用多卡",先说目的:降延迟不是提吞吐,单卡 25 分钟没法用。再按通信量讲:CFG 并行每步只交换一个潜变量、几乎免费但上限 2 卡;序列并行把 token 切开,线性层各算各的,只有注意力要通信——Ulysses 每层两次 all-to-all(搬 \(Nd/P\) 量级)、Ring 把 K、V 绕环传并和计算重叠,NVLink 内每步的通信远小于计算;PipeFusion 用上一步的 K、V 换掉每层同步,适合跨机器;张量并行每层两次 all-reduce 不能重叠、通信比序列并行多一倍,只在要切权重时用。最后给组合:8 卡 = CFG 2 × Ulysses 4,再叠缓存和 FP8,Wan 从 25 分钟到 2 分钟以内。
练习
- 把 Ulysses 模拟里的
P改成 16(超过头数 8)会发生什么?真实系统里怎么处理?
参考答案
H // P 为 0,按头切分不出来——Ulysses 的并行度不能超过头数(更准确地说,头数要能被并行度整除)。超过时要么用 Ring(不受头数限制),要么 Ulysses × Ring 叠加(USP),比如 16 卡 = Ulysses 8 × Ring 2。
- 用本章的函数算:Wan 720p 在 8 张 PCIe 4.0(每卡约 25 GB/s)互联的卡上,Ulysses 每步的通信时间是多少?和一步的计算(约 15 s / 8)比如何?PipeFusion 会更好吗?
参考答案
Ulysses 8 卡每步约 1.6 GB,PCIe 4.0 上约 65 ms,而每卡的计算约 2 秒,通信占 3%——即使 PCIe 也能接受,因为视频模型的计算实在太重。PipeFusion 在这里的优势不在带宽而在没有同步点:8 张卡的 all-to-all 要等最慢的卡,PCIe 拓扑不均匀时等待会放大;但它引入旧激活误差。带宽够的话优先序列并行。
- 某团队用张量并行 4 卡跑 FLUX,发现比单卡只快 1.8 倍。按本章的账,瓶颈在哪?换成什么配置更好?
参考答案
张量并行每层两次 all-reduce(FLUX 57 层、每步一百多次),每次都是同步点、不能和计算重叠,加上 kernel 变小效率下降,4 卡只得 1.8 倍很常见。换成 CFG 并行 ×2(FLUX.1-dev 已经没有 CFG,那就不适用)或 Ulysses 4:每层只有两次 all-to-all、搬的数据量更少,通常能到 3 倍以上;再加 CUDA Graph 和编译把小 kernel 的开销压掉。
小结
- 扩散模型多卡是为了降延迟:一步算力受限,batch 分摊不了成本;视频单卡 25 分钟必须切开算。
- CFG 并行几乎免费但只到 2 卡;序列并行(Ulysses 每层两次 all-to-all、Ring 环传 K、V 并与计算重叠)是视频模型的主力,NVLink 内通信远小于计算。
- PipeFusion 用上一步的 K、V 换掉每层同步,适合跨机器,误差性质和特征缓存相同;张量并行通信多一倍且不能重叠,只在要切权重时用。
- 真实部署是组合:8 卡 = CFG 2 × Ulysses 4,再叠缓存和 FP8;各家公开的加速在 8 卡 6~7 倍、叠加后 10 倍以上。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题