显存与 offload:把 FLUX 塞进 16 GB
FLUX.1-dev 的去噪网络 bf16 权重 24 GB,再加 T5 的 9.5 GB,一张 24 GB 的卡都放不下,更别说 16 GB——但它们都能在这些卡上跑,靠的是 offload、量化和分块。这一章先把扩散模型的显存账本算清楚(权重、激活、VAE 峰值各占多少),再量化每种 offload 策略要付出的时间:按组件卸载、按层卸载、分组预取各自要在 PCIe 上搬多少字节、拖慢多少。读完能回答"这张卡、这个模型、这个分辨率,用哪种策略"。
自测:能答上来就可以跳过本章
- 扩散模型推理时显存由哪几部分组成?和 LLM 推理最大的差别是什么?
- 模型卸载(model offload)和逐层卸载(sequential offload)各在什么时候把什么搬到哪里?代价分别有多大?
- 为什么逐层卸载会把一步拖慢几倍?怎么用预取把它藏起来?
- FP8 和 NF4 的权重各占多少显存?它们对速度有什么影响?
- 一张 16 GB 的卡跑 FLUX.1-dev,你会怎么配?
自测参考答案(先自己答,再展开对照)
- 权重(去噪网络 + 文本编码器 + VAE)、去噪网络一步的激活、VAE 解码的激活峰值、CUDA 上下文和分配器碎片。和 LLM 最大的差别是没有 KV Cache——显存不随请求数和序列长度持续增长,一步的激活用完即释放,所以显存规划是"静态"的。
- 模型卸载:整个组件(T5、去噪网络、VAE)在用到时搬进 GPU、用完搬回 CPU,一次生成每个组件各搬一次,代价是每张图多几秒;逐层卸载:去噪网络只常驻一层,每层算完换下一层,一步要把全部权重搬一遍,代价是每一步多搬几十 GB。
- 一步搬 24 GB 权重,PCIe 4.0 x16 约 25 GB/s,光搬运就一秒,而计算只要零点几秒,GPU 大部分时间在等数据。预取:用另一个 CUDA stream 在算第 \(i\) 层时把第 \(i+1\) 层搬进来,搬运和计算重叠;只要搬一层的时间不超过算一层的时间,拖慢就能藏掉大半——这要求 CPU 内存是锁页的、搬运走 DMA。
- FP8 把 12B 参数压到 12 GB,NF4 约 6.5 GB。FP8 在 Hopper / Ada 以上的卡上矩阵乘本身更快(有 FP8 Tensor Core);NF4 要先反量化成 bf16 再算,权重读取少了但计算没少,扩散模型本来就是算力受限的,所以 NF4 通常更慢,它换来的只是"放得下"。
- 去噪网络用 FP8 或 NF4(12 GB 或 6.5 GB),T5 用 FP8 / NF4 或者编码完就卸载到 CPU,VAE 开分块解码,剩下的给激活。不够再对去噪网络做分组卸载并开预取。
先看一个六格小剧场,再读正文:
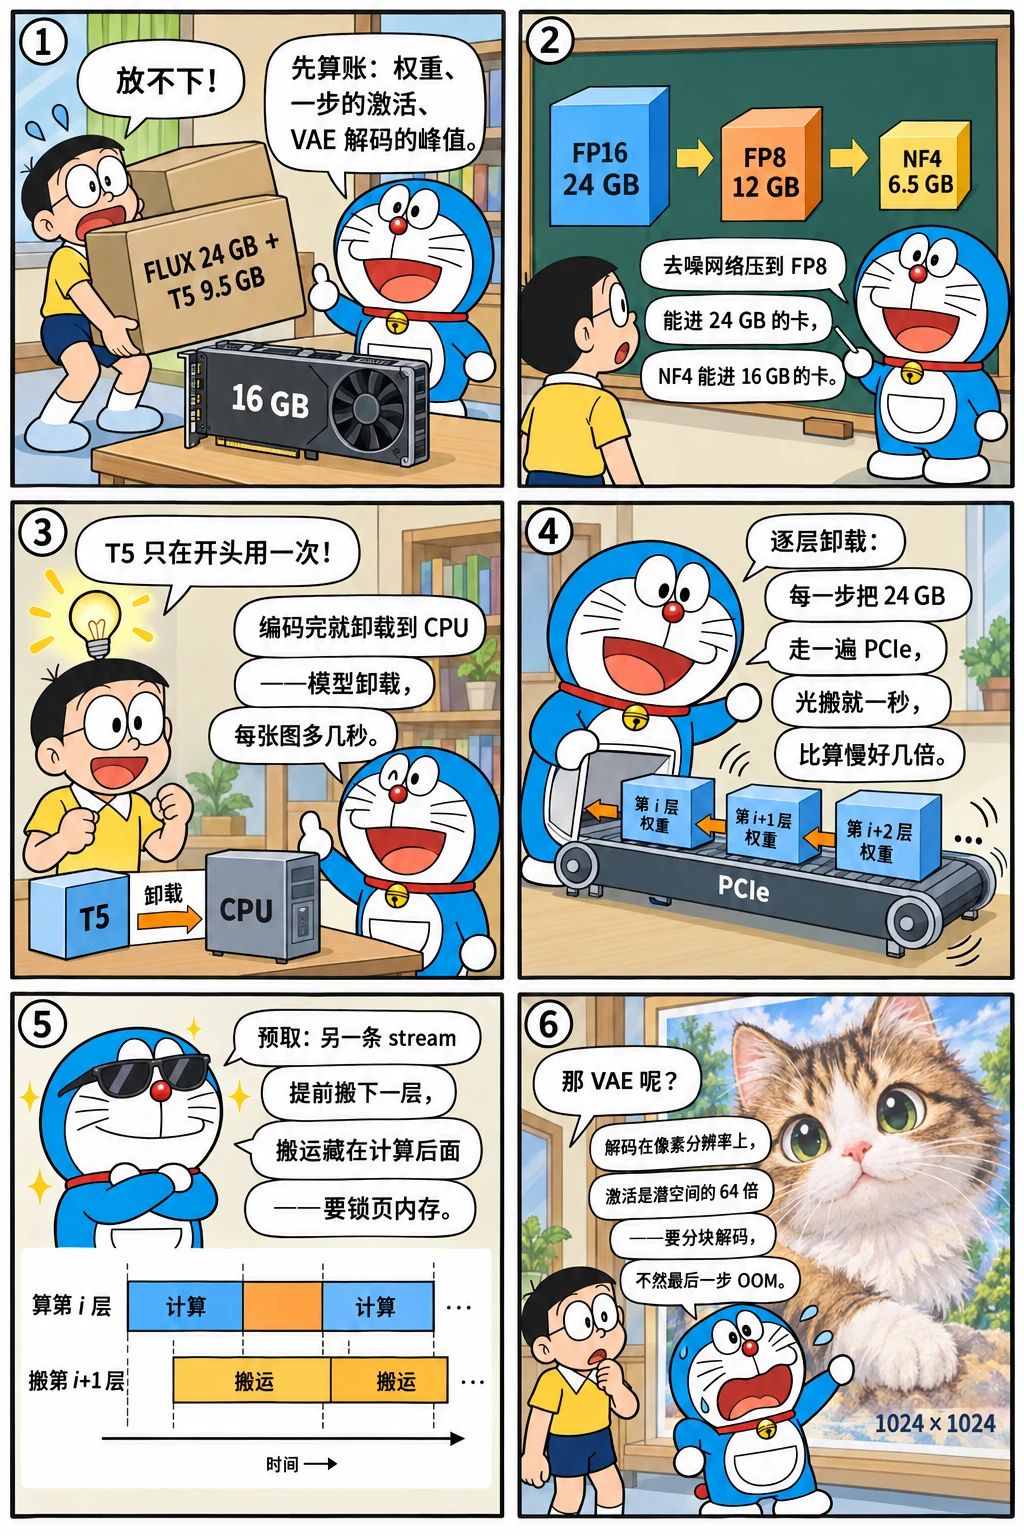
显存账本
把一次生成的显存分成四块:
| 部分 | 大小 | 什么时候占用 |
|---|---|---|
| 去噪网络权重 | 参数量 × 每参数字节数 | 整个去噪过程 |
| 文本编码器权重 | 同上,T5-XXL 是大头 | 只在编码时需要 |
| VAE 权重 | 很小(84M~几百 M) | 只在解码时需要 |
| 去噪网络一步的激活 | ∝ token 数 × 隐藏维,FlashAttention 下不含 \(N^2\) 的注意力矩阵 | 每一步,用完释放 |
| VAE 解码的激活 | ∝ 像素数 × 通道数,常常是峰值 | 只在解码时 |
| CUDA 上下文、分配器碎片 | 1~2 GB | 常驻 |
用公式把主流模型在不同精度下算一遍:
GB = 1024 ** 3
MODELS = {
    # 名字: (去噪网络参数 B, 文本编码器参数 B, VAE 参数 B, 隐藏维, token 数(含文本), 层数)
    "SDXL 1024²":          (2.6, 0.82, 0.08, 1280, 4096, 0),
    "FLUX.1-dev 1024²":    (11.9, 4.9, 0.08, 3072, 4608, 57),
    "Wan 2.1-14B 720p":    (14.0, 5.7, 0.13, 5120, 76112, 40),
    "HunyuanVideo 720p":   (12.7, 8.6, 0.25, 3072, 119056, 60),
}
BYTES = {"bf16": 2, "fp8": 1, "nf4": 0.5625}            # NF4 按 4 bit + 分组缩放因子约 4.5 bit

def activation_peak(d, n, layers, dtype_bytes=2):
    """一步里同时活着的激活:残差流 + 一层里的几份中间结果(QKV、MLP 的 4d 升维);FlashAttention 不落地 N×N 矩阵"""
    per_layer = n * (d + 3 * d + 4 * d) * dtype_bytes   # 残差 + QKV + MLP 中间
    return per_layer * 2                                 # 粗略:两份在飞(当前层 + 残差备份)

print(f"{'模型':<20} {'精度':<5} {'去噪权重':>8} {'文本编码器':>9} {'一步激活':>8} {'合计(含 1.5GB 开销)':>18}")
for name, (p_dn, p_te, p_vae, d, n, L) in MODELS.items():
    for dtype in ("bf16", "fp8", "nf4"):
        w_dn = p_dn * 1e9 * BYTES[dtype]
        w_te = p_te * 1e9 * BYTES[dtype]
        act = activation_peak(d, n, L)
        total = w_dn + w_te + p_vae * 1e9 * 2 + act + 1.5 * GB
        print(f"{name:<20} {dtype:<5} {w_dn / GB:>6.1f} GB {w_te / GB:>7.1f} GB {act / GB:>6.1f} GB {total / GB:>16.1f} GB")
模型                   精度        去噪权重     文本编码器     一步激活     合计(含 1.5GB 开销)
SDXL 1024²           bf16     4.8 GB     1.5 GB    0.2 GB              8.2 GB
SDXL 1024²           fp8      2.4 GB     0.8 GB    0.2 GB              5.0 GB
SDXL 1024²           nf4      1.4 GB     0.4 GB    0.2 GB              3.6 GB
FLUX.1-dev 1024²     bf16    22.2 GB     9.1 GB    0.4 GB             33.4 GB
FLUX.1-dev 1024²     fp8     11.1 GB     4.6 GB    0.4 GB             17.7 GB
FLUX.1-dev 1024²     nf4      6.2 GB     2.6 GB    0.4 GB             10.9 GB
Wan 2.1-14B 720p     bf16    26.1 GB    10.6 GB   11.6 GB             50.1 GB
Wan 2.1-14B 720p     fp8     13.0 GB     5.3 GB   11.6 GB             31.7 GB
Wan 2.1-14B 720p     nf4      7.3 GB     3.0 GB   11.6 GB             23.7 GB
HunyuanVideo 720p    bf16    23.7 GB    16.0 GB   10.9 GB             52.5 GB
HunyuanVideo 720p    fp8     11.8 GB     8.0 GB   10.9 GB             32.7 GB
HunyuanVideo 720p    nf4      6.7 GB     4.5 GB   10.9 GB             24.0 GB
三个读数:
- FLUX 的权重是硬门槛:bf16 下去噪网络加 T5 就 33 GB,24 GB 的卡放不下;FP8 降到 17 GB,刚好能进 24 GB;NF4 降到 9 GB,16 GB 的卡也能跑。
- 图像模型的激活可以忽略,视频模型的激活不能:Wan 720p 一步的激活按这个粗估就有十几 GB——它和 token 数成正比,而视频的 token 数是图像的 16 倍以上。视频模型的"放不下"常常是激活而不是权重。
- 文本编码器是"临时住户":只在开始时用一次,之后它占的显存全是浪费——这是模型卸载最先要搬走的对象。
LLM 的显存账本在这里不适用
LLM 推理里显存的大头是 KV Cache,它随并发请求数和序列长度增长,所以要分页、要抢占、要算"能服务多少并发"。扩散模型没有这一项:一步的激活用完即释放,并发请求之间不共享状态,显存规划是静态的——放得下就放得下,放不下靠的是本章的手段,而不是调度。
三种 offload:各搬多少、拖慢多少
把放不下的部分放到 CPU 内存,用的时候再搬进来。关键是算清楚每次生成要在 PCIe 上搬多少字节:
PCIE = {"PCIe 4.0 x16": 25e9, "PCIe 5.0 x16": 50e9}     # 实际可用带宽,字节/秒(标称的 ~80%)

def offload_cost(w_dn, w_te, steps, compute_per_step, bw):
    """三种策略:每次生成搬运的字节数与额外时间"""
    model = w_te * 2 + w_dn * 2                          # 模型卸载:每个组件搬进来一次、搬出去一次
    seq = w_te + w_dn * steps                            # 逐层卸载:去噪网络每一步都要把全部权重搬一遍
    return {"模型卸载(按组件)": (model, model / bw),
            "逐层卸载(无预取)": (seq, seq / bw),
            "逐层卸载 + 预取": (seq, max(0.0, seq / bw - steps * compute_per_step))}   # 搬运藏在计算后面

w_dn, w_te = 11.9e9 * 2, 4.9e9 * 2                       # FLUX bf16
steps, t_step = 28, 0.17                                 # H100 上一步约 0.17 s(见上一章)
print(f"FLUX.1-dev bf16,28 步,一步计算约 {t_step} s,纯计算 {steps * t_step:.1f} s")
for bus, bw in PCIE.items():
    print(f"  {bus}")
    for name, (nbytes, extra) in offload_cost(w_dn, w_te, steps, t_step, bw).items():
        print(f"    {name:<14} 搬运 {nbytes / 1e9:>6.0f} GB   额外 {extra:>6.1f} s   一张图 {steps * t_step + extra:>6.1f} s")
FLUX.1-dev bf16,28 步,一步计算约 0.17 s,纯计算 4.8 s
  PCIe 4.0 x16
    模型卸载(按组件)      搬运     67 GB   额外    2.7 s   一张图    7.4 s
    逐层卸载(无预取)      搬运    676 GB   额外   27.0 s   一张图   31.8 s
    逐层卸载 + 预取      搬运    676 GB   额外   22.3 s   一张图   27.0 s
  PCIe 5.0 x16
    模型卸载(按组件)      搬运     67 GB   额外    1.3 s   一张图    6.1 s
    逐层卸载(无预取)      搬运    676 GB   额外   13.5 s   一张图   18.3 s
    逐层卸载 + 预取      搬运    676 GB   额外    8.8 s   一张图   13.5 s
- 模型卸载:一次生成搬几十 GB,多两三秒。对交互式出图可以接受,对吞吐型服务不行——但它只要求 CPU 内存放得下,几乎没有工程风险,是 diffusers
enable_model_cpu_offload()的默认做法。 - 逐层卸载:每一步都把 24 GB 权重走一遍 PCIe,28 步就是 670 GB,光搬运 27 秒,比计算慢 5 倍。
enable_sequential_cpu_offload()能让 FLUX 在 8 GB 的卡上跑,代价就是这个。 - 逐层卸载 + 预取:用另一条 CUDA stream 在算第 \(i\) 层时搬第 \(i+1\) 层。只要"搬一层"不慢于"算一层",搬运就全部藏在计算后面。FLUX 一层约 420 MB,PCIe 4.0 上 17 ms;一层计算在 H100 上约 3 ms——藏不住,所以上面的"预取"行仍然有二十多秒的额外时间。换成 4090(一层算约 18 ms)就差不多能藏住了。预取的前提是 CPU 内存锁页(pinned),否则 DMA 走不了,带宽掉一半以上(见锁页内存、DMA 与 NUMA)。
一个常被忽略的变量是显存带宽和 PCIe 带宽的差距:H100 的 HBM 3.35 TB/s,PCIe 4.0 只有 25 GB/s,差 130 倍。所以"卸载到 CPU"永远是不得已的选择,而不是优化手段;它的正确用法是搬走用过就不再用的东西(文本编码器)和冷的东西(不常用的 LoRA、ControlNet)。
换模型、换卡、换总线,看三种卸载各要多付多少秒:
分组卸载:在两者之间
diffusers 的 group offloading 把"按组件"和"按层"折中:把去噪网络按若干层分成组,一组常驻、其余在 CPU,并用 stream 预取下一组。组越大,预取越容易藏住(一组的计算时间更长),但常驻的显存越多:
layers, per_layer_bytes, t_layer = 57, 11.9e9 * 2 / 57, 0.17 / 57       # FLUX 在 H100 上
bw = 25e9
print(f"{'每组层数':>6} {'常驻显存':>8} {'搬一组':>8} {'算一组':>8}  能否藏住")
for g in (1, 4, 8, 19, 57):
    resident = g * per_layer_bytes * 2                                   # 当前组 + 预取中的下一组
    t_move, t_comp = g * per_layer_bytes / bw, g * t_layer
    print(f"{g:>6} {resident / GB:>6.1f} GB {t_move * 1e3:>6.0f} ms {t_comp * 1e3:>6.0f} ms  {'能' if t_move <= t_comp else '不能'}")
print("H100 算得太快,哪种分组都藏不住搬运;慢一些的卡反而能藏住——卸载是给消费级卡准备的手段")
  每组层数     常驻显存      搬一组      算一组  能否藏住
     1    0.8 GB     17 ms      3 ms  不能
     4    3.1 GB     67 ms     12 ms  不能
     8    6.2 GB    134 ms     24 ms  不能
    19   14.8 GB    317 ms     57 ms  不能
    57   44.3 GB    952 ms    170 ms  不能
H100 算得太快,哪种分组都藏不住搬运;慢一些的卡反而能藏住——卸载是给消费级卡准备的手段
权重精度:FP8 与 NF4
量化在量化一章里细讲,这里只看显存和速度的粗账:
| 精度 | FLUX 去噪网络 | 速度(相对 bf16) | 质量 | 适合 |
|---|---|---|---|---|
| bf16 | 24 GB | 1× | 原始 | 48 GB 以上 |
| FP8(e4m3,按张量或按块缩放) | 12 GB | Hopper / Ada 以上约 1.2~1.6×;老卡退回 bf16 计算只省显存 | 几乎无损 | 24 GB |
| NF4 / INT4 权重量化 | 6.5 GB | 0.6~0.9×(反量化开销) | 轻微损失 | 16 GB 以下,"能跑就行" |
| SVDQuant(W4A4 + 低秩补偿) | 6.5 GB | 2~3× | 接近无损 | 需要专门 kernel(Nunchaku) |
记住一条:权重量化在扩散模型里首先是显存手段。一步是算力受限的,只把权重变小不会让矩阵乘变快;要提速得让计算本身在低精度上做(FP8 Tensor Core、W4A4 kernel)。
一张 16 GB 的卡怎么配
把本章的账合起来,给 RTX 5070 Ti / 4080 这类 16 GB 的卡配 FLUX.1-dev:
BUDGET = 16 * GB - 1.5 * GB                              # 扣掉上下文和碎片
plans = [
    ("bf16 全部常驻",                 11.9e9 * 2 + 4.9e9 * 2 + 0.08e9 * 2, 0),
    ("去噪 FP8,T5 FP8 常驻",          11.9e9 * 1 + 4.9e9 * 1 + 0.08e9 * 2, 0),
    ("去噪 FP8,T5 编码完卸载",         11.9e9 * 1 + 0.08e9 * 2, 2 * 4.9e9 / 25e9),
    ("去噪 NF4,T5 NF4 常驻",          11.9e9 * 0.5625 + 4.9e9 * 0.5625 + 0.08e9 * 2, 0),
    ("去噪 bf16 分组卸载(8 层),T5 卸载", 8 * 2 * 11.9e9 * 2 / 57 + 0.08e9 * 2, 28 * 11.9e9 * 2 / 25e9 + 2 * 4.9e9 / 25e9),
]
act = activation_peak(3072, 4608, 57)
print(f"预算 {BUDGET / GB:.1f} GB,一步激活 {act / GB:.1f} GB,VAE 分块解码后峰值可压到 1 GB 以内")
for name, weights, extra_s in plans:
    need = weights + act + 1 * GB
    print(f"  {name:<28} 需要 {need / GB:>5.1f} GB  {'放得下' if need <= BUDGET else '放不下'}  每张图额外搬运 {extra_s:>5.1f} s")
预算 14.5 GB,一步激活 0.4 GB,VAE 分块解码后峰值可压到 1 GB 以内
  bf16 全部常驻                    需要  32.9 GB  放不下  每张图额外搬运   0.0 s
  去噪 FP8,T5 FP8 常驻             需要  17.2 GB  放不下  每张图额外搬运   0.0 s
  去噪 FP8,T5 编码完卸载              需要  12.7 GB  放得下  每张图额外搬运   0.4 s
  去噪 NF4,T5 NF4 常驻             需要  10.4 GB  放得下  每张图额外搬运   0.0 s
  去噪 bf16 分组卸载(8 层),T5 卸载      需要   7.8 GB  放得下  每张图额外搬运  27.0 s
结论很直接:16 GB 的卡上,去噪网络 FP8 + T5 编码完卸载是最优解——放得下、几乎不损质量、每张图只多搬一次 T5;NF4 也放得下但更慢;分组卸载能跑 bf16 但每张图多二十多秒,只在"必须 bf16"时用。这也是各家"低显存模式"背后的逻辑。
怎么讲清楚
讲"FLUX 怎么在 24 GB / 16 GB 的卡上跑",先给账:bf16 去噪网络 24 GB + T5 9.5 GB,FP8 各减半,NF4 再减半;再给策略的代价:模型卸载每次生成多搬几十 GB、多几秒,逐层卸载每一步都搬全部权重、慢几倍,预取能藏但 H100 这种算得快的卡藏不住,而且要锁页内存走 DMA;最后给方案:去噪网络 FP8 或 NF4,T5 用完卸载,VAE 分块。顺带点出和 LLM 的差别:没有 KV Cache,显存规划是静态的,放不下靠这些手段而不是调度。
练习
- 用本章的函数算 HunyuanVideo(12.7B,文本编码器 8.6B)在一张 80 GB 的 H100 上:bf16 全部常驻放得下吗?720p 129 帧一步的激活多大?要是放不下,先动哪一项?
参考答案
权重 bf16 共约 43 GB,放得下;但一步的激活按粗估超过 20 GB(11.9 万 token × 3072 维 × 8 份),加上 VAE 解码的峰值,80 GB 很紧。先动的是激活而不是权重:分块注意力和序列并行把 token 分到多张卡上(见多卡并行一章),文本编码器编码完卸载也能省 17 GB。
- 把
offload_cost里的compute_per_step换成 4090 的数值(FLUX 一步约 1.0 s),"逐层卸载 + 预取"还会有额外时间吗?解释为什么同一种策略在不同的卡上结论相反。
参考答案
4090 上 28 步计算 28 秒,搬运 27 秒(PCIe 4.0),预取后额外时间接近 0——搬运几乎全部藏在计算后面。原因是预取能藏住的前提是"搬一层不慢于算一层",卡越慢、算一层越久,越容易藏;H100 算得太快,搬运成了瓶颈。所以卸载 + 预取是消费级卡的手段,数据中心的卡该用 FP8 或多卡。
- 服务里同时部署 FLUX 和三个 ControlNet(每个约 3.6 GB bf16),用户每次只用其中一个。显存怎么安排?
参考答案
ControlNet 是"冷"权重:全部常驻要 11 GB,但每次只用一个。把它们放在锁页的 CPU 内存里,请求到来时按需搬进 GPU(3.6 GB 在 PCIe 4.0 上约 0.15 秒),并保留最近用过的一个在显存里(LRU);或者按 ControlNet 类型把请求分到不同的实例上,让每个实例只常驻一个。这和 LLM 服务里多 LoRA 的做法同源(见多 LoRA / ControlNet 的服务一章)。
小结
- 扩散模型的显存 = 权重(去噪网络、文本编码器、VAE)+ 一步的激活 + VAE 解码峰值 + 开销;没有 KV Cache,规划是静态的。
- 图像模型的激活可以忽略,视频模型的激活与 token 数成正比、可能超过权重;文本编码器用完就该搬走。
- 模型卸载每次生成多搬几十 GB、多几秒;逐层卸载每一步搬全部权重、慢几倍;预取能藏住搬运,但只在算得慢的卡上藏得住,且要锁页内存。
- 权重量化首先是显存手段:FP8 减半且在新卡上提速,NF4 再减半但更慢;16 GB 的卡跑 FLUX 用"去噪 FP8 + T5 用完卸载 + VAE 分块"。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题