视频推理的瓶颈:十万 token 的注意力
图像模型的优化重点在线性层和小算子,视频模型只有一件事:注意力。十万 token 的 3D 全注意力占了一步的七八成,一条 5 秒 720p 视频单卡要二十多分钟。这一章把一次视频生成的时间拆到每个阶段,然后逐个看能对注意力下手的办法——更快的 kernel(SageAttention)、稀疏注意力(滑动块、径向、训练后稀疏化)、分块计算、序列并行、缓存——各自省在哪、能叠加到什么程度,最后给出一张"从 25 分钟到 2 分钟"的账。
自测:能答上来就可以跳过本章
- 视频生成一次的时间花在哪几个阶段?各占多少?
- 为什么说视频模型的注意力"天然稀疏"?稀疏注意力的加速比怎么算?
- 滑动块注意力(STA)和径向注意力分别利用了什么局部性?
- 稀疏注意力和序列并行、缓存能叠加吗?会互相干扰吗?
- VAE 解码在视频里为什么不能忽略?
自测参考答案(先自己答,再展开对照)
- 文本编码(不到 1 秒)、去噪网络 50 步(绝对大头,单卡 H100 二十多分钟,其中注意力占七八成)、VAE 解码(720p 81 帧几秒到几十秒,取决于分块方式)。
- 注意力分数矩阵里,大部分权重集中在时空上相邻的 token 之间(同一帧的邻近位置、相邻几帧的同一区域),远处的 token 贡献很小。加速比 ≈ 1 / 保留的注意力密度(再乘上稀疏 kernel 的效率):保留 20% 就是约 4~5 倍的注意力加速。
- STA 把 3D token 按时空块(tile)组织,每个块只和周围一个局部窗口里的块做注意力,和 FlashAttention 的分块天然对齐,没有碎片化的 mask;径向注意力观察到"时间距离越远、注意力越弱"的衰减规律,让注意力的空间窗口随时间距离按指数缩小,整体复杂度降到 \(O(N \log N)\)。
- 能叠加,但要注意:稀疏注意力要在每张卡上用同样的 mask;序列并行切 token 时,稀疏模式的局部性最好和切分方式对齐(按帧切,STA 的窗口就在卡内);缓存的跳步决策要在各卡同步。
- 视频 VAE 的解码在像素空间上做 3D 卷积,81 帧 720p 的激活是单图的 81 倍,不分块放不下、分块之后几十秒也常见——在去噪被并行和缓存压到两三分钟之后,解码就成了可观的一块。
先看一个六格小剧场,再读正文:
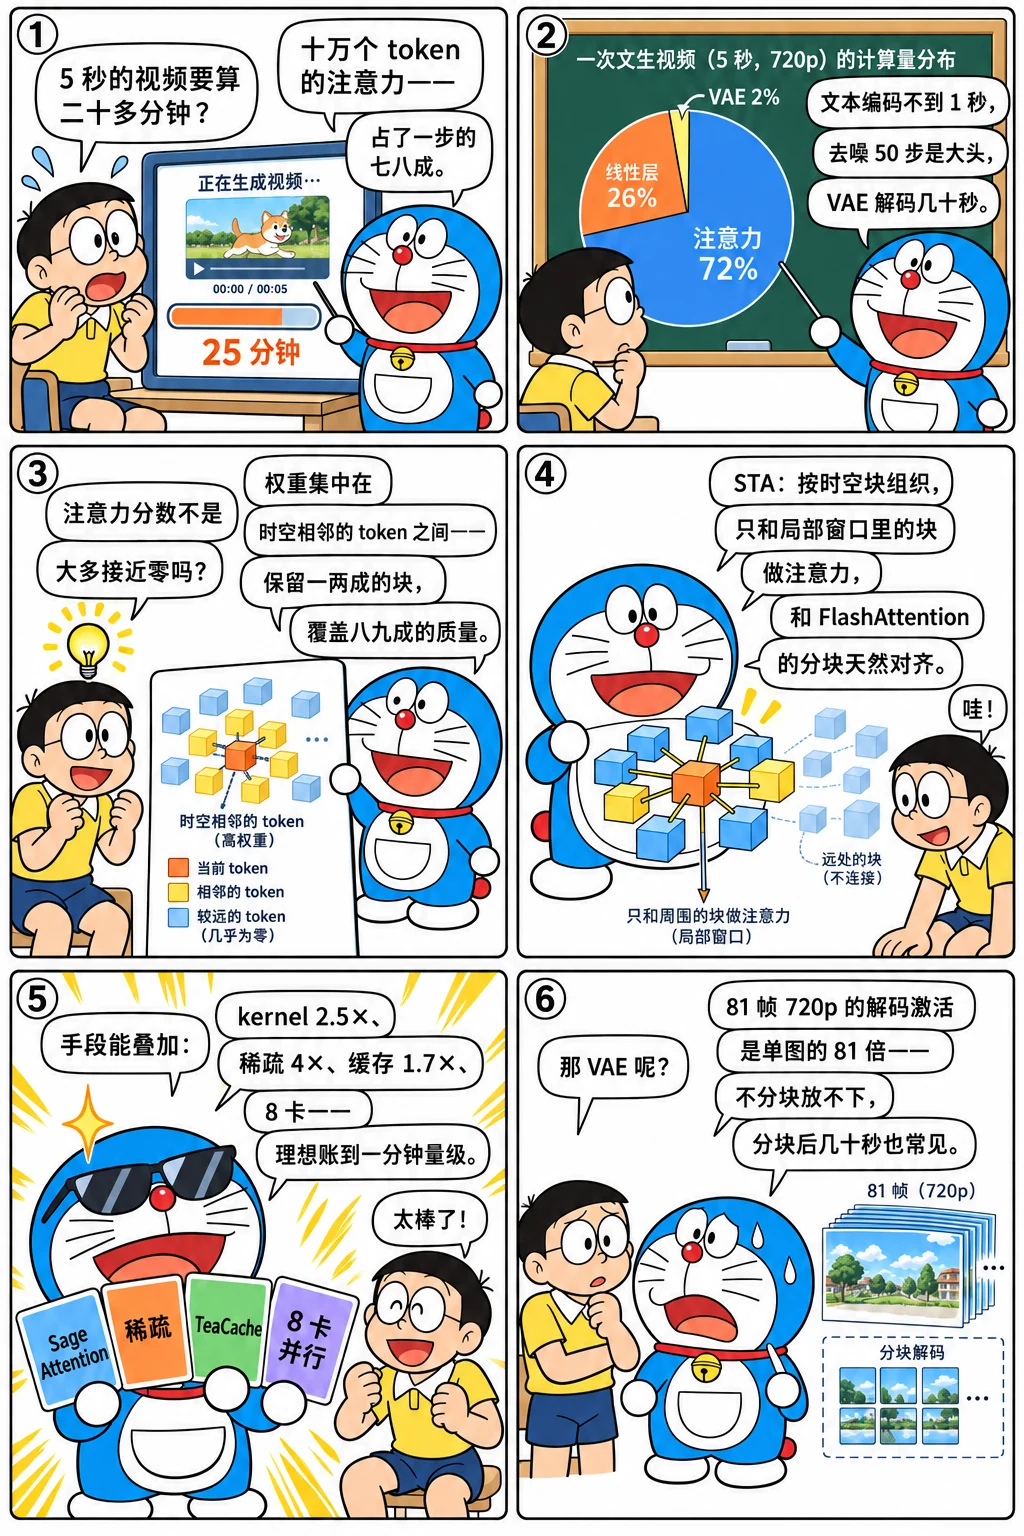
一次生成的时间去哪了
把 Wan 2.1-14B 720p 81 帧在单张 H100 上的一次生成按阶段拆开(估算,按算账一章的公式和典型 MFU):
import math

T, H, W = 21, 90, 160                               # 潜变量
N = T * (H // 2) * (W // 2) + 512                    # 75,600 视频 token + 512 文本 token
d, L, steps, cfg = 5120, 40, 50, 2
PEAK, MFU_LIN, MFU_ATT = 989e12, 0.5, 0.45

linear = L * 24 * N * d * d
attn = L * 4 * N * N * d
t_linear = linear / (MFU_LIN * PEAK)
t_attn = attn / (MFU_ATT * PEAK)
t_step = t_linear + t_attn
stages = [("文本编码(umT5-XXL)", 0.8), ("去噪 50 步 × CFG:线性层", t_linear * steps * cfg),
          ("去噪 50 步 × CFG:注意力", t_attn * steps * cfg), ("VAE 解码(时间分块)", 25.0)]
total = sum(t for _, t in stages)
print(f"{'阶段':<24} {'时间':>10} {'占比':>6}")
for name, t in stages:
    print(f"{name:<24} {t:>8.0f} s {t / total:>6.0%}")
print(f"{'合计':<24} {total:>8.0f} s = {total / 60:.1f} 分钟(单卡 H100,无任何加速)")
阶段                               时间     占比
文本编码(umT5-XXL)                  1 s     0%
去噪 50 步 × CFG:线性层             387 s    26%
去噪 50 步 × CFG:注意力            1066 s    72%
VAE 解码(时间分块)                   25 s     2%
合计                           1479 s = 24.7 分钟(单卡 H100,无任何加速)
注意力占了七成。线性层那一块已经是 FP8、编译、融合的战场(和图像相同),VAE 那几十秒要靠分块和并行解码;真正决定视频推理成败的是注意力那一块。
更快的 kernel
第一层手段不改计算量,只让同样的注意力算得更快:
| 手段 | 做法 | 典型收益(注意力部分) | 代价 |
|---|---|---|---|
| FlashAttention-2 / 3 | 分块 + online softmax;FA3 用 Hopper 的异步 Tensor Core 和 FP8 | 基准 / FA3 比 FA2 快 1.5~2× | FA3 只有 Hopper |
| SageAttention 1 / 2 | \(QK^\top\) INT8(按块平滑),\(PV\) FP8 / FP16 | 比 FA2 快 2~3× | 极少数场景需要调参 |
| 融合的 RoPE + 注意力 | RoPE 在 kernel 内做 | 几个百分点 | 要改实现 |
SageAttention 对视频模型几乎是默认选项:注意力占七成,它快 2.5 倍,整体就快 1.6 倍,而且不改模型、不重训、质量肉眼无差。
稀疏注意力:大部分分数本来就接近零
3D 全注意力让每个 token 看全部 token,但训练好的模型里,注意力权重集中在时空上相邻的 token 之间。把这个性质量化:假设注意力权重随时空距离衰减,看保留不同范围的邻居能覆盖多少权重质量:
import torch

torch.manual_seed(0)
T, Hp, Wp = 21, 45, 80                              # Wan 720p 的 token 网格(patch 2 之后)
# 用一个带衰减的玩具分布模拟"注意力质量随时空距离衰减":时间距离按 0.5 衰减、空间距离按 0.85 衰减
def mass_within(dt_max, ds_max):
    """一个位于中心的 query,它的注意力质量有多少落在 |Δt| ≤ dt_max 且 |Δh|,|Δw| ≤ ds_max 的邻居里"""
    t = torch.arange(-T // 2, T // 2 + 1).float()
    h = torch.arange(-Hp // 2, Hp // 2 + 1).float()
    w = torch.arange(-Wp // 2, Wp // 2 + 1).float()
    wt, wh, ww = 0.5 ** t.abs(), 0.85 ** h.abs(), 0.85 ** w.abs()
    full = wt.sum() * wh.sum() * ww.sum()
    kept = wt[t.abs() <= dt_max].sum() * wh[h.abs() <= ds_max].sum() * ww[w.abs() <= ds_max].sum()
    density = ((2 * dt_max + 1) * (2 * ds_max + 1) ** 2) / (T * Hp * Wp)
    return (kept / full).item(), min(1.0, density)

print(f"{'时间窗 ±Δt':>9} {'空间窗 ±Δs':>9} {'覆盖的注意力质量':>12} {'计算密度':>8} {'注意力加速(理想)':>14}")
for dt, ds in [(1, 4), (2, 8), (3, 12), (5, 16), (10, 40)]:
    m, dens = mass_within(dt, ds)
    print(f"{dt:>9} {ds:>9} {m:>12.1%} {dens:>8.1%} {1 / dens:>13.1f}×")
  时间窗 ±Δt   空间窗 ±Δs     覆盖的注意力质量     计算密度      注意力加速(理想)
        1         4        18.5%     0.3%         311.1×
        2         8        48.1%     1.9%          52.3×
        3        12        71.1%     5.8%          17.3×
        5        16        87.2%    15.8%           6.3×
       10        40       100.0%   100.0%           1.0×
这是一个玩具衰减模型,真实模型的注意力图要用校准数据实测(各家稀疏方法的第一步都是这个),但结论的形状一致:保留一两成的计算就能覆盖八九成的注意力质量,而覆盖最后那一成要把窗口开到接近全局——稀疏方法都在赌这一成不影响画质。几种把它落地的方法:
| 方法 | 稀疏模式 | 怎么保证效率 | 需要重训吗 |
|---|---|---|---|
| 滑动块注意力(STA) | 每个时空块只看邻域窗口 | 块和 FlashAttention 的分块对齐,没有碎片 mask | 微调一下效果更好 |
| 径向注意力(Radial) | 空间窗口随时间距离指数缩小 | 静态 mask,\(O(N \log N)\) | 微调 |
| 稀疏视频生成(SVG)/ 动态稀疏 | 按头分成"空间头"和"时间头",在线判断每个头的模式 | 块级稀疏 kernel | 不需要 |
| 训练后 top-k 块 | 每个 query 块只算分数最高的 k 个 key 块 | 先用低精度估分数再选 | 不需要 |
| 原生稀疏(NSA / DSA 式) | 训练时就用稀疏结构 | 专用 kernel | 是(模型本身) |
稀疏的加速比 = 1 / 密度 × kernel 效率。块级稀疏(块大小 64~128 个 token)的 kernel 效率能到 70%~90%,细粒度(逐 token)的 mask 效率很差——所以所有可用的方法都是块级的。这和 LLM 里的稀疏注意力(见长上下文、KV 淘汰与稀疏注意力)是同一套道理,区别是视频的局部性是三维的、而且没有 KV Cache 可以省。
分块、并行与缓存:叠起来
注意力之外,还有三类手段是从"把计算分开做"或"少做几次"入手的,它们和 kernel、稀疏可以叠加:
PEAK, MFU = 989.0, 0.47                              # H100 bf16 TFLOPS,典型 MFU
BASE = {"线性层": 2 * 50 * 1903.0, "注意力": 2 * 50 * 4682.0, "VAE": 25.0 * PEAK * MFU}   # 以 TFLOP 计(VAE 按 25 s 折算)
# 各手段对各部分的加速倍数(典型值,估算)
STEPS = [
    ("基线:单卡 H100,FA2,bf16",            {"线性层": 1.0, "注意力": 1.0, "VAE": 1.0}),
    ("+ SageAttention",                        {"注意力": 2.5}),
    ("+ FP8 线性层 + torch.compile",            {"线性层": 1.4}),
    ("+ 滑动块稀疏注意力(密度 20%,kernel 效率 80%)", {"注意力": 4.0}),
    ("+ TeaCache(阈值取中等)",                {"线性层": 1.7, "注意力": 1.7}),
    ("+ 8 卡:CFG 2 × Ulysses 4(效率 85%)",   {"线性层": 6.8, "注意力": 6.8, "VAE": 4.0}),
]
speed = {"线性层": 1.0, "注意力": 1.0, "VAE": 1.0}
print(f"{'配置':<44} {'线性层':>7} {'注意力':>7} {'VAE':>6} {'合计':>7}")
for name, gains in STEPS:
    for k, g in gains.items():
        speed[k] *= g
    t = {k: BASE[k] / (PEAK * MFU) / speed[k] for k in BASE}
    print(f"{name:<44} {t['线性层']:>5.0f} s {t['注意力']:>5.0f} s {t['VAE']:>4.0f} s {sum(t.values()):>5.0f} s")
配置                                               线性层     注意力    VAE      合计
基线:单卡 H100,FA2,bf16                            409 s  1007 s   25 s  1442 s
+ SageAttention                                409 s   403 s   25 s   837 s
+ FP8 线性层 + torch.compile                      292 s   403 s   25 s   720 s
+ 滑动块稀疏注意力(密度 20%,kernel 效率 80%)               292 s   101 s   25 s   418 s
+ TeaCache(阈值取中等)                              172 s    59 s   25 s   256 s
+ 8 卡:CFG 2 × Ulysses 4(效率 85%)                 25 s     9 s    6 s    40 s
理想叠加下从二十多分钟到一分钟量级。真实系统还有 pipeline 的空隙、通信等待、VAE 分块的重复计算和没那么理想的 MFU,各家公开的 8 卡数字在 1.5~3 分钟——和理想账差两三倍,这个差距就是系统工程的活。表里每一行也都有代价和前提:
- SageAttention:几乎免费,先上。
- FP8 + 编译:线性层那一块的标准手段,和图像相同。
- 稀疏注意力:收益最大,但要校准(或微调)、要专用 kernel,而且和稀疏模式对不上的内容(大幅运动、全局光照变化)会损失质量。
- TeaCache:阈值要扫;多卡时跳步决策要同步;对少步模型无效。
- 多卡:8 卡的实际效率 80%~90%,Ulysses 在 NVLink 内通信占比小;CFG 并行要求两张卡各放一份模型。
真实系统(xDiT、SGLang Diffusion、各家闭源服务)的做法就是这样一层层叠上去的。
自己叠一遍:
VAE 解码:被忽视的那几十秒
去噪被压到两分钟之后,VAE 解码的几十秒就不能忽视了。它的问题不是算力而是激活显存:81 帧 720p 的像素级特征是单图的 81 倍。手段:
- 时间分块:因果 VAE 可以按潜帧分段解码,每段几帧,显存只放一段,Wan 做成了流式接口;
- 空间分块:和图像一样,重叠混合(见 VAE 与潜空间);
- 并行解码:按时间段分到多张卡,各解各的,边界用重叠帧混合;
- 流式输出:解码一段就返回一段给用户——视频可以边生成边播放,用户感知的延迟从"等整条"变成"等第一段"。
怎么讲清楚
讲"视频生成怎么优化",先把账摆出来:单卡 H100 一条 5 秒 720p 视频二十多分钟,注意力占七成、线性层两成、VAE 解码几十秒。再按注意力的三层说:kernel 层 SageAttention 2.5 倍几乎免费;稀疏层利用时空局部性,保留一两成的块就覆盖八九成的注意力质量,块级稀疏 kernel 能把它兑现成 3~4 倍;再叠缓存(TeaCache)和多卡(CFG × Ulysses)。最后给结果:理想叠加到一分钟量级,各家公开的 8 卡数字在 1.5~3 分钟,差距是 pipeline 空隙和通信等待。补一句 VAE:去噪压下去之后解码的几十秒要靠时间分块、并行和流式输出。
练习
- 把
mass_within的时间衰减从 0.5 改成 0.9(运动更剧烈、远处的帧更相关),同样的窗口覆盖的质量变成多少?这对稀疏模式的选择有什么启示?
参考答案
同样的窗口覆盖的质量明显下降,要把时间窗开大才能回到 90%——密度上升,加速下降。启示是稀疏模式应该按内容自适应(动态稀疏、按头分模式),静态窗口在剧烈运动的视频上会丢质量;这正是 SVG 这类"在线判断每个头是空间头还是时间头"的方法的出发点。
- 用本章的叠加表算:如果只有 1 张卡(去掉最后一行),能做到几分钟?哪一项是单卡上最值得先做的?
参考答案
去掉 8 卡那一行,前面几项叠起来约 4 分钟(线性层约 3 分钟、注意力约 1 分钟、VAE 几十秒)——注意这时线性层反而成了大头,因为稀疏和缓存都主要作用在注意力上。单卡上最值得先做的是 SageAttention(免费、2.5 倍注意力)和稀疏注意力(收益最大);TeaCache 次之。再往下只能并行,或者换更小的模型 / 蒸馏。
- 稀疏注意力 + Ulysses 序列并行一起用时,如果按 token 顺序平均切给 4 张卡,而稀疏模式是"每帧只看前后两帧",通信模式会怎样?怎样切更好?
参考答案
Ulysses 在注意力前做 all-to-all 把 token 换成按头切,每张卡算自己那几个头的完整注意力——稀疏 mask 在每张卡内部完整可见,切法不影响正确性,但每张卡都要持有全部 token 的 K、V,稀疏节省不了通信;如果用 Ring Attention,按帧切块能让"只看前后两帧"的模式只需要和环上相邻的卡交换 K、V,通信随稀疏度下降。所以稀疏和并行要一起设计:时间局部的稀疏配按帧切的 Ring,空间局部的稀疏配按空间块切。
小结
- 视频一次生成的时间:去噪占九成以上,其中注意力七成、线性层两成;VAE 解码几十秒在去噪被压下去之后不能忽视。
- 注意力的三层手段:kernel(SageAttention 2.5 倍、几乎免费)、稀疏(时空局部性让一两成的块覆盖八九成质量,块级 kernel 兑现 3~4 倍)、分开做或少做(序列并行、缓存)。
- 这些手段可以叠加:单卡从 25 分钟到几分钟,8 卡理想账一分钟量级、公开数字 1.5~3 分钟;每一项都有前提(校准、阈值、同步、NVLink)。
- VAE 解码靠时间 / 空间分块、并行和流式输出;流式让用户感知的延迟变成"等第一段"。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题