扩散与流匹配:推理视角
语言模型推理是"一次前向吐一个 token",图像和视频生成模型的推理是"几十次前向把一团噪声修成一张图"。这一章只讲推理时真正会碰到的那部分数学:噪声是怎么加上去、又怎么一步步去掉的,模型到底在预测什么,为什么流匹配把这件事变得更简单,以及无分类器引导(CFG)为什么让每一步的计算量翻倍。读完它,后面所有"少走几步""缓存上一步"的加速手段就都有了落脚点。
自测:能答上来就可以跳过本章
- 扩散模型推理时,网络的输入和输出分别是什么?"预测噪声"和"预测速度"有什么区别?
- 为什么 DDPM 要 1000 步,而 DDIM / DPM-Solver 只要 20~50 步?
- 流匹配的采样过程是在解什么方程?为什么它对"少步采样"更友好?
- CFG 的公式是什么?它为什么让一步的前向计算量变成两倍?
- 同一个种子、同一个提示词,为什么换一张卡结果可能不一样?
自测参考答案(先自己答,再展开对照)
- 输入是带噪声的样本 \(x_t\)(潜空间里的张量)和时间步 \(t\),加上文本条件;输出是对"噪声"或"速度"的预测。预测噪声 \(\epsilon\) 是 DDPM 的参数化;预测速度 \(v = x_1 - x_0\)(流匹配)或 \(v\)-prediction 在数值上更稳定,尤其是接近纯噪声的那几步。
- DDPM 的采样是马尔可夫链,每一步都要加随机噪声,步长不能大。DDIM 把它改写成确定性的 ODE,DPM-Solver 等高阶求解器利用 ODE 的半线性结构一步走得更准,所以 20~50 步就能到同样的质量。
- 解一个常微分方程 \(\mathrm{d}x/\mathrm{d}t = v_\theta(x_t, t)\),从 \(t=0\) 的噪声积分到 \(t=1\) 的数据。流匹配训练时走的是直线插值,学到的速度场轨迹接近直线,欧拉法几步就能走得很准。
- \(\tilde\epsilon = \epsilon_\varnothing + w\,(\epsilon_c - \epsilon_\varnothing)\):有条件和无条件各算一次,按引导强度 \(w\) 外推。两次前向通常拼成 batch 为 2 一起算,算力翻倍、显存里激活也翻倍。
- 初始噪声由种子决定,但去噪网络里的矩阵乘、注意力的浮点归约顺序随 kernel、batch 大小、硬件而变,几十步之后微小差异会被放大成肉眼可见的不同。要可复现得固定硬件、kernel 实现和 batch 组成(见评测与压测)。
先看一个六格小剧场,再读正文:
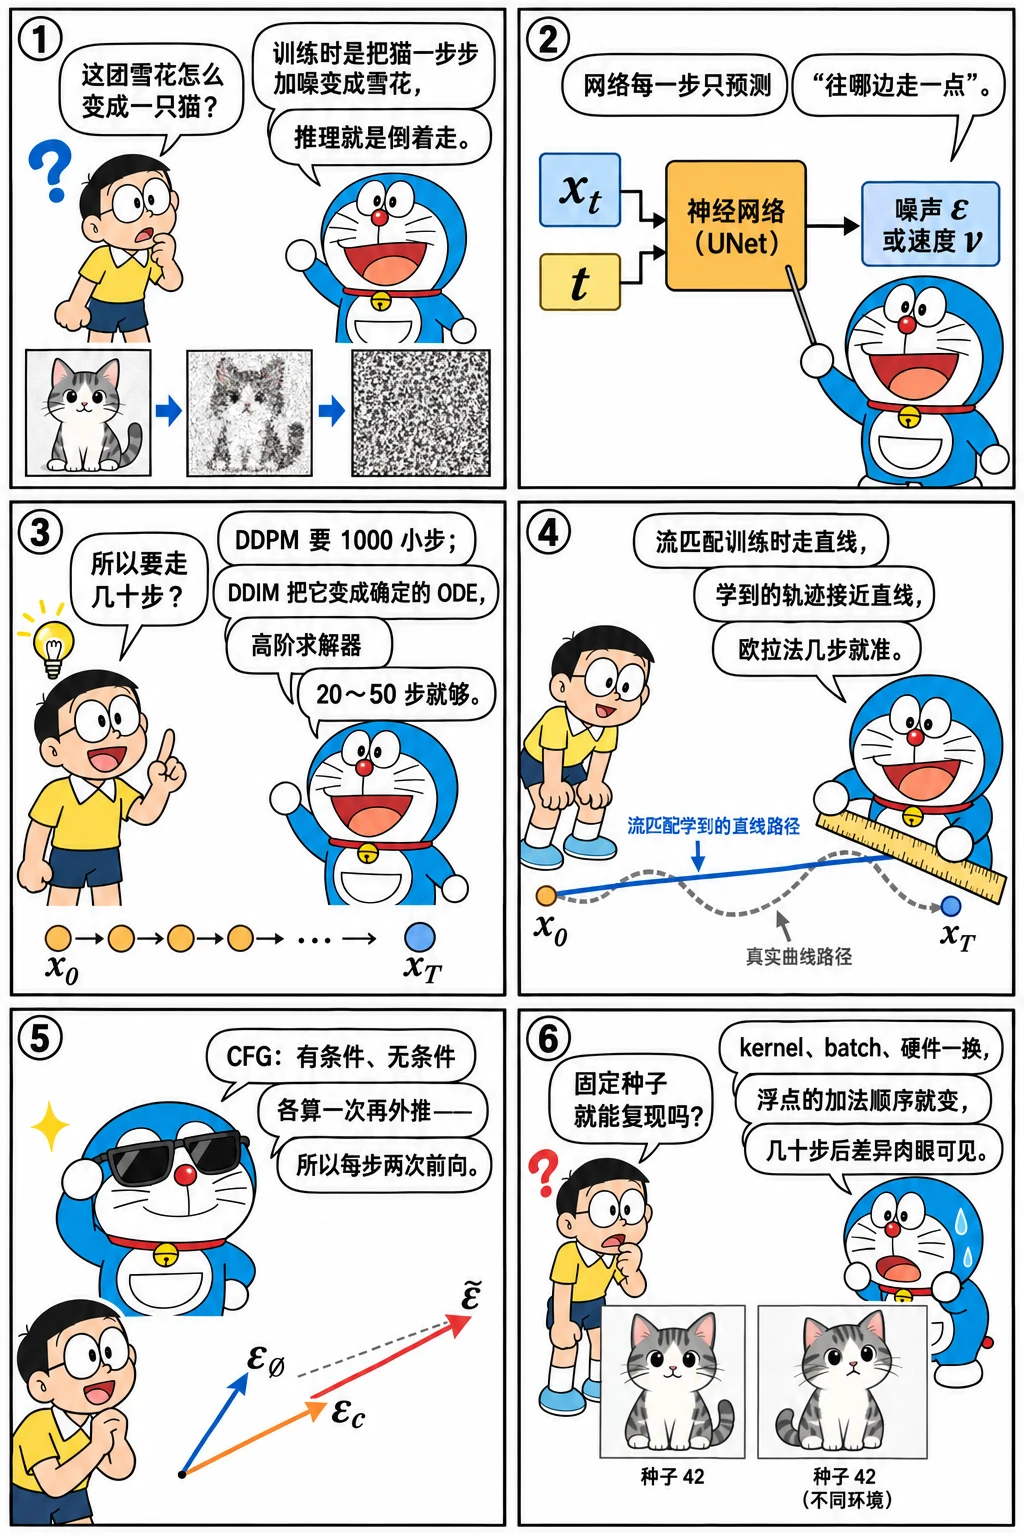
加噪:从数据到噪声的一条路
扩散模型的"前向过程"不用学,它只是一个公式:把干净样本 \(x_0\) 和高斯噪声 \(\epsilon\) 按时间步 \(t\) 混合。DDPM 那一族用的是
\(\bar\alpha_t\) 从 1(\(t=0\),没有噪声)单调降到接近 0(\(t = T\),几乎纯噪声)。流匹配用的是更简单的直线:
两者本质上都在定义"信噪比随 \(t\) 怎么变"。推理时模型要做的,是沿着这条路倒着走。
把"路"画出来:平面上一圈数据点,每个点配一个固定的噪声 ε,沿 t 从 0 走到 1。拖动旋转,拉 t 看截面,换加噪方式看路的形状:
用 diffusers 里的两个调度器把这两条路画出来——它们就是推理时真正用的那两个对象:
import torch
from diffusers import DDIMScheduler, FlowMatchEulerDiscreteScheduler

ddim = DDIMScheduler(num_train_timesteps=1000, beta_schedule="scaled_linear")   # SD 1.5 / SDXL 用的 β 日程
flow = FlowMatchEulerDiscreteScheduler()                                        # SD3 / FLUX / Wan 用的流匹配

print("DDPM 族:ᾱ_t 决定信号占比,sqrt(1-ᾱ_t) 决定噪声占比")
for t in (0, 250, 500, 750, 999):
    a = ddim.alphas_cumprod[t].item()
    print(f"  t={t:>3}  信号 {a ** 0.5:.3f}  噪声 {(1 - a) ** 0.5:.3f}  信噪比 {a / (1 - a + 1e-12):9.4f}")

flow.set_timesteps(4)
print("流匹配:t 直接就是噪声占比(这里把 1000 步归一化到 0~1)")
for s in flow.sigmas.tolist():
    print(f"  σ={s:.3f}  信号 {1 - s:.3f}  噪声 {s:.3f}")
DDPM 族:ᾱ_t 决定信号占比,sqrt(1-ᾱ_t) 决定噪声占比
  t=  0  信号 1.000  噪声 0.010  信噪比 9997.3408
  t=250  信号 0.906  噪声 0.424  信噪比    4.5559
  t=500  信号 0.576  噪声 0.818  信噪比    0.4954
  t=750  信号 0.195  噪声 0.981  信噪比    0.0397
  t=999  信号 0.027  噪声 1.000  信噪比    0.0007
流匹配:t 直接就是噪声占比(这里把 1000 步归一化到 0~1)
  σ=1.000  信号 0.000  噪声 1.000
  σ=0.667  信号 0.333  噪声 0.667
  σ=0.334  信号 0.666  噪声 0.334
  σ=0.001  信号 0.999  噪声 0.001
  σ=0.000  信号 1.000  噪声 0.000
注意 SD 1.5 的日程在 \(t=999\) 时信号占比还有 6.8%——纯噪声里残留了一点"均值"信息,这就是老版 SD 生成的图整体偏灰、很难画出纯黑或纯白的原因(后来的 "zero terminal SNR" 修正了它)。流匹配没有这个问题:\(\sigma = 1\) 就是纯噪声。
模型在预测什么
训练时模型看到 \(x_t\) 和 \(t\),要预测的东西有几种等价的选择:
| 参数化 | 预测目标 | 谁在用 | 推理时怎么还原 \(x_0\) |
|---|---|---|---|
| \(\epsilon\)-prediction | 加进去的噪声 \(\epsilon\) | SD 1.5、SDXL | \(\hat x_0 = (x_t - \sqrt{1-\bar\alpha_t}\,\hat\epsilon)/\sqrt{\bar\alpha_t}\) |
| \(v\)-prediction | \(v = \sqrt{\bar\alpha_t}\,\epsilon - \sqrt{1-\bar\alpha_t}\,x_0\) | SD 2.x、部分视频模型 | 线性组合,数值在高噪声端更稳 |
| 流匹配的速度 | \(v = \epsilon - x_0\) | SD3、FLUX、Wan、HunyuanVideo | \(\hat x_0 = x_t - \sigma\,\hat v\) |
它们对推理系统的意义只有一条:每一步的输入输出形状完全一样(都是潜空间张量),所以一次去噪就是一次固定形状的前向——这是 CUDA Graph、静态 batch、特征缓存这些手段能用上的根本原因。
去噪:解一个常微分方程
DDPM 原始的采样每一步都要加新的随机噪声,所以必须走 1000 小步。DDIM 的洞察是:同样的训练目标,可以改写成一个确定性的 ODE,从纯噪声出发沿着它积分到数据——于是步数成了求解器的精度问题,不再是模型的要求。流匹配更直接,它学的就是 ODE 的速度场:
最后一个式子就是欧拉法。用一个有解析解的玩具速度场看看"步数"和"求解器"各自的贡献——这里不需要神经网络,就能把结论量清楚:
import math

# 玩具:速度场 v(x, σ) = -2σx,从 σ=1 积分到 0 的精确解是 x(0) = x(1) · e
def v(x, sigma):
    return -2.0 * sigma * x

def euler(steps):
    x, sigma, d = 1.0, 1.0, 1.0 / steps
    for _ in range(steps):
        x = x - d * v(x, sigma)                 # 一次前向
        sigma -= d
    return x

def heun(steps):                                # 二阶:每步两次前向
    x, sigma, d = 1.0, 1.0, 1.0 / steps
    for _ in range(steps):
        v1 = v(x, sigma)
        x_pred = x - d * v1
        v2 = v(x_pred, sigma - d)
        x = x - d * (v1 + v2) / 2
        sigma -= d
    return x

print(f"{'步数':>4} {'欧拉法误差':>12} {'Heun 误差':>12}  (同样的网络调用次数:Heun 用一半的步数)")
for steps in (4, 8, 16, 32, 64):
    e1 = abs(euler(steps) - math.e)
    e2 = abs(heun(steps // 2) - math.e)
    print(f"{steps:>4} {e1:>12.5f} {e2:>12.5f}")
  步数        欧拉法误差      Heun 误差  (同样的网络调用次数:Heun 用一半的步数)
   4      0.18211      0.21828
   8      0.10188      0.05740
  16      0.05374      0.01443
  32      0.02759      0.00359
  64      0.01397      0.00089
拨一拨网络调用次数,看两种求解器的轨迹和误差:
两个推理上的结论:
- 误差随步数线性下降(欧拉)或平方下降(Heun)——步数翻倍,欧拉的误差减半,Heun 的误差降到四分之一。步数稍多之后,高阶求解器在同样的网络调用预算下精度高一个量级(步数极少时它反而可能更差,看表里的第一行)。DPM-Solver++、UniPC 就是针对扩散 ODE 的半线性结构设计的高阶方法,这是 SD 1.5 从 DDIM 50 步降到 20 步的原因。
- 网络调用次数才是成本,不是"步数"。一步 Heun 等于两次前向。读 benchmark 时要看 NFE(number of function evaluations)。
真实模型的速度场不是直线,但流匹配训练时走的是直线插值,学到的轨迹接近直线,所以 FLUX、Wan 这些模型用最朴素的欧拉法 20~50 步就够;再往下压步数要靠蒸馏(见少步生成)。
无分类器引导:为什么一步要算两次
模型学到的是 \(p(x \mid c)\),但直接采样出来的图"听话程度"不够。无分类器引导(classifier-free guidance,CFG)训练时随机把条件 \(c\) 丢掉一部分,让同一个模型也会算无条件的预测;推理时把两者外推:
这个外推在分布上等价于从 \(p_c(x)^w\, p_\varnothing(x)^{1-w}\) 采样。用一维的两个分布看 \(w\) 从 0 拉到 10 时发生了什么:
\(w\) 就是常说的 guidance scale(SD 1.5 的 7.5、SDXL 的 5~7、FLUX dev 的 3.5)。代价一目了然:每一步要算两次前向。实现上把有条件和无条件拼成一个 batch 一起算:
import torch

torch.manual_seed(0)
B, C, H, W = 1, 4, 8, 8
x_t = torch.randn(B, C, H, W)
cond = torch.randn(B, 8, 32)                    # 文本编码
uncond = torch.zeros(B, 8, 32)                  # 空提示词的编码(真实模型里是编码 "" 得到的向量)

calls = 0
def fake_model(x, c):                           # 代替去噪网络:记一下被调用了几次、batch 多大
    global calls
    calls += 1
    return x * 0.1 + c.mean(dim=(1, 2))[:, None, None, None]

# 朴素写法:两次前向
v_c, v_u = fake_model(x_t, cond), fake_model(x_t, uncond)
w = 7.5
v_guided = v_u + w * (v_c - v_u)
print(f"朴素写法:调用 {calls} 次,每次 batch={B}")

# 拼 batch:一次前向,batch 翻倍
calls = 0
v_both = fake_model(torch.cat([x_t, x_t]), torch.cat([uncond, cond]))
v_u2, v_c2 = v_both.chunk(2)
v_guided2 = v_u2 + w * (v_c2 - v_u2)
print(f"拼 batch:调用 {calls} 次,batch={2 * B},结果一致:{torch.allclose(v_guided, v_guided2)}")
print(f"引导后的预测范数 {v_guided.norm():.3f},无条件 {v_u.norm():.3f},有条件 {v_c.norm():.3f}:w=7.5 把差异放大了")
朴素写法:调用 2 次,每次 batch=1
拼 batch:调用 1 次,batch=2,结果一致:True
引导后的预测范数 12.037,无条件 1.503,有条件 2.215:w=7.5 把差异放大了
CFG 对推理系统意味着:
- 算力和激活显存都是无引导的两倍。batch 拼在一起只是省了 kernel 启动,FLOPs 没少;
- 两路前向只有条件不同,所以"条件那一路"和"无条件那一路"可以放到两张卡上并行算(CFG 并行,见多卡并行);
- 蒸馏可以把引导烘进模型(FLUX.1-dev 的
guidance是一个输入标量而不是两次前向),一步只算一次,这是"引导蒸馏"(见少步生成)。 - \(w\) 太大会过饱和、细节崩坏;常见的补救是 guidance rescale 或者只在部分时间步用引导——后者还顺便省算力。
推理视角的总结:一次生成要算多少次前向
把这一章的量串起来,一张图的生成成本就是:
cases = [("SD 1.5 · DDIM 50 步 · CFG",            50, 2, 1), ("SD 1.5 · DPM-Solver++ 20 步 · CFG",  20, 2, 1),
         ("SDXL · 30 步 · CFG",                      30, 2, 1), ("FLUX.1-dev · 28 步 · 引导已蒸馏",      28, 1, 1),
         ("FLUX.1-schnell · 4 步",                    4, 1, 1), ("Wan 2.1 · 50 步 · CFG",                 50, 2, 1),
         ("SDXL-Lightning · 4 步 · 无 CFG",           4, 1, 1)]
print(f"{'配置':<36} 去噪网络前向次数")
for name, steps, cfg, per in cases:
    print(f"{name:<36} {steps * cfg * per:>6}")
配置                                   去噪网络前向次数
SD 1.5 · DDIM 50 步 · CFG                100
SD 1.5 · DPM-Solver++ 20 步 · CFG         40
SDXL · 30 步 · CFG                        60
FLUX.1-dev · 28 步 · 引导已蒸馏                28
FLUX.1-schnell · 4 步                      4
Wan 2.1 · 50 步 · CFG                    100
SDXL-Lightning · 4 步 · 无 CFG              4
从 100 次到 4 次,差 25 倍。后面"性能"一篇的每一章,都在对这个公式的某一项动手:更好的求解器减少步数,蒸馏砍掉 CFG 和步数,缓存让一部分前向变便宜,并行让一次前向变快。
怎么讲清楚
讲"扩散模型推理和 LLM 推理最大的区别",核心是三点:(1)LLM 是自回归、每步形状在变(KV 在长),扩散是固定形状的张量反复过同一个网络几十次,所以 CUDA Graph、静态 batch、特征缓存都更好用;(2)扩散的成本公式是 步数 × CFG 倍数 × 每步前向数,优化全部围绕这三项;(3)扩散没有 KV Cache 这种跨步复用的东西,每一步都要完整算一遍注意力,token 数(分辨率、帧数)决定一切——视频模型的注意力 token 数轻松上十万,这是它比 LLM 更"算力密集"的原因。
练习
- 把玩具 ODE 换成 \(v(x, \sigma) = -x/(1+\sigma)\)(精确解 \(x(0) = 2\,x(1)\)),重复欧拉与 Heun 的实验。Heun 的误差变成了什么?为什么?
参考答案
Heun 的误差是 0(到浮点精度)。这个场的解是 \(x(\sigma) = C/(1+\sigma)\),而 Heun 法(梯形法)对"速度沿一步线性变化"的情形恰好精确——这个场一步之内的速度变化正好满足这一点。欧拉法仍然是一阶误差。它说明求解器的误差取决于速度场的形状:真实扩散模型的速度场在高噪声端(\(\sigma\) 接近 1)最弯,所以很多日程把步长在那一端排得更密(见采样器与调度器)。
- CFG 的 \(w\) 从 1 调到 15,用本章的
fake_model算引导后预测的范数怎么变。真实模型里 \(w\) 太大会出什么问题?工程上有哪几种缓解办法?
参考答案
范数随 \(w\) 线性增长,因为外推项 \(w(v_c - v_\varnothing)\) 和 \(w\) 成正比。真实模型里过大的 \(w\) 会把潜变量推出训练分布:颜色过饱和、对比度爆炸、结构崩坏。缓解:guidance rescale(把引导后的标准差拉回有条件预测的水平)、动态 CFG(前几步大、后几步小)、只在中间时间步用引导、或者干脆用引导蒸馏过的模型。
- 统计一下:FLUX.1-dev 28 步、不用 CFG,和 SDXL 30 步、用 CFG,去噪网络的前向次数分别是多少?如果 FLUX 的一次前向是 SDXL 的 7 倍耗时,谁更慢?
参考答案
FLUX:28 次;SDXL:60 次。按 7 倍算,FLUX 的总耗时相当于 196 个 SDXL 前向,比 SDXL 的 60 慢三倍多——参数量大带来的单步成本,不是靠省掉 CFG 就能抵消的。这也是为什么 FLUX 这类模型的加速重点在单步(量化、缓存、并行)而不是步数。
小结
- 加噪是一条确定的路(DDPM 的 \(\bar\alpha_t\) 或流匹配的直线),推理就是沿着它倒着走;模型每一步预测噪声或速度,输入输出形状固定。
- 去噪是在解 ODE:步数是求解器精度问题,高阶求解器在同样的网络调用预算下误差低一个量级;成本要按 NFE 算。
- CFG 让每一步算两次前向,算力和激活显存翻倍;引导蒸馏可以把它烘进模型。
- 一张图的成本 = 步数 × CFG 倍数 × 每步前向数,从 100 到 4 差 25 倍——后面所有加速都在动这个公式。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题