特征缓存:相邻两步长得太像了
去噪的几十步里,相邻两步的输入只差一点噪声,网络的输出也只差一点——那为什么每一步都要从头算一遍?特征缓存就是把上一步的结果拿来复用:DeepCache 复用 UNet 的深层特征,TeaCache 和 FBCache 用一个便宜的信号判断"这一步能不能整个跳过",PAB 让不同注意力按不同频率更新。它们不改模型、不重训,视频模型上普遍 1.5~2.5 倍。这一章用一个小 DiT 把"相邻步有多像"量出来,实现一个 TeaCache 风格的跳步器,看它省了多少、错了多少、什么时候会失效。
自测:能答上来就可以跳过本章
- 特征缓存的前提是什么?用什么量可以验证这个前提?
- DeepCache 和 TeaCache 分别缓存什么?各自适合 UNet 还是 DiT?
- TeaCache 怎么在不算这一步的情况下判断"这一步能跳过"?
- 缓存会带来什么误差?误差怎么累积?阈值怎么定?
- 少步蒸馏模型为什么几乎用不了缓存?CFG 的两路要分别缓存吗?
自测参考答案(先自己答,再展开对照)
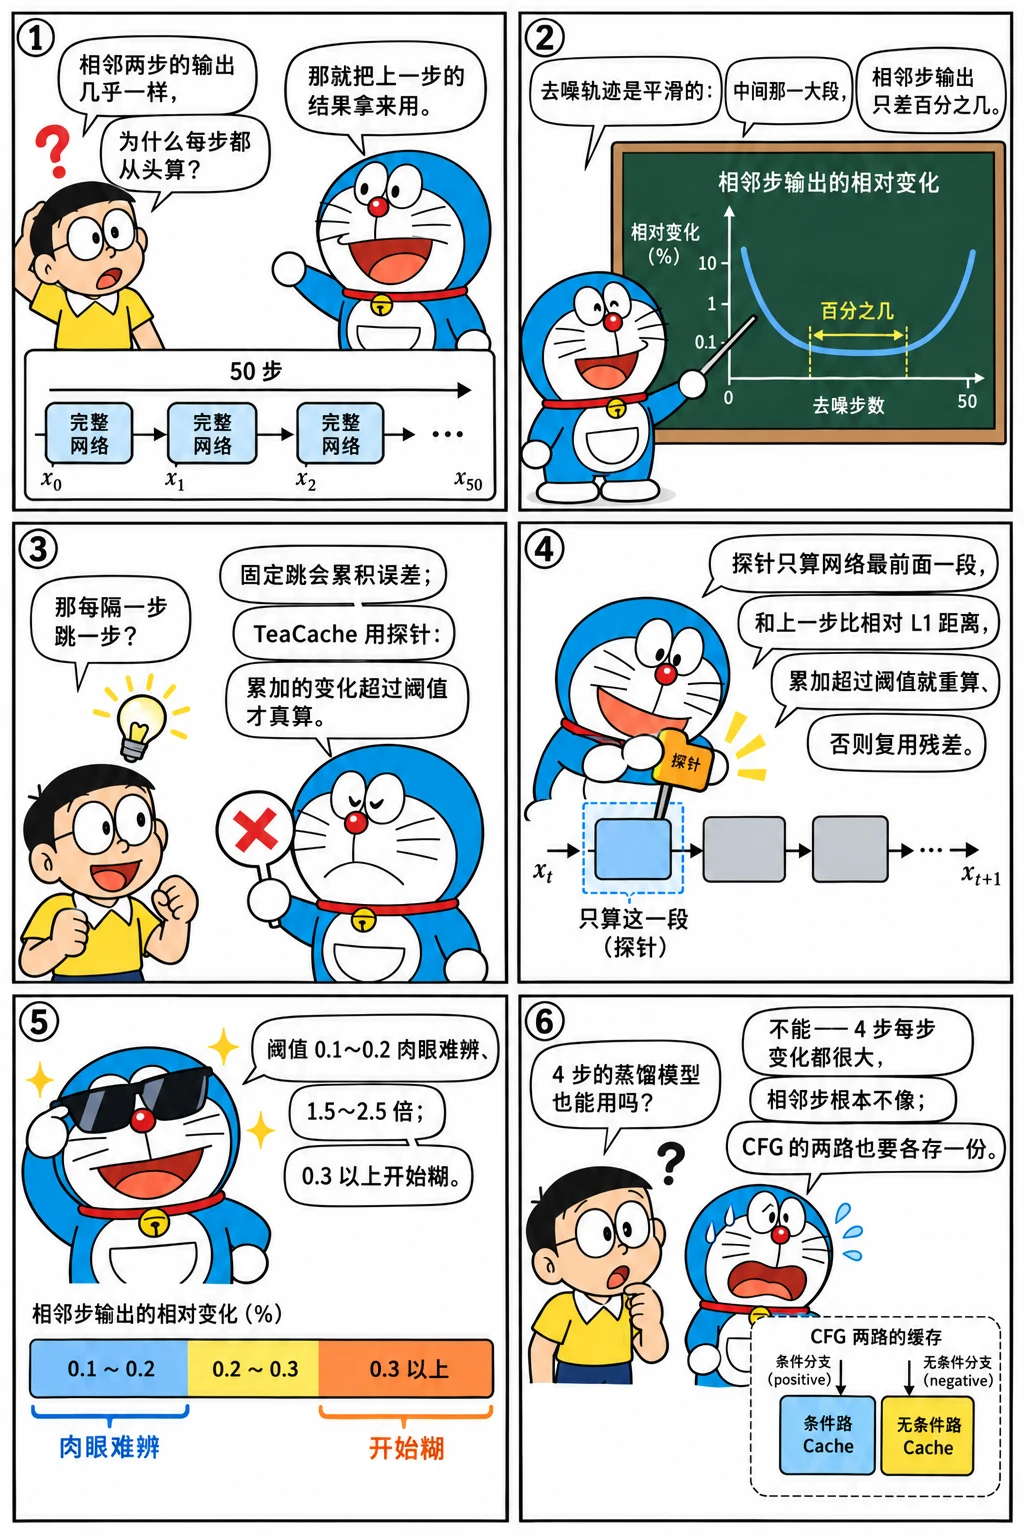
- 相邻时间步的网络输出高度相似(去噪轨迹是平滑的)。可以直接量:每一步的输出和上一步输出的相对 L1 距离,中间那一大段步数里通常只有百分之几。
- DeepCache 缓存 UNet 深层(低分辨率)块的特征,每隔几步只重算浅层(高分辨率)分支——利用的是 UNet 的跳连结构,只适合 UNet;TeaCache 缓存整个去噪网络的输出残差,决定跳过时用上一步的残差直接得到这一步的输出——不依赖结构,DiT 和 UNet 都能用。
- 它只算网络最前面那一小段:时间步嵌入经 AdaLN 调制后的输入(或者第一个块的输出),拿它和上一步同样位置的量比相对 L1 距离,把距离累加,超过阈值就真算一步并清零,否则跳过。这一小段的计算只占一步的几个百分点。
- 跳过的步用的是旧的残差,和真实输出有差,差异会沿着后面的步传播;连续跳得越多累积越大。所以用"累加距离超过阈值才重算"而不是"每隔 k 步重算",让变化快的区间多算、变化慢的区间多跳。阈值用质量指标(PSNR / 用户肉眼)对着加速比扫出来,各模型不同。
- 少步模型每一步的变化都很大(4 步走完全程),相邻步根本不像,没有可复用的东西;CFG 的两路输入不同(条件不同),缓存要各存一份,或者只在无条件那一路上缓存。
先看一个六格小剧场,再读正文:
前提:相邻两步有多像
用一个小 DiT 跑一遍去噪循环,每一步记录三个量:调制后的输入(AdaLN 之后进第一个块的张量)、第一个块的输出残差、整个网络的输出。看它们相邻两步之间的相对变化:
import torch
from diffusers import DiTTransformer2DModel, DDIMScheduler

torch.manual_seed(0)
dit = DiTTransformer2DModel(num_attention_heads=4, attention_head_dim=16, in_channels=4, out_channels=8,
                            num_layers=4, sample_size=16, patch_size=2, num_embeds_ada_norm=1000).eval()
sched = DDIMScheduler(num_train_timesteps=1000, beta_schedule="linear", clip_sample=False)
sched.set_timesteps(20)

captured = {}
def grab(name):
    def hook(m, i, o):
        captured[name] = (o[0] if isinstance(o, tuple) else o).detach()
    return hook
dit.transformer_blocks[0].register_forward_hook(grab("block0_out"))

def rel_l1(a, b):
    return ((a - b).abs().mean() / b.abs().mean()).item()

x = torch.randn(1, 4, 16, 16)
cls = torch.tensor([3])
prev = {}
rows = []
with torch.no_grad():
    for i, t in enumerate(sched.timesteps):
        out = dit(x, timestep=t[None], class_labels=cls).sample[:, :4]
        cur = {"输出": out, "第一块输出": captured["block0_out"]}
        if prev:
            rows.append((i, int(t), rel_l1(cur["第一块输出"], prev["第一块输出"]), rel_l1(cur["输出"], prev["输出"])))
        prev = cur
        x = sched.step(out, t, x).prev_sample

print(f"{'步':>3} {'t':>4} {'第一块输出的变化':>14} {'整网输出的变化':>13}")
for i, t, d1, d2 in rows:
    print(f"{i:>3} {t:>4} {d1:>14.3f} {d2:>13.3f}")
  步    t       第一块输出的变化       整网输出的变化
  1  900          0.422         0.280
  2  850          0.499         0.237
  3  800          0.511         0.150
  4  750          0.489         0.102
  5  700          0.454         0.081
  6  650          0.416         0.074
  7  600          0.378         0.063
  8  550          0.342         0.054
  9  500          0.308         0.051
 10  450          0.274         0.046
 11  400          0.242         0.053
 12  350          0.211         0.058
 13  300          0.181         0.062
 14  250          0.151         0.059
 15  200          0.123         0.039
 16  150          0.095         0.061
 17  100          0.068         0.052
 18   50          0.041         0.063
 19    0          0.016         0.072
这是随机权重的小模型,数值本身没有意义,但两件事和真实模型一致:相邻步的变化是连续的、平滑的(没有突变),并且网络最前面那一小段的变化量和整网输出的变化量大体同步——后者就是 TeaCache 的全部依据:用便宜的前段变化量预测昂贵的整网变化量(真实实现还会拟合一个多项式把两者对上)。
真实模型(FLUX、Wan、HunyuanVideo)的曲线形状是:开始几步变化大(构图在定),中间很长一段变化只有百分之几,最后几步又略涨(细节在定)。所以能跳的是中间那一大段。
用上面测出的变化曲线,拨一拨阈值,看哪些步会被跳过:
实现一个 TeaCache 风格的跳步器
规则:每一步先算便宜的"探针"(这里用第一个块的输出),和上次真算那一步的探针比相对 L1 距离,累加;累加值小于阈值就跳过——用上次真算得到的残差(输出减输入)加到当前输入上当作输出;超过阈值就真算一步、清零累加。
def denoise(threshold, probe_blocks=1):
    """threshold=0 等于每步都算;越大跳得越多。返回最终潜变量、真算的次数。"""
    torch.manual_seed(0)
    x = torch.randn(1, 4, 16, 16)
    acc, last_probe, last_resid, computed = 0.0, None, None, 0
    with torch.no_grad():
        for t in sched.timesteps:
            # 探针:只跑到第一个块(这里借 hook 取第一块的输出;真实实现会把前几层单独跑一遍)
            full = dit(x, timestep=t[None], class_labels=cls).sample[:, :4]
            probe = captured["block0_out"]
            skip = False
            if last_probe is not None:
                acc += rel_l1(probe, last_probe)
                skip = acc < threshold
            if skip:
                out = x + last_resid                           # 复用上一次真算的残差
            else:
                out = full
                computed += 1
                acc, last_probe, last_resid = 0.0, probe, full - x
            x = sched.step(out, t, x).prev_sample
    return x, computed

ref, n_ref = denoise(0.0)
print(f"{'阈值':>5} {'真算步数':>7} {'加速比':>6} {'最终潜变量相对误差':>12}")
for th in (0.0, 0.05, 0.1, 0.2, 0.4):
    x, n = denoise(th)
    err = ((x - ref).norm() / ref.norm()).item()
    print(f"{th:>5.2f} {n:>7} {len(sched.timesteps) / n:>6.2f}× {err:>12.3f}")
   阈值    真算步数    加速比    最终潜变量相对误差
 0.00      20   1.00×        0.000
 0.05      19   1.05×        0.007
 0.10      17   1.18×        0.021
 0.20      16   1.25×        0.068
 0.40      12   1.67×        0.218
(这个实现为了取探针仍然跑了整网,所以没有真的省时间,只是把"跳步的逻辑和误差"量出来;真实的 TeaCache 把前几层单独前向,探针的成本只有整网的几个百分点。)
读这张表的方法:阈值越大,真算的步数越少、误差越大,加速比和误差之间是一条曲线,部署时要对着质量指标选一个点。真实模型上的经验值:
| 方法 | 模型 | 典型加速 | 质量代价 | 备注 |
|---|---|---|---|---|
| DeepCache | SD 1.5 / SDXL(UNet) | 2~3× | PSNR 下降不明显 | 深层特征每 N 步重算,浅层每步算 |
| TeaCache | FLUX、HunyuanVideo、Wan、CogVideoX | 1.5~2.5× | 阈值 0.1~0.2 时肉眼难辨,0.3 以上开始糊 | 用时间步嵌入调制后的输入做探针,带一个拟合的多项式校正 |
| FBCache(First-Block Cache) | FLUX、Wan 等 DiT | 1.5~2× | 同上 | 探针是第一个块的输出残差,不需要拟合系数 |
| PAB(Pyramid Attention Broadcast) | 视频 DiT | 1.3~1.5× | 轻微 | 空间 / 时间 / 交叉注意力按不同频率更新,可叠加序列并行 |
| ToCa / 按 token 缓存 | DiT | 1.5~2× | 轻微 | 只重算变化大的 token |
| FORA | DiT | ~2× | 轻微 | 固定每 N 步缓存注意力和 MLP 输出 |
它们的共同点:不改权重、不重训、推理时打开即生效,所以可以和量化、并行、编译叠加——这是它们在部署里受欢迎的根本原因。
误差怎么累积,阈值怎么定
跳过的那一步用的是旧残差,输出和真实值有差;这个差被调度器带进下一步的输入,再影响后面的探针和输出。看连续跳步时误差的增长:
def denoise_fixed(skip_pattern):
    """按固定模式跳步:skip_pattern[i] 为 True 表示第 i 步复用残差。返回最终潜变量。"""
    torch.manual_seed(0)
    x = torch.randn(1, 4, 16, 16)
    last_resid = None
    with torch.no_grad():
        for i, t in enumerate(sched.timesteps):
            if skip_pattern[i] and last_resid is not None:
                out = x + last_resid
            else:
                out = dit(x, timestep=t[None], class_labels=cls).sample[:, :4]
                last_resid = out - x
            x = sched.step(out, t, x).prev_sample
    return x

n = len(sched.timesteps)
patterns = {
    "每隔一步跳一步(跳 10 步)": [i % 2 == 1 for i in range(n)],
    "中间连跳 10 步":            [5 <= i < 15 for i in range(n)],
    "开头连跳 10 步":            [1 <= i < 11 for i in range(n)],
    "结尾连跳 10 步":            [i >= 10 for i in range(n)],
}
for name, pat in patterns.items():
    err = ((denoise_fixed(pat) - ref).norm() / ref.norm()).item()
    print(f"{name:<22} 跳 {sum(pat):>2} 步  相对误差 {err:.3f}")
每隔一步跳一步(跳 10 步)        跳 10 步  相对误差 0.440
中间连跳 10 步              跳 10 步  相对误差 0.755
开头连跳 10 步              跳 10 步  相对误差 0.878
结尾连跳 10 步              跳 10 步  相对误差 0.506
同样跳 10 步,分散着跳远好于连着跳,而在开头连跳最糟(构图阶段的误差会被后面所有步放大)。这就是为什么好的缓存策略都是"累加变化量超过阈值才重算"而不是"每隔 k 步重算":变化快的区间自动多算,变化慢的区间自动多跳;也是为什么各实现都会强制前几步和最后几步不跳。
阈值的定法:固定一批提示词和种子,扫阈值,画加速比对质量(PSNR / SSIM 对不缓存的结果,或者人工打分)的曲线,取"质量开始明显下降之前"的那个点。各模型、各分辨率、各步数的曲线都不同,阈值不能跨模型照搬。
什么时候失效
- 少步模型:4 步的模型每一步都在大幅改变潜变量,相邻步不相似,没有可复用的东西。缓存是给 20 步以上的完整模型用的。
- CFG 的两路:有条件和无条件两路的输入不同,残差也不同,要各缓存一份;只缓存一份会把两路混掉。
- batch 里的请求不同步:如果一个 batch 里不同请求处在不同的时间步,或者有的要跳有的不跳,"整个网络跳过"就做不到——缓存天然偏好"同一请求的多步",这是生成服务调度时要考虑的一点(见生成服务的调度)。
- 分辨率 / 步数变了:阈值要重新扫。
- 和序列并行叠加:探针的距离要在各卡上一致地算(all-reduce 一个标量),否则各卡的跳步决策不同步、通信就会死锁。
怎么讲清楚
讲"扩散模型的缓存加速是怎么回事",先给前提和证据:相邻步输出的相对变化在中间段只有百分之几,可以直接量出来。再分两类:DeepCache 靠 UNet 的跳连复用深层特征;TeaCache / FBCache 用前几层的变化量当探针,累加超过阈值才真算一步,否则复用上一步的残差——探针只占一步的几个百分点,整体 1.5~2.5 倍,不改权重、不重训,能和量化、并行叠加。最后说边界:误差沿步累积所以分散着跳、首尾不跳;少步模型没得缓存;CFG 两路各缓存一份;多卡时跳步决策要同步。
练习
- 把探针从"第一个块的输出"换成"调制后的输入"(在
transformer_blocks[0]上注册 forward pre-hook 取输入),重复第一个实验。两种探针哪个和整网输出的变化更同步?真实的 TeaCache 为什么还要对探针的距离做一个多项式校正?
参考答案
调制后的输入只经过了时间步嵌入的缩放和偏移,它的变化主要反映时间步本身的变化,和整网输出的变化趋势一致但比例不同;第一块输出多经过了一层注意力和 MLP,更接近整网。TeaCache 用拟合的多项式把"输入的距离"映射成"输出的距离"的估计,就是在校正这个比例关系——不同模型的系数不同,所以每个模型要单独拟合。
- 在
denoise里加一条规则:前 3 步和最后 2 步强制真算。阈值 0.2 时真算步数和误差怎么变?
参考答案
真算步数略增(最多多 5 步),误差明显下降,因为开头的误差会被放大、结尾决定细节。几乎所有实现都带这条规则,它的性价比最高。
- 一个视频服务同时开了序列并行(4 卡)和 TeaCache。某次推理卡住不动了,怀疑和缓存有关。可能是什么问题?怎么验证?
参考答案
各卡算出的探针距离略有不同(各自持有不同的 token),导致一张卡决定跳、另一张卡决定真算,真算的那张卡在注意力里等待 all-to-all / all-gather,跳过的那张卡没有发起通信——死锁。验证:在决策处打印各 rank 的 acc 和 skip,看是否一致;修复:对距离做一次 all-reduce(求平均或取最大),让所有 rank 用同一个决策。
小结
- 缓存的前提是相邻步的输出高度相似,可以直接量:中间段的相对变化只有百分之几;前几层的变化量能预测整网的变化量。
- DeepCache 复用 UNet 深层特征;TeaCache / FBCache 用探针累加超过阈值才真算,否则复用上一步的残差;它们不改权重、不重训,1.5~2.5 倍,可与量化、并行叠加。
- 误差沿步累积:分散着跳好于连着跳,开头连跳最糟;用"累加变化量"而不是"固定间隔",并强制首尾不跳;阈值要对每个模型扫质量曲线。
- 失效场景:少步模型、CFG 两路要分别缓存、batch 内请求不同步、多卡时跳步决策要同步。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题