上下文并行:Ring Attention 与 Ulysses
序列一长,激活和注意力的计算都随序列长度增长:128K 的序列,光一层的激活就要几十 GB。张量并行切的是隐藏维度,流水线切的是层,都不直接解决"一条序列太长"的问题。上下文并行(CP)沿**序列**维切分:每张卡只持有一段序列。难点在注意力——每个 token 要看到它之前的所有 token。这一章实现两种主流方案:Ulysses(用 all-to-all 把"切序列"变成"切头")和 Ring Attention(KV 沿着环传一圈),都与单进程的因果注意力逐元素对齐。
自测:能答上来就可以跳过本章
- 除了注意力,Transformer 里的哪些运算可以直接按序列切分、互不通信?
- Ulysses 的两次 all-to-all 分别做了什么?它的并行度受什么限制?
- Ring Attention 每一步传什么?怎样把分块算出的注意力合并成最终结果?
- 因果注意力下,按顺序切分序列为什么会负载不均?怎么解决?
- Ulysses 和 Ring Attention 各适合什么场景?
自测参考答案(先自己答,再展开对照)
- 除了注意力,其他运算(嵌入、归一化、投影、MLP、损失)都是逐 token 独立计算的,按序列切开后各算各的,不需要通信。
- 第一次把"按序列切、每张卡所有头"转成"每张卡完整序列、部分头",然后各自用普通的注意力 kernel 算自己那几个头;第二次再转回去。并行度受头数限制(GQA 下是 KV 头数),不能超过它。
- 每一步把手里的一块 KV 传给下一张卡,同时用当前的 KV 块和本地的 query 算出部分注意力(输出和 log-sum-exp);用 \(\mathrm{lse} = \log(e^{\mathrm{lse}_1} + e^{\mathrm{lse}_2})\)、\(o = o_1 e^{\mathrm{lse}_1 - \mathrm{lse}} + o_2 e^{\mathrm{lse}_2 - \mathrm{lse}}\) 逐块合并。
- 因果掩码下靠后的 token 要看所有前面的 token,拿到最后一段序列的卡计算量最大,拿到第一段的几乎不用算,最慢的卡决定整体速度。之字形切分:切成 \(2P\) 块,每张卡拿一前一后两块,工作量正好互补、完全相同。
- Ulysses:节点内、头数足够时,直接用现成的注意力 kernel,通信是 4 次 all-to-all;Ring Attention:跨节点、超长序列,基本不受头数限制,通信可以和计算重叠。两者也可以组合(节点内 Ulysses、节点间 Ring)。
先看一个六格小剧场,再读正文:
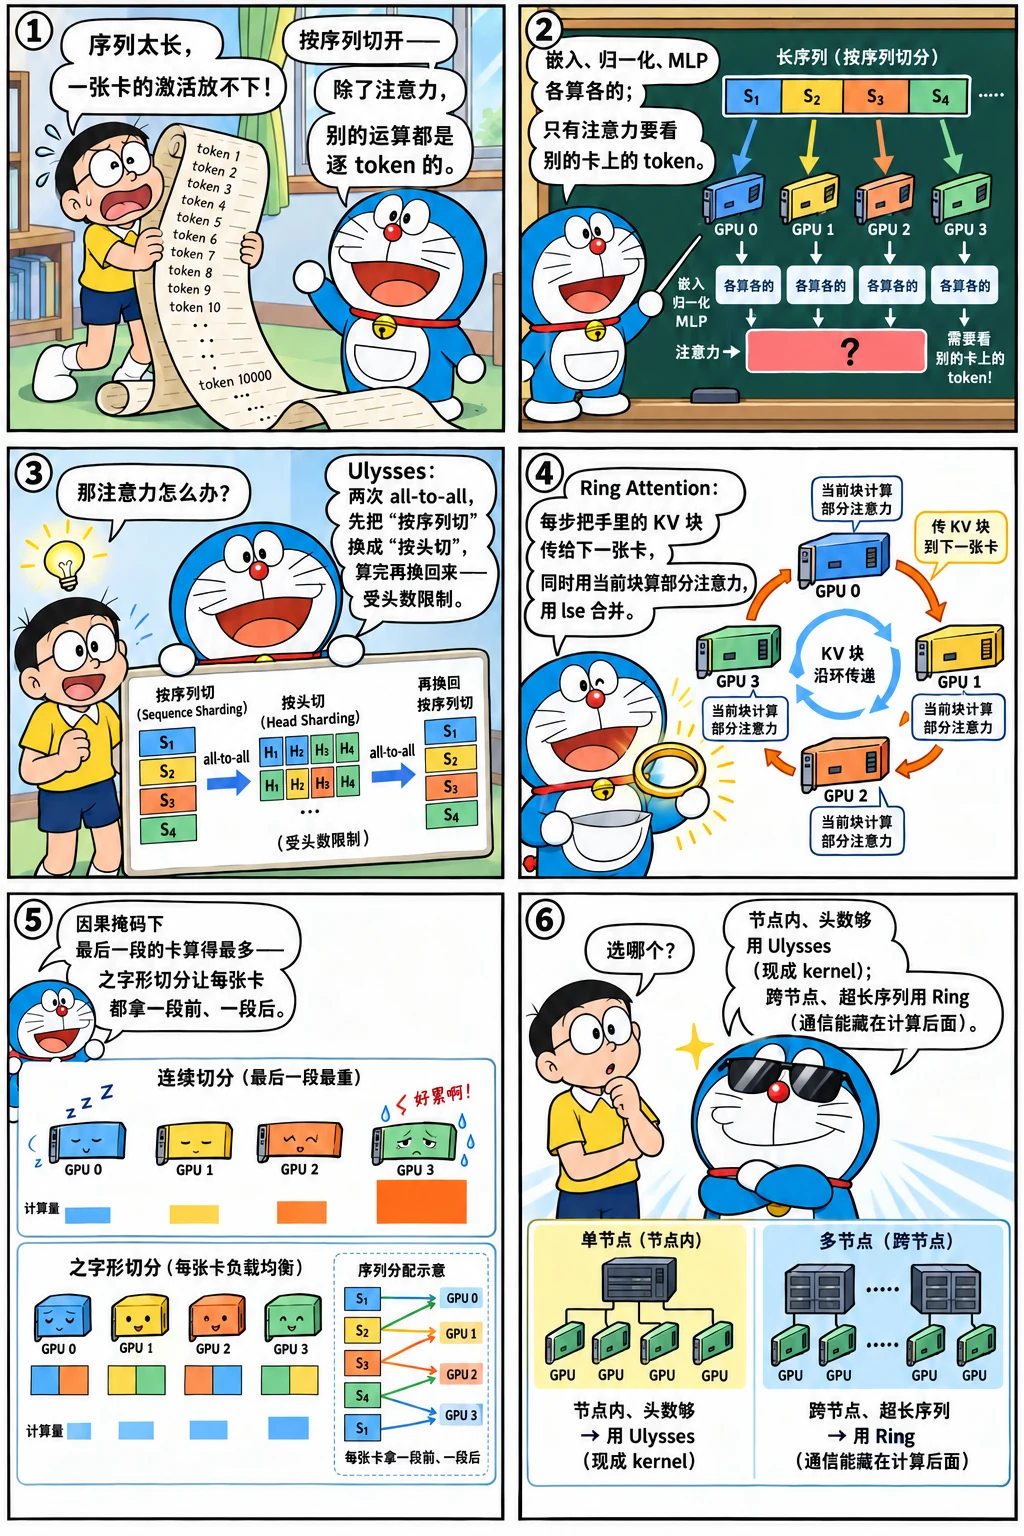
哪些运算可以直接切
LayerNorm、MLP、各种投影都是逐 token 的:切开序列后每张卡各算各的,不需要通信。只有注意力需要跨 token 的信息。所以上下文并行只需要解决一件事:让每个 query 能看到它需要的全部 key 和 value。下面两种方案的公共部分(带 log-sum-exp 输出的因果注意力,以及测试数据):
import torch


def attention(q, k, v, causal=True, q_offset=0, k_offset=0):
    """q: [Sq, H, D], k/v: [Sk, H, D];返回输出和每行的 log-sum-exp(用于合并分块结果)。offset 是这一块在完整序列中的起点。"""
    scores = torch.einsum("qhd,khd->hqk", q, k) / q.shape[-1] ** 0.5
    if causal:
        qi = torch.arange(q.shape[0])[:, None] + q_offset
        ki = torch.arange(k.shape[0])[None, :] + k_offset
        scores = scores.masked_fill(ki > qi, float("-inf"))
    lse = torch.logsumexp(scores, dim=-1)                     # [H, Sq]
    out = torch.einsum("hqk,khd->qhd", torch.exp(scores - lse[..., None]), v)
    return out, lse


def make_qkv(S=32, H=8, D=16):
    torch.manual_seed(0)
    return torch.randn(S, H, D), torch.randn(S, H, D), torch.randn(S, H, D)
Ulysses:在序列和头之间转置
注意力里各个头之间是独立的。Ulysses 的思路:用一次 all-to-all,把每张卡"持有一段序列的全部头"变成"持有全部序列的一部分头",每张卡就能独立地对自己那几个头做完整序列的注意力;算完再用一次 all-to-all 转回来。
import torch
import torch.distributed as dist

from cp_common import attention, make_qkv

dist.init_process_group("gloo")
rank, P = dist.get_rank(), dist.get_world_size()
q, k, v = make_qkv()                        # 完整的 [S, H, D],用来算参照结果和切出本 rank 的输入
S, H, D = q.shape
ref, _ = attention(q, k, v)
rows = slice(rank * S // P, (rank + 1) * S // P)


def seq_to_head(x):
    """[S/P, H, D](本 rank 持有一段序列的全部头)→ [S, H/P, D](全部序列的一部分头)"""
    x = x.reshape(S // P, P, H // P, D).transpose(0, 1).contiguous()   # 按目标 rank 分组:第 p 组是第 p 份头
    out = torch.empty_like(x)
    dist.all_to_all_single(out, x)                                    # 第 p 组发给 rank p;收到的第 r 组来自 rank r 的那段序列
    return out.reshape(S, H // P, D)


def head_to_seq(x):
    """[S, H/P, D] → [S/P, H, D]:上面的逆操作"""
    x = x.reshape(P, S // P, H // P, D).contiguous()                   # 第 p 组是第 p 段序列
    out = torch.empty_like(x)
    dist.all_to_all_single(out, x)
    return out.transpose(0, 1).reshape(S // P, H, D)


ql, kl, vl = seq_to_head(q[rows]), seq_to_head(k[rows]), seq_to_head(v[rows])
out_local, _ = attention(ql, kl, vl)       # 本 rank 对自己的 H/P 个头做完整序列的因果注意力
out = head_to_seq(out_local)
ok = torch.tensor([int(torch.allclose(out, ref[rows], atol=1e-5))])
dist.all_reduce(ok, op=dist.ReduceOp.MIN)
if rank == 0:
    print(f"Ulysses,{P} 个 rank:每个 rank 输入 {tuple(q[rows].shape)},注意力时 {tuple(ql.shape)}")
    print("输出与单进程的因果注意力一致:", bool(ok.item()))
dist.destroy_process_group()
- 每次 all-to-all 每张卡发出 \((P-1)/P\) 的数据;\(q\)、\(k\)、\(v\) 各一次,输出一次,通信量和序列长度成正比,与 CP 的度数基本无关;
- 注意力部分直接调用现成的 FlashAttention,不需要改 kernel——这是 Ulysses 最大的优点;
- 限制:并行度不能超过注意力头数(GQA 下更严,不能超过 KV 头数,除非复制 KV),而且 all-to-all 在跨节点时代价较高。
Ring Attention:KV 沿环传一圈
Ring Attention 不动头,而是让每张卡保留自己那段 query,把 KV 块沿着环依次传给下一张卡。\(P\) 步之后每段 query 都见过了所有的 KV 块。每一步算出的是"这段 query 对某一块 KV"的部分注意力,用 log-sum-exp 合并(和 FlashAttention 的 online softmax 是同一个公式):
import torch
import torch.distributed as dist

from cp_common import attention, make_qkv

dist.init_process_group("gloo")
rank, P = dist.get_rank(), dist.get_world_size()
q, k, v = make_qkv()
S = q.shape[0]
ref, _ = attention(q, k, v)
C = S // P
mine = slice(rank * C, (rank + 1) * C)
q_l, kv = q[mine], torch.stack([k[mine], v[mine]])          # 本 rank 的 query 块和 KV 块

out, lse = None, None
src = rank                                                    # 当前手里的 KV 块来自哪个 rank(即序列里的第几块)
computed = 0
for step in range(P):
    if src <= rank:                                           # 因果:只有不晚于自己的 KV 块才有贡献
        o, l = attention(q_l, kv[0], kv[1], causal=True, q_offset=rank * C, k_offset=src * C)
        if out is None:
            out, lse = o, l
        else:                                                 # 用 log-sum-exp 合并两部分注意力(online softmax)
            new = torch.logaddexp(lse, l)
            out = out * torch.exp(lse - new).T[..., None] + o * torch.exp(l - new).T[..., None]
            lse = new
        computed += 1
    if step < P - 1:                                          # 把 KV 块传给右边,从左边接收下一块
        recv = torch.empty_like(kv)
        reqs = [dist.isend(kv, (rank + 1) % P), dist.irecv(recv, (rank - 1) % P)]
        for r in reqs:
            r.wait()
        kv, src = recv, (src - 1) % P

ok = torch.tensor([int(torch.allclose(out, ref[mine], atol=1e-5))])
dist.all_reduce(ok, op=dist.ReduceOp.MIN)
counts = [None] * P
dist.all_gather_object(counts, computed)
if rank == 0:
    print(f"Ring Attention,{P} 个 rank:输出与单进程的因果注意力一致:", bool(ok.item()))
    print("每个 rank 实际计算的块数:", counts)
dist.destroy_process_group()
- 每一步传一块 KV 的同时计算上一块,通信可以和计算重叠——只要一块的计算时间比传输时间长(序列足够长时成立);
- 对头数没有限制,可以扩展到很多张卡、跨节点;
- 问题在最后一行:因果掩码让负载不均。rank 0 的 query 在序列最前面,只需要看第一块 KV;rank 3 要看全部 4 块。最慢的 rank 决定了整体速度。
之字形切分
把序列切成 \(2P\) 块,rank \(r\) 拿第 \(r\) 块和倒数第 \(r+1\) 块:一段靠前(计算少)、一段靠后(计算多),正好互补:
def work(query_chunks, n_chunks):
    """因果注意力里,一个 query 块需要和多少个 KV 块做计算(对角线上的块算半个)"""
    return sum(q + 0.5 for q in query_chunks)


P = 4
contiguous = {r: [2 * r, 2 * r + 1] for r in range(P)}          # 按顺序切:rank r 拿第 2r、2r+1 块(共 2P 块)
zigzag = {r: [r, 2 * P - 1 - r] for r in range(P)}               # 之字形:rank r 拿第 r 块和倒数第 r+1 块
for name, split in (("顺序切分", contiguous), ("之字形切分", zigzag)):
    print(name, [work(split[r], 2 * P) for r in range(P)])
Megatron 的上下文并行、Llama 3 的长上下文训练都用这种切法(或类似的条带式切分)。
怎么选
| Ulysses | Ring Attention | |
|---|---|---|
| 通信 | 4 次 all-to-all(q、k、v、输出) | \(P-1\) 次点对点传 KV,可与计算重叠 |
| 并行度上限 | 头数(GQA 下是 KV 头数) | 基本无限制 |
| 注意力 kernel | 现成的 FlashAttention | 需要支持分块和 LSE 合并(或者在外面合并) |
| 适合 | 节点内、头数足够时 | 跨节点、超长序列 |
两者也可以组合:节点内用 Ulysses,节点间用 Ring(USP 等方案)。推理的 prefill 阶段面对超长 prompt 时也会用同样的方法(见推理系统手册的流水线并行与上下文并行)。
怎么讲清楚
讲上下文并行:逐 token 的运算直接按序列切、不用通信,只有注意力需要别的段的 KV。Ulysses 用两次 all-to-all 在"切序列"和"切头"之间转置,能直接用现成的注意力 kernel,但并行度受头数(GQA 下是 KV 头数)限制;Ring Attention 让 KV 块沿环传一圈,用 log-sum-exp 合并各块的结果,能和计算重叠、扩展到很多卡。因果掩码让顺序切分负载不均(最后一段要算全部),之字形切分——每个 rank 拿一前一后两块——让每一步每个 rank 的计算量都相同。节点内 Ulysses、节点间 Ring 也可以组合。
练习
- Ulysses 在 GQA 模型上(32 个 query 头、8 个 KV 头)最多能用多少路上下文并行而不复制 KV?如果要用 16 路,该怎么办?
参考答案
每个 rank 至少要分到一个完整的 KV 头,所以最多 8 路。要用 16 路,可以把每个 KV 头复制到两个 rank 上(all-to-all 之前先按组复制 KV),或者节点内用 8 路 Ulysses、再在外面套一层 2 路的 Ring Attention。
- Ring Attention 里,每一步是先算再传,还是先传再算?怎样写才能让通信和计算重叠?
参考答案
本章的实现为了清楚,是"算完这一块再同步地传下一块"。要重叠,就在开始计算当前块之前发起下一块的异步 isend / irecv,算完之后再 wait:通信在后台和计算同时进行。GPU 上还要把通信放在单独的 stream 上。只要每块的计算时间长于传输时间(序列越长越容易满足),通信就被完全藏住了。
小结
- 上下文并行沿序列切分;逐 token 的运算不需要通信,只有注意力需要跨段的 KV。
- Ulysses 用 all-to-all 在"切序列"和"切头"之间转置,可直接用现成的注意力 kernel,并行度受头数限制。
- Ring Attention 让 KV 块沿环传递,用 log-sum-exp 合并分块结果,可与计算重叠、扩展性好。
- 因果掩码导致顺序切分负载不均,之字形切分让每个 rank 的计算量相同。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题