参数量、算力与显存估算
"这个模型要几张卡?""这台机器能撑多少并发?""decode 最快能多快?"这些问题在推理工作中每天都会遇到,而且都能用几个简单的公式估算出来。这一章把前面各章的计算整理成一套估算方法,写成一个小工具,并用官方模型配置核对。
自测:能答上来就可以跳过本章
- 给你一个
config.json,怎么算出参数量? - 每个 token 的前向计算量是多少?注意力部分怎么算?
- 部署一个模型,显存由哪几部分组成?
- decode 每个 token 的延迟下限怎么估算?prefill 呢?
- 为什么 70B 模型在 8 张卡上做张量并行后,decode 延迟可以和单卡跑 8B 差不多?
自测参考答案(先自己答,再展开对照)
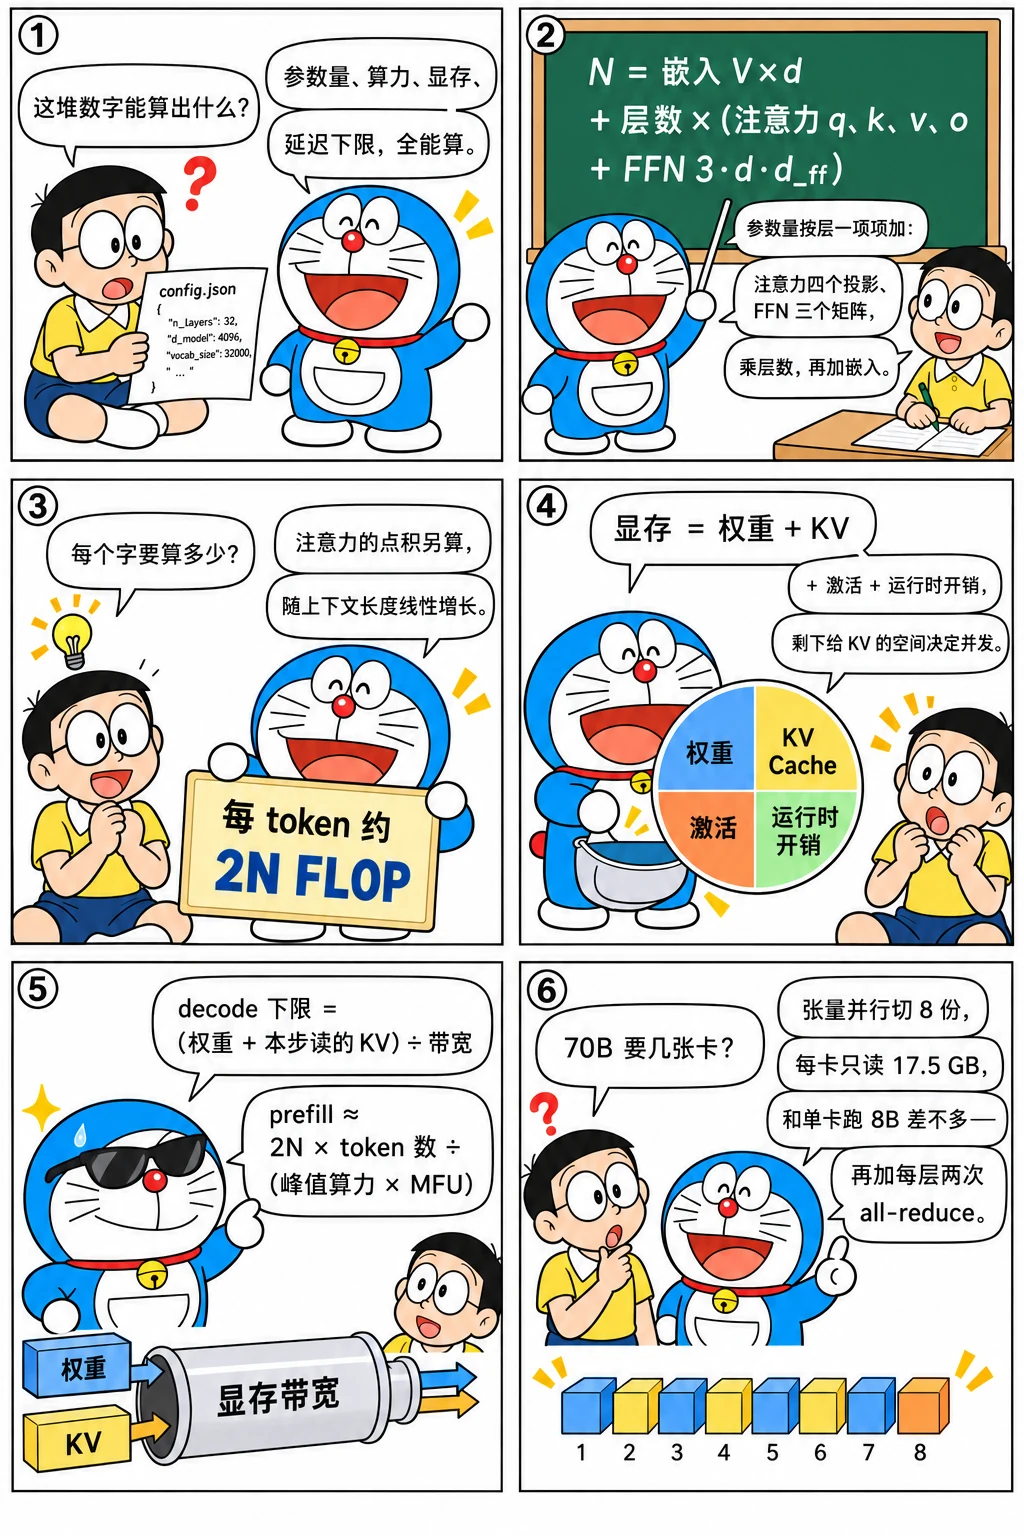
- 嵌入层 \(V \times d\)(不共享时输出层再算一份)+ 每层(q、k、v、o 四个投影按头数和头维算 + FFN 的 \(3 \cdot d \cdot d_{ff}\) + 两个归一化的 \(2d\))× 层数 + 最后的归一化 \(d\);MoE 按专家数展开 FFN。
- 约 \(2N\)(N 是参与计算的参数量,嵌入查表不算);注意力的点积和加权求和另算,每层约 \(4 \cdot d \cdot\) 上下文长度,与上下文长度成正比。
- 权重 + KV Cache + 激活(中间结果)+ 运行时开销(CUDA 上下文、通信缓冲区、CUDA Graph 等);剩下给 KV 的空间决定了能有多少并发。
- decode 下限 = (权重字节 + 本步要读的 KV 字节) ÷ 显存带宽;prefill ≈ \(2N \times\) token 数 ÷ (峰值算力 × MFU)。
- 张量并行后每张卡只存、只读 1/8 的权重:70B × 2 字节 ÷ 8 ≈ 17.5 GB,和单卡读 8B 的 16 GB 差不多;再加上每层两次 all-reduce 的开销。
先看一个六格小剧场,再读正文:
参数量
LLaMA/Qwen 结构的稠密模型,参数由这几部分组成:
Qwen2 的 q、k、v 投影还有偏置(\(n_h d_h + 2 n_{kv} d_h\));Qwen3 去掉了偏置,但每层多了 QK-Norm 的两个权重(\(2 d_h\))。写成代码,直接读取 config.json 的字段:
"""estimate.py —— 从模型配置估算参数量、计算量、显存和延迟下限(稠密的 LLaMA / Qwen2 / Qwen3 结构)。"""

from dataclasses import dataclass


def count_params(c: dict) -> int:
    V, d, L, dff = c["vocab_size"], c["hidden_size"], c["num_hidden_layers"], c["intermediate_size"]
    nh = c["num_attention_heads"]
    nkv = c.get("num_key_value_heads", nh)
    hd = c.get("head_dim") or d // nh
    attn = d * nh * hd + 2 * d * nkv * hd + nh * hd * d
    if c.get("attention_bias", c.get("model_type") == "qwen2"):
        attn += nh * hd + 2 * nkv * hd
    if c.get("model_type") == "qwen3":
        attn += 2 * hd                              # QK-Norm:q_norm、k_norm 各一个长度为 d_h 的权重
    layer = attn + 3 * d * dff + 2 * d
    emb = V * d * (1 if c.get("tie_word_embeddings", False) else 2)
    return emb + L * layer + d


def kv_bytes_per_token(c: dict, bytes_per_elem: float = 2) -> float:
    nh = c["num_attention_heads"]
    hd = c.get("head_dim") or c["hidden_size"] // nh
    return 2 * c["num_hidden_layers"] * c.get("num_key_value_heads", nh) * hd * bytes_per_elem


def flops_per_token(c: dict, context: int) -> float:
    """前向计算量:线性层 2 × 参数(不含嵌入查表),加上注意力的 QK^T 与 PV(与上下文长度成正比)。"""
    V, d = c["vocab_size"], c["hidden_size"]
    nh = c["num_attention_heads"]
    hd = c.get("head_dim") or d // nh
    linear = 2 * (count_params(c) - V * d)          # 嵌入是查表,不算乘法;输出层要算
    attention = 2 * 2 * c["num_hidden_layers"] * context * nh * hd
    return linear + attention


@dataclass
class GPU:
    name: str
    mem_gb: float
    bw_tbs: float        # 显存带宽 TB/s
    tflops: float        # BF16 稠密峰值


H100 = GPU("H100 SXM", 80, 3.35, 989)
A100 = GPU("A100 80GB", 80, 2.039, 312)


def decode_latency_ms(c, batch, context, gpu: GPU, n_gpus=1, weight_bytes=2, kv_bytes=2):
    """decode 一步的延迟下限:每步至少读一遍权重和全部请求的 KV Cache(假设完美的张量并行)。"""
    total = count_params(c) * weight_bytes + batch * context * kv_bytes_per_token(c, kv_bytes)
    return total / (gpu.bw_tbs * 1e12 * n_gpus) * 1e3


def prefill_ms(c, tokens, gpu: GPU, n_gpus=1, mfu=0.5):
    """prefill 的延迟估计:总计算量 / (峰值 × 利用率)。注意力按平均上下文 tokens/2 估算。"""
    return tokens * flops_per_token(c, tokens // 2) / (gpu.tflops * 1e12 * mfu * n_gpus) * 1e3
用官方配置核对:用 transformers 在 meta 设备上构建模型(不分配内存),数出真实的参数量,和公式比较:
import json
import torch
from transformers import AutoConfig, AutoModelForCausalLM
from estimate import count_params

configs = {
    "Qwen3-0.6B": json.load(open("models/Qwen3-0.6B/config.json")),
    "LLaMA-2-7B": dict(model_type="llama", vocab_size=32000, hidden_size=4096, intermediate_size=11008,
                       num_hidden_layers=32, num_attention_heads=32, num_key_value_heads=32),
    "LLaMA-3-8B": dict(model_type="llama", vocab_size=128256, hidden_size=4096, intermediate_size=14336,
                       num_hidden_layers=32, num_attention_heads=32, num_key_value_heads=8),
    "LLaMA-3-70B": dict(model_type="llama", vocab_size=128256, hidden_size=8192, intermediate_size=28672,
                        num_hidden_layers=80, num_attention_heads=64, num_key_value_heads=8),
    "Qwen2.5-7B": dict(model_type="qwen2", vocab_size=152064, hidden_size=3584, intermediate_size=18944,
                       num_hidden_layers=28, num_attention_heads=28, num_key_value_heads=4),
    "Qwen2.5-72B": dict(model_type="qwen2", vocab_size=152064, hidden_size=8192, intermediate_size=29568,
                        num_hidden_layers=80, num_attention_heads=64, num_key_value_heads=8),
}
for name, c in configs.items():
    cfg = AutoConfig.for_model(**{k: v for k, v in c.items() if k not in ("architectures", "torch_dtype", "transformers_version")})
    with torch.device("meta"):
        real = sum(p.numel() for p in AutoModelForCausalLM.from_config(cfg).parameters())
    ours = count_params(c)
    print(f"{name:14s} 公式 {ours / 1e9:7.3f}B   transformers {real / 1e9:7.3f}B")
    assert ours == real
每一个都与 transformers 构建出的模型精确相等。熟练之后,看一眼配置就能心算出大概:层数 × (4d² 左右的注意力 + 3d·d_ff 的 FFN) + 词表 × d。
计算量
前面说过线性层每个参数每个 token 贡献 2 次运算。再加上注意力本身(每层 \(QK^\top\) 和 \(PV\) 各 \(2 \times \text{上下文长度} \times n_h d_h\)):
S 是当前的上下文长度。上下文较短时第一项占绝对主导,常说的"每个 token 约 2N 次运算"就是这么来的;上下文很长时第二项不可忽略:
from estimate import flops_per_token

c = configs["LLaMA-3-8B"]
for S in (1_000, 8_000, 32_000, 128_000):
    f = flops_per_token(c, S)
    attn_share = 1 - flops_per_token(c, 0) / f
    print(f"上下文 {S:>7,d}: {f / 1e9:6.1f} GFLOPs/token,其中注意力占 {attn_share:.0%}")
显存
部署时的显存大致由四部分组成:
| 部分 | 大小 | 说明 |
|---|---|---|
| 权重 | 参数量 × 每参数字节数 | BF16 为 2,FP8/INT8 为 1,INT4 约 0.5(另加缩放因子) |
| KV Cache | 并发请求数 × 上下文长度 × 每 token KV 字节数 | 占用剩余显存的大部分,决定并发能力 |
| 激活 | 与 batch 中的 token 数成正比 | 推理时不保存中间结果,通常只需几 GB 的工作区 |
| 其他 | CUDA 上下文、CUDA Graphs、通信缓冲区等 | 通常预留几 GB |
vLLM 的 gpu_memory_utilization(默认 0.9)就是"权重 + 激活 + KV Cache 总共最多用多少比例的显存",扣掉权重和激活之后,剩下的全部预分配给 KV Cache 的块池。
延迟的下限
decode:每一步至少要把权重和所有请求的 KV Cache 从显存读一遍:
prefill:主要受算力限制:
用这两个公式评估几个部署方案:
from estimate import H100, decode_latency_ms, kv_bytes_per_token, prefill_ms

def report(name, c, batch, ctx, n_gpus=1, weight_bytes=2):
    w_gb = count_params(c) * weight_bytes / 1e9
    kv_gb = batch * ctx * kv_bytes_per_token(c) / 1e9
    tpot = decode_latency_ms(c, batch, ctx, H100, n_gpus, weight_bytes)
    print(f"{name:28s} 权重 {w_gb:6.1f} GB,KV {kv_gb:6.1f} GB,TPOT ≥ {tpot:5.1f} ms,"
          f"单请求 ≤ {1000 / tpot:5.0f} tok/s,总吞吐 ≤ {batch * 1000 / tpot:6.0f} tok/s")

report("8B,1×H100,batch 1", configs["LLaMA-3-8B"], 1, 4096)
report("8B,1×H100,batch 64", configs["LLaMA-3-8B"], 64, 4096)
report("8B INT4 权重,batch 1", configs["LLaMA-3-8B"], 1, 4096, weight_bytes=0.5)
report("70B,8×H100 TP,batch 1", configs["LLaMA-3-70B"], 1, 4096, n_gpus=8)
report("70B,8×H100 TP,batch 64", configs["LLaMA-3-70B"], 64, 4096, n_gpus=8)
print(f"8B prefill 2000 个 token,1×H100,MFU 50%:TTFT ≈ {prefill_ms(configs['LLaMA-3-8B'], 2000, H100):.0f} ms")
几个值得注意的结论:
- batch 从 1 增加到 64,总吞吐提高了约 21 倍(202 → 4252 tok/s),TPOT 下限只从 5 ms 增加到 15 ms,这就是批处理的威力。增加的延迟几乎全部来自 KV Cache:64 个 4K 上下文的请求,KV 共 34 GB,是权重的两倍多;
- INT4 权重量化让 batch 1 的 decode 下限从 5.0 ms 降到 1.4 ms,因为此时几乎全部时间都在读权重,见量化原理;
- 70B 在 8 卡张量并行下,单请求的 decode 下限(5.3 ms)和单卡跑 8B(5.0 ms)几乎一样:8 张卡的带宽加在一起,每张卡只读 1/8 的权重。实际上还要加上每层两次 all-reduce 的通信延迟,所以 TP 不是免费的,参见 CUDA 手册的多 GPU 与 NCCL;
- 这些都是理论下限。实际系统能达到带宽利用率的 70%-85% 就很不错了。
把这几个公式做成一个计算器:换模型、换卡、换精度、拉 batch 和上下文,看参数量、每 token 的计算量、decode 一步要读多少字节、TPOT 和 TTFT 的下限怎么变:
推理视角
估算是推理优化工作的起点:先算出理论上限,再和实测比较。如果实测 TPOT 是理论下限的 3 倍,说明还有很大的优化空间(kernel 不够快?调度开销?CPU 瓶颈?);如果已经达到下限的 80%,想再快就只能改变"读多少字节"本身:量化、更大的 batch、投机解码。
怎么讲清楚
讲估算:按模板算就行——参数量从 config.json 算(嵌入 + 每层注意力与 FFN);每个 token 的计算约 2N,再加上与上下文成正比的注意力项;显存 = 权重 + KV + 激活 + 运行时开销;decode 延迟下限 = (权重 + KV) 字节 ÷ 带宽,prefill ≈ 计算量 ÷ (算力 × MFU)。例如 LLaMA-3-8B 在 H100 上 batch 1:16 GB ÷ 3.35 TB/s ≈ 4.8 ms/token。70B 做 8 卡张量并行后每张卡只读 1/8 的权重,所以 decode 延迟和单卡 8B 相近,再加上 all-reduce 的开销。
练习
1. 部署规划。 要用 BF16 部署 Qwen2.5-72B,要求支持 32 个并发请求、每个请求 8K 上下文。至少需要几张 80 GB 的 GPU?(为激活和其他开销每张卡预留 8 GB。)
参考答案
import math
c = configs["Qwen2.5-72B"]
need = count_params(c) * 2 + 32 * 8192 * kv_bytes_per_token(c)
n = math.ceil(need / ((80 - 8) * 1e9))
print(f"权重 {count_params(c) * 2 / 1e9:.0f} GB + KV {32 * 8192 * kv_bytes_per_token(c) / 1e9:.0f} GB -> 至少 {n} 张")
权重约 145 GB,KV 约 86 GB,总共约 231 GB,至少需要 4 张卡;张量并行的卡数一般取 2 的幂且能整除注意力头数,所以实际会用 4 张或 8 张。
2. 思考题。 为什么说"decode 的延迟下限和模型的算力无关"?什么时候这句话不成立?
参考答案
decode 的 batch 较小时,计算量远小于算力上限,耗时由读取的字节数决定,算力再强也无济于事。当 batch 大到每步的计算时间超过读取时间时(算术强度超过脊点,比如 H100 上 BF16 的 batch 达到几百),decode 就变成了计算瓶颈,这时算力才重要。MoE 模型、MLA、投机解码都会让 decode 的算术强度更高,更早地进入计算瓶颈区域。
小结
- 稠密模型参数量 = 词表 × d(×2 若不共享)+ 层数 × (注意力 + 3·d·d_ff + 2d) + d,可以精确计算。
- 每个 token 的计算量约 2N,再加上与上下文长度成正比的注意力项。
- 显存 = 权重 + KV Cache + 激活 + 其他;KV Cache 决定并发。
- decode 延迟下限 = (权重 + KV) 字节数 / 带宽;prefill 延迟 ≈ 计算量 / (算力 × MFU)。
- 先算理论上限再看实测,是推理优化的基本方法。
相关的数学:算术强度与屋顶线、Amdahl 定律见性能与服务中的数学。
本章练习题(2 道)
在浏览器里直接写代码、跑测试;也可以在本地用 python practice/judge.py 判题。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题