量化原理
量化用更少的比特表示权重和激活:权重从 16 位变成 8 位、4 位,decode 时要读取的字节数就成比例减少;激活也量化后,还能用 INT8/FP8 的 Tensor Core 加速计算。这一章讲清楚量化的数学、粒度和主流方法,并在真实模型上做实验:不同粒度的误差差多少,激活离群值为什么让量化变难,SmoothQuant 怎么解决。
自测:能答上来就可以跳过本章
- 对称量化和非对称量化分别怎么计算缩放因子和零点?
- 按张量、按通道、按组量化的区别是什么?为什么 INT4 几乎都按组量化?
- weight-only 量化和 W8A8 量化分别加速了什么?
- 激活离群值为什么让量化变难?SmoothQuant 怎么解决?
- GPTQ 和 AWQ 的核心思想分别是什么?
自测参考答案(先自己答,再展开对照)
- 对称:缩放 \(s = \max|x| / (2^{b-1} - 1)\),零点为 0;非对称:\(s = (\max - \min) / (2^b - 1)\),零点 \(z = \mathrm{round}(-\min / s)\),能用满范围但多存一个零点。
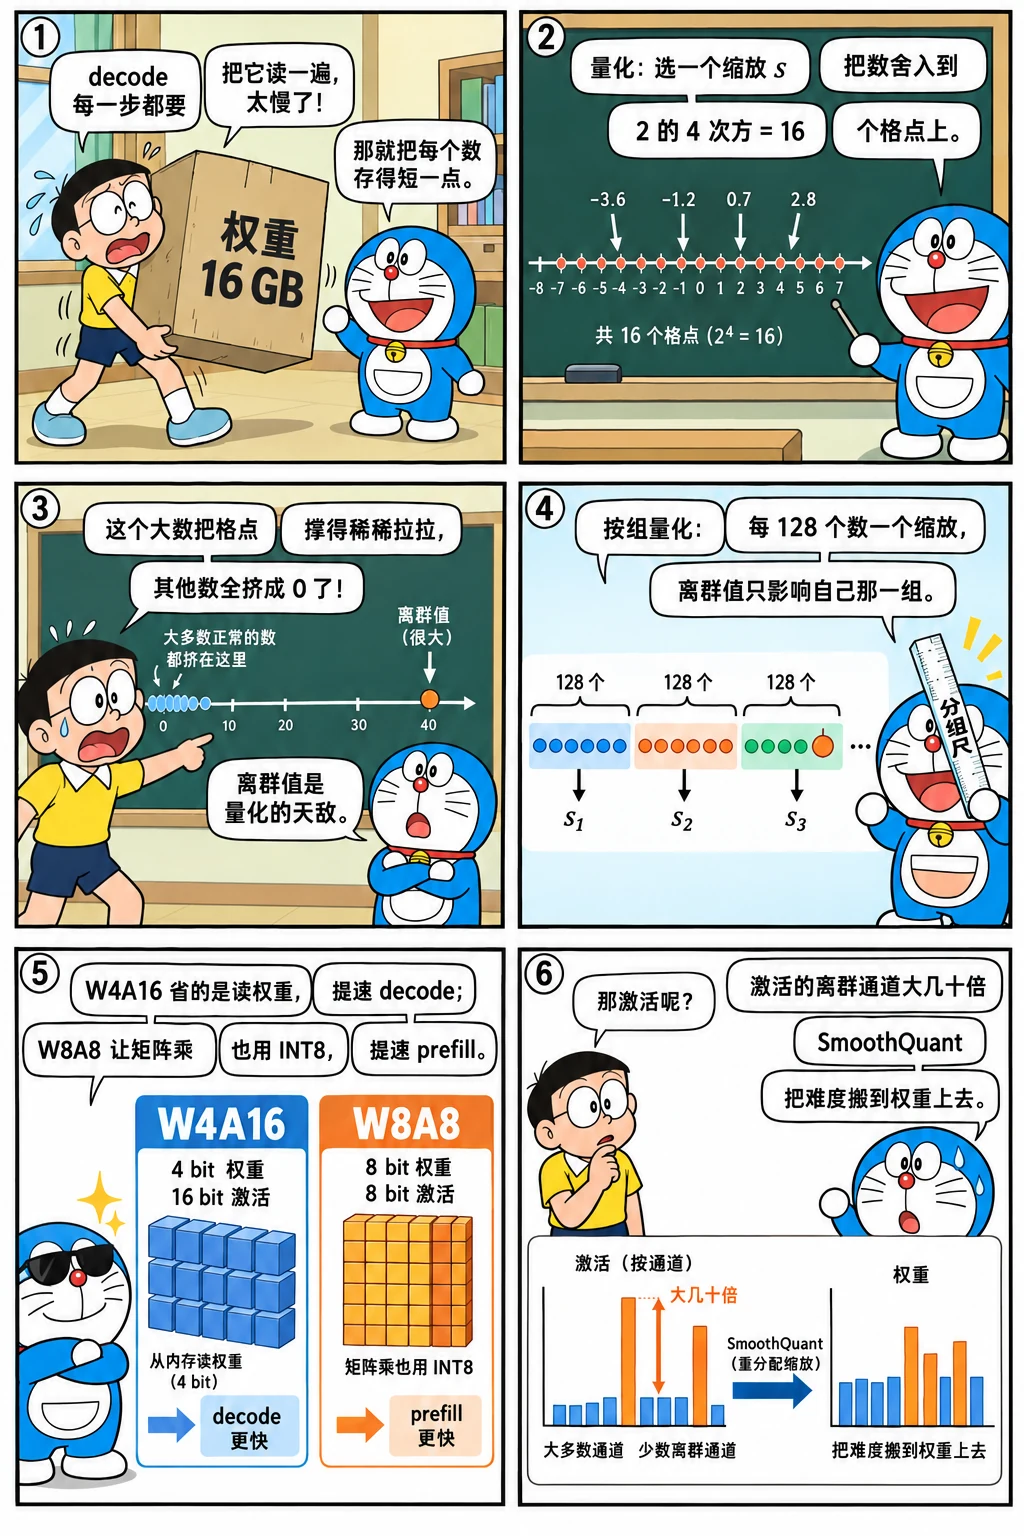
- 按张量一组一个缩放、按通道每个输出通道一个、按组每连续若干个(如 128)一个;粒度越细,一个离群值影响的数越少。INT4 只有 16 个量化级别,整行一个缩放误差太大,所以几乎都按组量化。
- weight-only(如 W4A16)减少的是读权重的字节,加速访存受限的 decode,计算仍用 16 位;W8A8 让矩阵乘也用 INT8 Tensor Core,同时加速计算,对 prefill 和大 batch 有效。
- 少数通道的激活比其他大几十上百倍,按张量或按 token 量化时它们决定了缩放,其余数值被压到很少的几个级别。SmoothQuant 把激活按通道除以 \(s\)、权重乘以 \(s\)(数学上等价),把量化难度从激活挪到更好量化的权重上。
- GPTQ:逐层量化,用激活的二阶信息 \(H = X^\top X\) 把每个权重的量化误差补偿到还没量化的权重上;AWQ:按激活的幅度找出重要的通道,量化前先放大它们(等价缩放),减少这些通道的相对误差。
先看一个六格小剧场,再读正文:
量化的数学
把浮点数 \(x\) 映射到 b 位整数。对称量化:
非对称量化多一个零点 \(z\),把 \([\min, \max]\) 映射到 \([0, 2^b - 1]\),适合分布不以 0 为中心的数据(CUDA 手册的 INT4 GEMV 用的就是非对称按组量化)。
误差来自两处:舍入误差(每个数最多偏离半个量化步长 \(s/2\))和截断误差(超出范围的数被截断,通常通过选择合适的 \(s\) 避免)。量化步长 \(s\) 由这组数中的最大绝对值决定,所以一个离群的大数会让所有普通的数都变得不精确,这是理解量化的关键。
把一行 1024 个权重里塞进一个离群值,看它怎么把量化格点撑开、把其余的数压成 0,再换成按组量化看它被隔离的效果:
粒度:多少个数共用一个缩放因子
| 粒度 | 共用缩放因子的范围 | 额外开销 | 精度 |
|---|---|---|---|
| 按张量(per-tensor) | 整个矩阵 | 可忽略 | 最差:一个离群值影响全部 |
| 按通道(per-channel) | 权重矩阵的每一行(每个输出通道) | 很小 | 好 |
| 按组(per-group) | 每行内每 G 个连续元素(G 常为 128) | 每 G 个数一个缩放因子 | 更好,INT4 的标准做法 |
| 按块(block-wise) | 例如 128×128 的块 | 小 | DeepSeek-V3 的 FP8 权重使用 |
在 Qwen3-0.6B 的一个真实权重矩阵上比较:
"""quant.py —— 对称的伪量化(量化后立刻反量化),用于评估误差。"""

import torch


def fake_quant_int(w: torch.Tensor, bits: int, granularity: str = "channel", group: int = 128) -> torch.Tensor:
    out_f, in_f = w.shape
    if granularity == "tensor":
        g = w.reshape(1, 1, -1)
    elif granularity == "channel":
        g = w.reshape(out_f, 1, in_f)
    else:                                                     # "group"
        g = w.reshape(out_f, in_f // group, group)
    qmax = 2 ** (bits - 1) - 1
    scale = g.abs().amax(dim=-1, keepdim=True).clamp(min=1e-8) / qmax
    q = (g / scale).round().clamp(-qmax - 1, qmax)
    return (q * scale).reshape(w.shape)


def fake_quant_fp8(w: torch.Tensor) -> torch.Tensor:
    scale = w.abs().max() / 448.0                             # E4M3 的最大值是 448
    return (w / scale).to(torch.float8_e4m3fn).float() * scale


def rel_error(approx: torch.Tensor, exact: torch.Tensor) -> float:
    return ((approx - exact).norm() / exact.norm()).item()
import torch
from mini_llm import Transformer
from quant import fake_quant_fp8, fake_quant_int, rel_error

model = Transformer.from_pretrained("models/Qwen3-0.6B")
W = model.layers[0].mlp.down_proj.weight.data                  # [1024, 3072]
results = {
    "INT8 按张量": rel_error(fake_quant_int(W, 8, "tensor"), W),
    "INT8 按通道": rel_error(fake_quant_int(W, 8, "channel"), W),
    "FP8 E4M3 按张量": rel_error(fake_quant_fp8(W), W),
    "INT4 按通道": rel_error(fake_quant_int(W, 4, "channel"), W),
    "INT4 按组(G=128)": rel_error(fake_quant_int(W, 4, "group"), W),
}
for name, e in results.items():
    print(f"{name:18s} 相对误差 {e:.4f}")
assert results["INT8 按通道"] < results["INT8 按张量"] and results["INT4 按组(G=128)"] < results["INT4 按通道"]
在本手册的环境里:
INT8 按张量           相对误差 0.0362
INT8 按通道           相对误差 0.0097
FP8 E4M3 按张量       相对误差 0.0265
INT4 按通道           相对误差 0.1762
INT4 按组(G=128)     相对误差 0.1240
几个观察:INT8 按通道的误差只有按张量的 1/4 左右;FP8 即使按张量量化,误差也比 INT8 按张量小,因为浮点格式对大小不同的数有自适应的精度;INT4 只有 16 个量化级别,误差大了一个数量级,按组量化明显好于按通道。
对整个模型做 weight-only 量化
把所有线性层(注意力的 4 个投影和 FFN 的 3 个投影)都做伪量化,在一段文本上比较困惑度:
import copy
import math
from transformers import AutoTokenizer

tok = AutoTokenizer.from_pretrained("models/Qwen3-0.6B")
text = ("大语言模型的推理过程分为两个阶段。在预填充阶段,模型一次性处理用户输入的全部提示词,计算每个位置的键和值并写入缓存。"
        "在解码阶段,模型每次只生成一个新的词元,需要读取全部的模型权重和已经缓存的键值。由于每一步的计算量很小而读取的数据量很大,"
        "解码阶段通常受限于显存带宽。为了提高吞吐量,推理系统会把多个请求合并成一个批次,让它们共享同一次权重读取。"
        "量化通过降低权重和激活的数值精度来减少需要读取的字节数,是加速解码的常用方法。")
ids = tok(text, return_tensors="pt").input_ids

@torch.no_grad()
def perplexity(m):
    logits = m(ids)
    return math.exp(torch.nn.functional.cross_entropy(logits[0, :-1], ids[0, 1:]).item())

def quantize_model(m, fn):
    m = copy.deepcopy(m)
    for layer in m.layers:
        a, f = layer.self_attn, layer.mlp
        for lin in (a.q_proj, a.k_proj, a.v_proj, a.o_proj, f.gate_proj, f.up_proj, f.down_proj):
            lin.weight.data = fn(lin.weight.data)
    return m

ppl = {"FP32": perplexity(model)}
for name, fn in [("W8 按通道", lambda w: fake_quant_int(w, 8, "channel")),
                 ("W4 按组 G=128", lambda w: fake_quant_int(w, 4, "group")),
                 ("W4 按通道", lambda w: fake_quant_int(w, 4, "channel")),
                 ("W3 按组 G=128", lambda w: fake_quant_int(w, 3, "group"))]:
    ppl[name] = perplexity(quantize_model(model, fn))
for name, v in ppl.items():
    print(f"{name:14s} 困惑度 {v:8.2f}")
assert abs(ppl["W8 按通道"] - ppl["FP32"]) / ppl["FP32"] < 0.02
assert ppl["W4 按组 G=128"] < ppl["W4 按通道"] < ppl["W3 按组 G=128"]
在本手册的环境里:
- INT8 按通道几乎无损,这就是 W8 量化如此普及的原因;
- INT4 用最朴素的"四舍五入"(RTN)量化,困惑度上升了约 60%,而且 0.6B 这样的小模型对量化格外敏感(大模型的冗余更多,通常更耐量化);按组量化(41.49)比按通道(55.02)好;
- 3 位的朴素量化则基本不可用。
这就是为什么 INT4 需要比 RTN 更聪明的方法。
GPTQ 与 AWQ
GPTQ(Frantar 等,2022):逐列量化权重,每量化一列,就利用校准数据的二阶信息(输入的协方差),调整尚未量化的列来补偿这一列引入的误差。目标是让量化后这一层的输出(而不是权重本身)尽量接近原来的输出。
AWQ(Lin 等,2023):观察到只有约 1% 的权重通道特别重要,它们对应的输入激活通常很大。与其保护这些权重不被量化,不如在量化前把这些通道乘以一个大于 1 的系数(等价地把对应的激活除以这个系数),让它们在量化时获得更高的相对精度。系数用少量校准数据搜索得到。
两者都是离线完成的:量化后的模型格式和 RTN 一样(整数权重 + 缩放因子 + 可能的零点),推理 kernel 不需要知道用的是哪种方法。
激活量化与离群值
weight-only 量化加速的是读权重,计算仍然在 FP16/BF16 下进行。要用 INT8/FP8 的 Tensor Core 加速计算,激活也必须量化(W8A8)。这里的难点在于激活的离群值:归一化与残差流一章看到,残差流里少数固定的维度数值特别大。
抓取第 12 层 FFN 的输入激活(已经过 RMSNorm),看看它的分布,以及 W8A8 的误差:
from quant import rel_error

captured = {}
hook = model.layers[12].mlp.gate_proj.register_forward_hook(
    lambda mod, inp, out: captured.__setitem__("x", inp[0][0].detach()))
with torch.no_grad():
    model(ids)
hook.remove()
X = captured["x"]                                         # [T, 1024]
W = model.layers[12].mlp.gate_proj.weight.data            # [3072, 1024]
top = X.abs().amax(dim=0).topk(4)
print("最大的几个通道:", [(i, round(v, 1)) for v, i in zip(top.values.tolist(), top.indices.tolist())],
      " 中位数:", round(X.abs().median().item(), 3))

def q8_per_tensor(x):
    s = x.abs().max() / 127
    return (x / s).round().clamp(-128, 127) * s

def q8_per_row(w):
    s = w.abs().amax(dim=1, keepdim=True) / 127
    return (w / s).round().clamp(-128, 127) * s

Y = X @ W.T
err_w8 = rel_error(X @ q8_per_row(W).T, Y)
err_w8a8 = rel_error(q8_per_tensor(X) @ q8_per_row(W).T, Y)

# SmoothQuant:把激活每个通道除以 s_j,权重对应的列乘以 s_j,乘积不变
alpha = 0.5
s = X.abs().amax(dim=0).clamp(min=1e-5) ** alpha / W.abs().amax(dim=0).clamp(min=1e-5) ** (1 - alpha)
Xs, Ws = X / s, W * s
assert torch.allclose(Xs @ Ws.T, Y, atol=1e-3)              # 数学上完全等价
err_smooth = rel_error(q8_per_tensor(Xs) @ q8_per_row(Ws).T, Y)
print(f"只量化权重 {err_w8:.4f};W8A8 {err_w8a8:.4f};SmoothQuant 后 W8A8 {err_smooth:.4f}")
assert err_w8 < err_smooth < err_w8a8
在本手册的环境里:
最大的几个通道: [(277, 21.3), (16, 12.0), (23, 11.6), (3, 11.6)]  中位数: 0.411
只量化权重 0.0065;W8A8 0.0400;SmoothQuant 后 W8A8 0.0130
最大的第 277 维也是前面在残差流里看到的离群维度之一(经过 RMSNorm 之后,各维度又乘上了不同的缩放,排序会变)。激活按张量量化时,量化步长被第 277 维的 21.3 决定,中位数只有 0.4 的普通数值只能用很少的几个量化级别表示,误差是只量化权重时的 6 倍。
SmoothQuant(Xiao 等,2022)利用了一个简单的等价变换:\(XW^\top = (X \operatorname{diag}(s)^{-1})(W\operatorname{diag}(s))^\top\)。把激活的离群通道"除小",权重对应的列"乘大",难度从激活转移了一部分到权重(权重按通道量化,容易承受)。\(\alpha\) 控制转移的程度。这个缩放可以离线合并进前一层 RMSNorm 的权重里,推理时没有额外开销。误差下降到原来的约 1/3。
主流方案小结
| 方案 | 权重 | 激活 | 加速了什么 | 常见用法 |
|---|---|---|---|---|
| W8A16 / W4A16 | INT8 / INT4(GPTQ、AWQ) | BF16 | 读权重(decode) | 小 batch、显存受限的部署 |
| W8A8 INT8 | INT8 | INT8(SmoothQuant 等) | 读权重 + INT8 Tensor Core 计算 | Ampere 等支持 INT8 的 GPU |
| FP8(W8A8) | FP8 | FP8(动态或静态缩放) | 读权重 + FP8 Tensor Core 计算 | Hopper/Ada 上的主流选择,精度损失小 |
| FP4(NVFP4 / MXFP4) | FP4 | FP4 | 同上,更进一步 | Blackwell |
| KV Cache 量化 | — | K、V 用 FP8/INT8 | 读 KV、KV 容量 | 长上下文、高并发 |
推理视角
- decode 看字节,prefill 看算力:weight-only 量化在小 batch 的 decode 中几乎带来与压缩比相当的加速,但大 batch、prefill 时收益递减甚至变慢(反量化有开销,计算仍是 BF16);W8A8/FP8 在两种场景下都有收益;
- 反量化在 kernel 里完成:量化权重在寄存器中被解包、乘以缩放因子,再送进 Tensor Core。Marlin 等 kernel 为此精心设计了权重的离线重排和位运算技巧,参见 CUDA 手册中的量化与 GEMV;
- 一定要评测精度:困惑度只是粗略的信号,实际部署前应在目标任务的评测集上比较,小模型、长上下文、推理(数学)任务往往对量化更敏感。
怎么讲清楚
讲量化先分清"加速了什么":weight-only(W4A16、W8A16)减少读权重的字节,加速访存受限的 decode;W8A8 / FP8 让矩阵乘也用低精度 Tensor Core,加速 prefill 和大 batch。再讲精度:步长由一组数的最大绝对值决定,粒度越细越准,INT4 要按组(通常 128)量化;激活的离群值是难点,SmoothQuant 用等价缩放把难度挪到权重上;GPTQ 用二阶信息补偿误差,AWQ 按激活幅度保护重要的通道。最后强调上线前要在目标任务上评测。
练习
1. 量化步长。 一组权重的最大绝对值是 0.8,用对称 INT4 量化,量化步长是多少?0.05 会被量化成多少?误差是多少?
参考答案
INT4 对称量化的最大整数是 7,步长 s = 0.8 / 7 ≈ 0.1143。0.05 / 0.1143 ≈ 0.44,四舍五入为 0,反量化结果为 0,误差 0.05(100%)。可见在 INT4 下,比最大值小一个数量级的数几乎全部被量化成 0。这就是为什么 INT4 必须缩小共用缩放因子的范围(按组量化)。
2. 估算题。 一个 70B 模型用 W4A16(G = 128,每组一个 FP16 缩放因子和一个 4 位零点)量化,权重一共多少 GB?比 BF16 小多少?
参考答案
每个权重 0.5 字节;每 128 个权重额外 2 + 0.5 = 2.5 字节,平均每个权重约 0.02 字节。合计约 0.52 字节/参数,70B 约 36.4 GB(嵌入层和输出层通常不量化,实际会略大),BF16 为 140 GB,约为其 26%。
小结
- 量化步长由一组数中的最大绝对值决定,离群值会损害所有普通数值的精度。
- 粒度越细误差越小:INT8 按通道几乎无损,INT4 需要按组量化以及 GPTQ/AWQ 等更聪明的方法。
- weight-only 量化加速读权重(decode),W8A8/FP8 同时加速计算。
- 激活离群值是激活量化的主要难点;SmoothQuant 用等价缩放把难度转移到权重上。
- 部署前必须在目标任务上评测量化后的精度。
相关的数学:旋转为什么能消除离群值见线性代数,用 KL 散度衡量量化损失见信息论,GPTQ 的推导与实现见微积分与反向传播,每比特 6 dB 的量化噪声见浮点与数值计算。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题