位置编码与 RoPE
注意力本身不知道 token 的先后顺序。"猫追狗"和"狗追猫"在没有位置信息的注意力眼里是一样的。位置编码把顺序信息注入模型。今天的大模型几乎都用旋转位置编码(RoPE),它的设计直接影响长上下文扩展、KV Cache 的存储方式和推理 kernel 的写法。
自测:能答上来就可以跳过本章
- 为什么注意力需要位置编码?
- RoPE 对 Q、K 做了什么变换?为什么说它编码的是相对位置?
rope_theta(基数)从 10000 调到 1000000 有什么作用?- 为什么同一个模型的 RoPE 有两种写法(相邻两维一组 vs 前后两半一组)?
- KV Cache 里存的 K 是旋转前的还是旋转后的?
自测参考答案(先自己答,再展开对照)
- 注意力对输入顺序是置换等变的:打乱 token 的顺序,输出只是跟着打乱,模型本身分不出先后,所以必须显式地注入位置信息。
- 把 q、k 的每两维看成一个复数,按位置 m 旋转角度 \(m\theta_i\)。旋转后 \(q_m^\top k_n\) 只依赖 \(n - m\),所以编码的是相对位置。
- 频率 \(\theta_i = \text{base}^{-2i/d}\),base 越大,低频维度转得越慢,在更长的距离内不会"转回原点",模型能区分更远的位置,用于长上下文。
- 一种把相邻两维配成一对,另一种把前一半和后一半配对。两者数学上等价,差别只是维度的排列,但必须和权重的维度顺序配套(从某个格式转换权重时,q、k 的投影矩阵会相应重排)。
- 旋转后的:K 在写入缓存前就已经按它自己的位置旋转好了,之后直接和新的 q 做点积。
先看一个六格小剧场,再读正文:
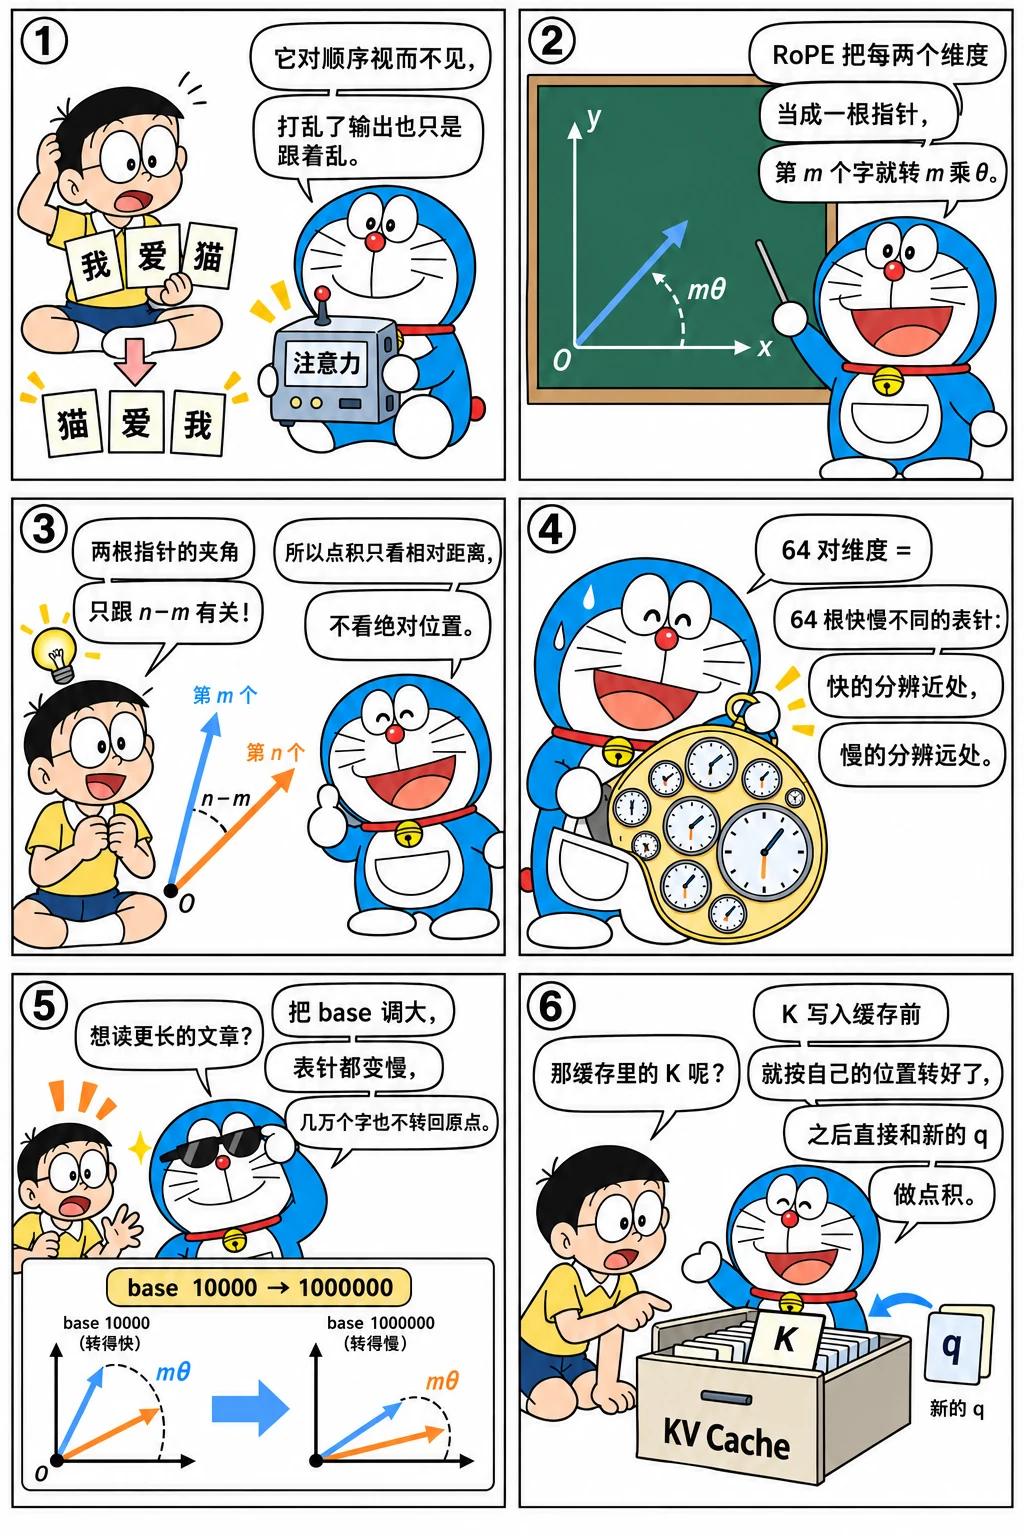
注意力对顺序"视而不见"
不加掩码、不加位置信息时,注意力对输入顺序是置换等变的:把输入的 token 打乱,输出也只是按同样的方式打乱,每个 token 得到的结果完全不变:
import math
import torch

torch.manual_seed(0)
T, d = 6, 16
x = torch.randn(T, d)
Wq, Wk, Wv = (torch.randn(d, d) for _ in range(3))

def attn(x):
    q, k, v = x @ Wq, x @ Wk, x @ Wv
    return (q @ k.T / math.sqrt(d)).softmax(-1) @ v

perm = torch.randperm(T)
assert torch.allclose(attn(x)[perm], attn(x[perm]), atol=1e-5)   # 打乱输入 = 打乱输出
语言显然依赖顺序,所以必须显式地告诉模型每个 token 在哪。(因果掩码本身会带来一点隐式的位置信息,但远远不够。)
早期方案:绝对位置编码
- 正弦位置编码(原始 Transformer):给第 m 个位置一个固定的向量(不同频率的 sin、cos),加到词嵌入上;
- 可学习的绝对位置嵌入(GPT-2、BERT):像词嵌入一样,为每个位置学一个向量。
它们的问题是:模型学到的是"第 5 个位置"这种绝对信息,而语言里更重要的往往是相对距离("前一个词"、"三个词之前");可学习的位置嵌入还无法处理比训练时更长的序列。
RoPE:用旋转编码位置
旋转位置编码(Rotary Position Embedding,苏剑林等,2021)的想法非常优雅:不把位置加到向量上,而是按位置把 q 和 k 旋转一个角度。
先看二维的情况。把位置 m 的 query 向量旋转 \(m\theta\) 角度,位置 n 的 key 向量旋转 \(n\theta\) 角度:
旋转矩阵满足 \(R(a)^\top R(b) = R(b - a)\),所以它们的点积:
只依赖相对位置 \(n - m\),与绝对位置无关。而且它是乘性的,不会像加法那样把位置信息和内容信息混在一起。
对 \(d_h\) 维的向量,把它分成 \(d_h/2\) 组,每组两维独立旋转,第 i 组使用不同的频率:
前面的组转得快(高频,对近距离敏感),后面的组转得慢(低频,能区分很远的距离)。base 就是配置文件里的 rope_theta。
实现
实践中有两种等价的分组方式:
- 相邻两维一组:(0, 1)、(2, 3)……,可以把每组看成一个复数,旋转就是乘以 \(e^{i m\theta}\)。Meta 发布的原始 LLaMA 代码是这样写的;
- 前后两半一组:第 i 维和第 i + d_h/2 维一组,用
rotate_half实现。Hugging Face transformers、Qwen 等采用这种写法。
"""rope.py —— 旋转位置编码的两种等价实现。"""

import torch


def inv_freq(head_dim: int, base: float = 10000.0) -> torch.Tensor:
    return 1.0 / (base ** (torch.arange(0, head_dim, 2, dtype=torch.float32) / head_dim))   # [d/2]


def rope_half(x: torch.Tensor, pos: torch.Tensor, base: float = 10000.0) -> torch.Tensor:
    """"前后两半一组"(transformers 的写法)。x: [..., T, d],pos: [T]"""
    freqs = pos.float()[:, None] * inv_freq(x.shape[-1], base)[None, :]   # [T, d/2]
    cos, sin = torch.cat([freqs, freqs], -1).cos(), torch.cat([freqs, freqs], -1).sin()
    x1, x2 = x.chunk(2, dim=-1)
    rotated = torch.cat([-x2, x1], dim=-1)                                 # rotate_half
    return x * cos + rotated * sin


def rope_complex(x: torch.Tensor, pos: torch.Tensor, base: float = 10000.0) -> torch.Tensor:
    """"相邻两维一组"(原始 LLaMA 的写法):把 (x0, x1) 看成复数 x0 + i·x1,乘以 e^{i·m·θ}。"""
    freqs = pos.float()[:, None] * inv_freq(x.shape[-1], base)[None, :]
    rot = torch.polar(torch.ones_like(freqs), freqs)                       # e^{i m θ}
    xc = torch.view_as_complex(x.float().reshape(*x.shape[:-1], -1, 2))
    return torch.view_as_real(xc * rot).flatten(-2)
验证 RoPE 的关键性质:
from rope import rope_complex, rope_half

torch.manual_seed(0)
d = 64
q, k = torch.randn(d), torch.randn(d)

def score(m, n, rope):
    qm = rope(q[None, :], torch.tensor([m]))[0]
    kn = rope(k[None, :], torch.tensor([n]))[0]
    return (qm @ kn).item()

# 1) 点积只取决于相对位置:(5, 3)、(105, 103)、(1005, 1003) 的结果相同
for rope in (rope_half, rope_complex):
    s = [score(m, m - 2, rope) for m in (5, 105, 1005)]
    assert max(s) - min(s) < 1e-3, s

# 2) 旋转不改变向量长度
x = torch.randn(10, d)
assert torch.allclose(rope_half(x, torch.arange(10)).norm(dim=-1), x.norm(dim=-1), atol=1e-4)

# 3) 两种写法等价:只是维度的排列顺序不同
perm = torch.cat([torch.arange(0, d, 2), torch.arange(1, d, 2)])   # 相邻排列 -> 前后两半排列
x = torch.randn(7, d)
pos = torch.arange(7)
assert torch.allclose(rope_complex(x, pos)[:, perm], rope_half(x[:, perm], pos), atol=1e-5)
第 3 条说明:两种写法的区别只是 q、k 维度的排列。这有一个实际后果:把 Meta 格式的 LLaMA 权重转换成 Hugging Face 格式时,转换脚本会对 q_proj、k_proj 的输出维度做一次重排。权重和 RoPE 的写法必须配套,否则模型能跑但输出全是乱码。
频率与"波长"
第 i 组维度转一整圈需要的位置数(波长)是 \(2\pi / \theta_i\):
>>> import math
>>> from rope import inv_freq
>>> for base in (10_000, 1_000_000):
...     f = inv_freq(64, base)
...     print(base, [round(2 * math.pi / f[i].item()) for i in (0, 8, 16, 24, 31)])
...
10000 [6, 63, 628, 6283, 47117]
1000000 [6, 199, 6283, 198692, 4080185]
最快的一组每 6 个 token 转一圈,最慢的一组要几万甚至几百万个 token。把 base 从 10000 增大到 1000000(Qwen2.5 的取值,LLaMA-3 用 500000),低频部分的波长被拉得更长,模型在很长的距离上仍能区分位置,这是支持长上下文的基础之一。
把一对维度随位置的变化画成三维的螺旋,就能同时看到"转得多快"(波长)和"q、k 的夹角只取决于 m − n"这两件事。拖动旋转,把 i 从 0 拉到 63,看螺旋怎么从弹簧变成直线:
长上下文扩展
模型在 4K 长度上训练,推理时要用 32K 甚至 128K,超出训练范围的位置(旋转角度)模型没见过,效果会急剧下降。几种常见的扩展方法:
| 方法 | 做法 | 说明 |
|---|---|---|
| 位置插值(PI) | 把位置 m 缩放成 m / s,所有位置都"压"回训练范围 | 简单,但高频部分被压缩后近距离分辨率下降,通常需要少量微调 |
| NTK-aware 缩放 | 增大 base,主要拉长低频部分的波长,高频部分基本不变 | 不微调也有一定效果 |
| YaRN | 按频率分段处理:高频不插值、低频插值、中间过渡,并对注意力分数做温度修正 | Qwen2.5 用它把上下文扩展到 128K,配置里写作 rope_scaling: {"type": "yarn", "factor": 4.0, ...} |
| LLaMA-3.1 的方式 | 类似 YaRN 的按频率分段缩放 | 配置里的 rope_type: "llama3" |
这些方法都只修改 cos/sin 表的计算方式(以及可能的注意力缩放),模型结构不变。推理引擎必须按配置实现同样的 RoPE 变体,否则长文本效果会明显变差。
另一种思路是ALiBi:不旋转向量,而是直接给注意力分数加上一个与距离成正比的负偏置,远的 token 被"惩罚"。BLOOM、MPT 等模型用过它,现在主流模型多用 RoPE。
推理视角
- KV Cache 里存的是旋转之后的 K:每个 token 的 K 在写入缓存时就按它的位置旋转好了,之后不再改变。decode 时只需要对新 token 的 q、k 做旋转;
- 因为 K 已经按绝对位置旋转过,同一段文本只有出现在相同的位置时,缓存才能复用。前缀缓存天然满足这一点(共享的都是从位置 0 开始的前缀);而丢弃中间 token 或者把缓存"平移"到别的位置时,就要重新处理位置;
- RoPE 的计算量很小但访存不少,推理引擎通常把它和 QKV 投影之后的操作融合成一个 kernel(有时连同写 KV Cache 一起),而不是单独启动;
- DeepSeek 的 MLA 为了能压缩 KV Cache,把 RoPE 单独拆出一小部分维度,见注意力变体。
怎么讲清楚
讲 RoPE:按位置旋转 q、k 的每两维,点积只依赖相对位置;不同维度组的频率不同,base(rope_theta)越大低频转得越慢,用于长上下文;两种写法(相邻两维一组、前后两半一组)数学上等价,但必须和权重的维度排列配套——接入新模型时常见的 bug;KV Cache 里存的是旋转后的 K,所以缓存复用要求位置一致;PI、NTK、YaRN 等长上下文扩展只改 cos / sin 的计算,推理时 RoPE 常和相邻的操作融合。
练习
1. 手算旋转。 二维向量 q = (1, 0),θ = π/2,位置 m = 1。RoPE 之后 q 变成什么?k = (1, 0) 在位置 n = 3 呢?它们的点积是多少,和 \(q^\top R((n-m)\theta)k\) 一致吗?
参考答案
q' = R(π/2)(1, 0) = (0, 1);k' = R(3π/2)(1, 0) = (0, −1);点积 = −1。 直接计算:\(R(2 \cdot \pi/2) = R(\pi)\),\(q^\top R(\pi) k = (1, 0) \cdot (−1, 0) = −1\),一致。
2. 思考题。 如果推理引擎在 prefill 时 RoPE 用了一种写法,decode 时用了另一种写法,会发生什么?
参考答案
缓存中的 K 按一种维度分组方式旋转,新 token 的 q 按另一种方式旋转,两者的相对位置关系被破坏,注意力分数变成错误的值。表现通常是:前几个 token 正常(它们来自 prefill 的最后一个位置),之后很快开始输出重复或无意义的内容。这类 bug 很隐蔽,推理引擎的测试一般会对比"带缓存逐步生成"和"不带缓存整段计算"的 logits 是否一致,KV Cache 一章会用这种方法验证我们的实现。
小结
- 注意力对顺序置换等变,必须显式注入位置信息。
- RoPE 按位置旋转 q、k,点积只依赖相对位置;不同维度组使用不同频率,base 越大低频越慢。
- 两种实现(相邻一组 / 前后两半一组)等价,但必须和权重的维度排列配套。
- 长上下文扩展(PI、NTK、YaRN)只改 cos/sin 的计算,推理引擎要按配置实现。
- KV Cache 存旋转后的 K,缓存复用要求位置一致;RoPE 常与其他操作融合成一个 kernel。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题