剪枝、2:4 稀疏与蒸馏
量化一章讲了"用更少的比特表示每个权重"。另外两条压缩模型的路是:剪枝——把一部分权重直接去掉;蒸馏——让一个小模型学大模型的输出。这一章用两个小实验说明剪枝时"剪哪些"比"剪多少"更重要(按权重大小剪 vs 同时考虑输入激活的 Wanda),2:4 半结构化稀疏在硬件上省下了什么;再看蒸馏为什么能让小模型在很少的标注数据上接近大模型,以及它和推理模型的关系。
自测:能答上来就可以跳过本章
- 非结构化、半结构化(2:4)、结构化剪枝有什么区别?哪一种能在 GPU 上直接加速?
- 为什么大模型剪枝不能只看权重的大小?Wanda 的剪枝标准是什么?
- 2:4 稀疏在存储和计算上各省多少?
- 知识蒸馏的"软标签"比硬标签多了什么信息?温度起什么作用?
- DeepSeek-R1 的"蒸馏版"小模型是怎么训练出来的?
自测参考答案(先自己答,再展开对照)
- 非结构化:任意位置的权重置零;2:4 半结构化:每 4 个里留 2 个;结构化:整行、整个头、整层地删。结构化剪枝得到更小的稠密矩阵,2:4 有稀疏 Tensor Core 支持,这两者能在 GPU 上直接加速;非结构化很难。
- 输入激活的尺度差别很大,一个小权重乘上一个大激活,贡献可能比大权重还大。Wanda 用"权重的绝对值 × 对应输入通道激活的 L2 范数"作为重要性,按输出行比较。
- 存储:一半的数值加上每个数 2 比特的位置元数据,约为稠密的 56%;计算:稀疏 Tensor Core 的峰值算力是稠密的 2 倍。
- 软标签里有"这个样本像哪些类、像到什么程度"的信息,比 one-hot 丰富得多;温度越高分布越平,这些次要信息越明显,损失通常乘以 \(T^2\) 保持梯度的量级。
- 序列级蒸馏:用 DeepSeek-R1 生成大量带长推理过程的回答,拿它们对 Qwen、Llama 的基座模型做 SFT,小模型就学会了长链推理,没有再做 RL。
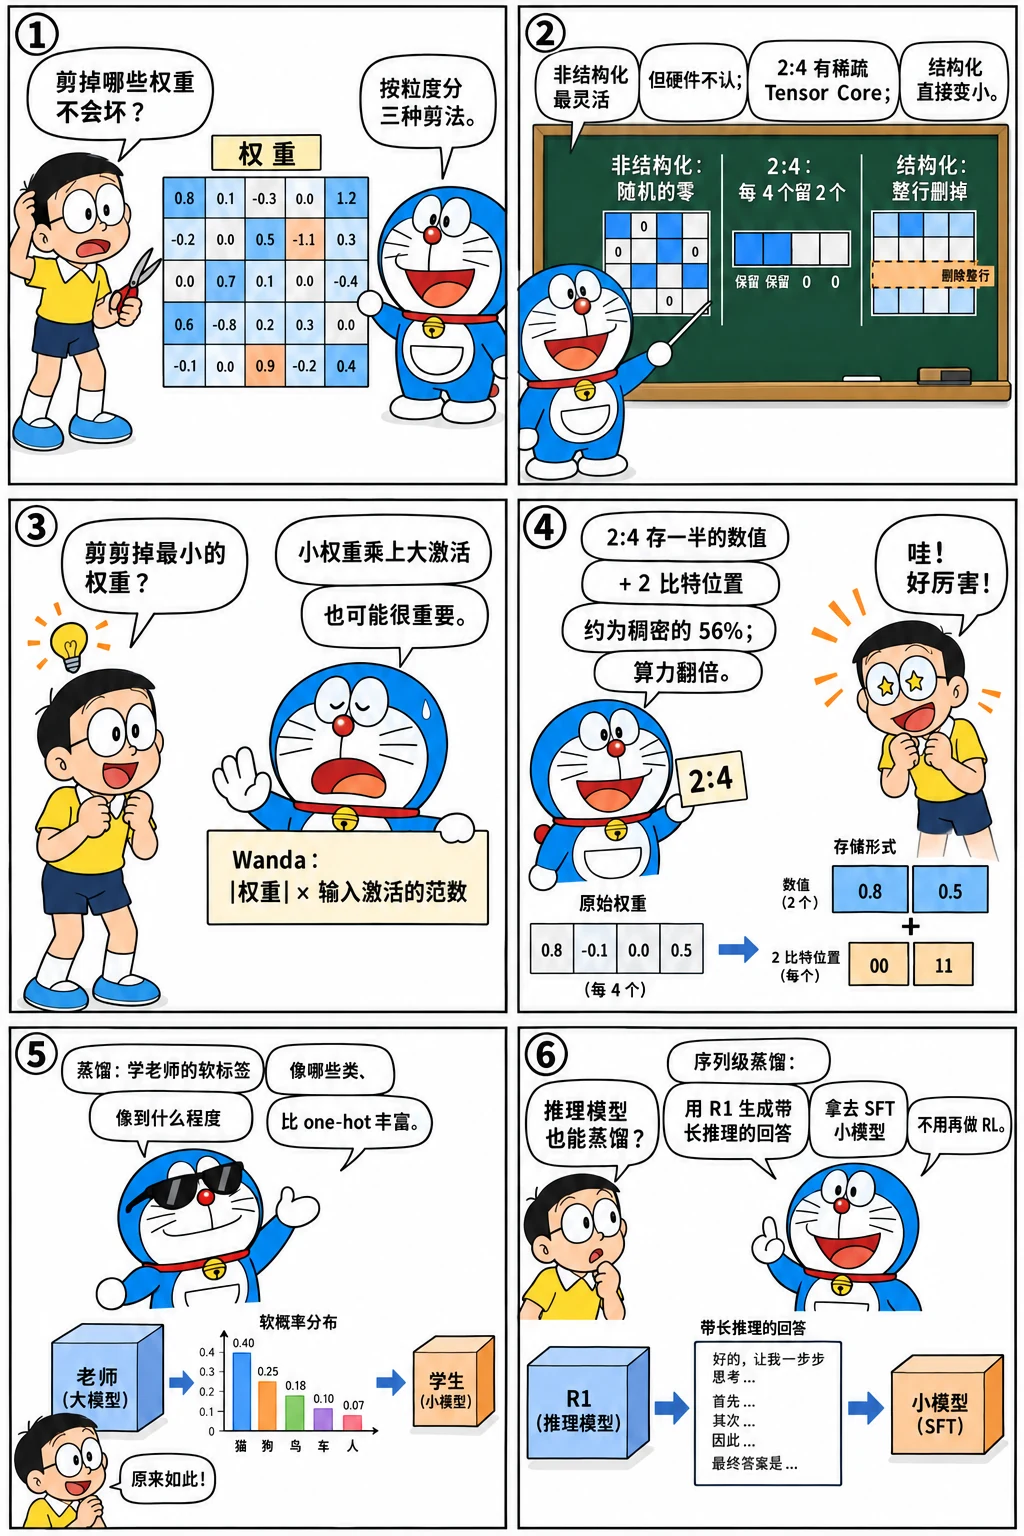
先看一个六格小剧场,再读正文:
剪哪些权重
剪枝按粒度分三类:
- 非结构化:任意位置的权重都可以置零。精度损失最小,但稀疏的位置不规则,普通的 GPU kernel 无法加速(除非稀疏度极高);
- 半结构化(2:4):每 4 个连续的权重里恰好保留 2 个。NVIDIA 从 Ampere 开始的稀疏 Tensor Core 原生支持这种格式;
- 结构化:整行、整列、整个注意力头、甚至整层地去掉。模型直接变小,任何硬件都能加速,但精度损失最大,通常要配合再训练或蒸馏。
剪哪些权重?最直接的想法是剪掉绝对值最小的。但大模型的激活里有少数离群通道(值比其他通道大几十倍,见量化一章),与这些通道相乘的权重即使很小,对输出的贡献也很大。Wanda(Pruning by Weights and activations)用 \(|W_{ij}| \cdot \|X_j\|\) 作为重要性:权重大小乘以对应输入通道的激活范数(用少量校准数据统计),不需要任何再训练。在一个有离群输入通道的线性层上比较:
import torch

torch.manual_seed(0)
N, D_IN, D_OUT = 512, 1024, 1024
X = torch.randn(N, D_IN)
X[:, torch.randperm(D_IN)[:16]] *= 20                  # 少数输入通道的激活特别大(LLM 里常见的离群通道)
W = torch.randn(D_IN, D_OUT) / D_IN**0.5
ref = X @ W


def prune(score, pattern):
    keep = torch.zeros_like(W, dtype=torch.bool)
    if pattern == "非结构化 50%":
        keep.view(-1)[score.flatten().topk(W.numel() // 2).indices] = True
    else:                                                  # 2:4:沿输入维每 4 个连续权重保留分数最高的 2 个
        g = score.T.reshape(D_OUT, -1, 4)
        top = g.topk(2, dim=-1).indices
        keep = torch.zeros_like(g, dtype=torch.bool).scatter_(-1, top, True).reshape(D_OUT, D_IN).T
    return W * keep


for pattern in ("非结构化 50%", "2:4 半结构化"):
    for name, score in (("按权重大小", W.abs()), ("Wanda(权重 × 输入激活范数)", W.abs() * X.norm(dim=0)[:, None])):
        err = ((X @ prune(score, pattern) - ref).norm() / ref.norm()).item()
        print(f"{pattern},{name}:输出相对误差 {err:.3f}")
bits = 0.5 * 16 + 0.5 * 2                                  # 2:4:只存一半的值(bf16)+ 每个值 2 比特的位置信息
print(f"2:4 的存储:每个权重平均 {bits:.0f} 比特(稠密 bf16 是 16 比特),decode 读权重减少到 {bits / 16:.0%};稀疏 Tensor Core 算力翻倍")
非结构化 50%,按权重大小:输出相对误差 0.266
非结构化 50%,Wanda(权重 × 输入激活范数):输出相对误差 0.101
2:4 半结构化,按权重大小:输出相对误差 0.361
2:4 半结构化,Wanda(权重 × 输入激活范数):输出相对误差 0.138
2:4 的存储:每个权重平均 9 比特(稠密 bf16 是 16 比特),decode 读权重减少到 56%;稀疏 Tensor Core 算力翻倍
- 同样剪掉一半,考虑激活的 Wanda 把输出误差降到按大小剪的四成左右——剪哪些比剪多少更重要;
- 2:4 的约束(每 4 个里必须留 2 个,不能随意挑)比非结构化多损失一些精度;
- SparseGPT 更进一步:剪掉一些权重后,用二阶信息(和 GPTQ 相同的思路)调整剩下的权重来补偿误差,精度更好但计算更贵。
2:4 在硬件上省什么。 存储:只存一半的值,外加每个值 2 比特的位置信息,约为稠密的 56%——decode 读权重的时间相应减少;计算:稀疏 Tensor Core 跳过为零的一半,矩阵乘的峰值算力翻倍。代价是精度:50% 的稀疏度对大模型是不小的损伤,通常需要一段再训练才能恢复,而同样省一半带宽的 INT8 / FP8 量化几乎无损。这就是为什么推理服务里量化远比剪枝常见——剪枝更多作为"结构化剪枝 + 蒸馏"的一部分,用来做出一个更小的模型。
蒸馏:让小模型学大模型的输出
知识蒸馏让学生模型去拟合老师模型的输出分布,而不只是真实标签。老师的软标签(带温度 \(T\) 的 softmax)里包含"这个样本和哪些类相似"的信息:一张猫的图片,老师给"狗"的概率比给"汽车"高得多,这比一个 one-hot 的"猫"丰富得多。温度越高,分布越平,这些次要的信息越明显;损失通常是软标签上的 KL 散度(乘以 \(T^2\) 保持梯度的量级)加上硬标签的交叉熵。
更实用的一点:老师可以给无标签的数据打软标签。下面的实验里,学生只有 300 个带标签的样本,另有 5000 个无标签样本由老师打软标签:
import torch
import torch.nn.functional as F

torch.manual_seed(0)
torch.set_num_threads(4)
C, D = 10, 32
centers = torch.randn(C, 4, D) * 2                         # 每个类由 4 个簇组成:决策边界比较复杂


def sample(n, g):
    y = torch.randint(0, C, (n,), generator=g)
    k = torch.randint(0, 4, (n,), generator=g)
    return centers[y, k] + torch.randn(n, D, generator=g) * 1.5, y


g = torch.Generator().manual_seed(1)
x_big, y_big = sample(8000, g)                             # 老师用大量数据训练
x_small, y_small = sample(300, g)                          # 学生只有 300 个带标签的样本
x_test, y_test = sample(5000, g)
x_unlab, _ = sample(5000, g)                               # 另有 5000 个无标签样本,可以让老师打软标签


def mlp(h):
    return torch.nn.Sequential(torch.nn.Linear(D, h), torch.nn.ReLU(), torch.nn.Linear(h, h), torch.nn.ReLU(), torch.nn.Linear(h, C))


def fit(model, x, loss_fn, steps=1500):
    opt = torch.optim.Adam(model.parameters(), lr=3e-3)
    for _ in range(steps):
        opt.zero_grad()
        loss_fn(model(x)).backward()
        opt.step()
    return model


def acc(model):
    with torch.no_grad():
        return (model(x_test).argmax(-1) == y_test).float().mean().item()


teacher = fit(mlp(128), x_big, lambda out: F.cross_entropy(out, y_big), steps=800)
torch.manual_seed(2)
hard = fit(mlp(32), x_small, lambda out: F.cross_entropy(out, y_small))
T = 4.0
x_kd = torch.cat([x_small, x_unlab])
with torch.no_grad():
    soft = F.softmax(teacher(x_kd) / T, -1)                # 老师的软标签:包含"像哪几个类"的信息
torch.manual_seed(2)
kd = fit(mlp(32), x_kd, lambda out: F.kl_div(F.log_softmax(out / T, -1), soft, reduction="batchmean") * T * T
         + F.cross_entropy(out[:len(x_small)], y_small))
print(f"老师(128 宽,8000 个样本):测试准确率 {acc(teacher):.1%}")
print(f"学生(32 宽)只用 300 个硬标签:{acc(hard):.1%}")
print(f"学生(32 宽)+ 蒸馏(老师在 5300 个样本上的软标签,温度 {T:.0f}):{acc(kd):.1%}")
老师(128 宽,8000 个样本):测试准确率 99.8%
学生(32 宽)只用 300 个硬标签:89.9%
学生(32 宽)+ 蒸馏(老师在 5300 个样本上的软标签,温度 4):99.6%
同一个小网络,只用少量标签时准确率不到 90%;蒸馏之后几乎追平老师。收益的一部分来自软标签本身,另一部分来自老师把大量无标签数据变成了训练信号——在大模型的场景里,后者往往更重要。
在大模型中的几种用法:
- logit 蒸馏:学生在同样的输入上拟合老师每个位置的输出分布(需要两者词表一致),常用于预训练阶段的小模型;
- 序列级蒸馏:用老师生成的文本做监督微调(SFT)。DeepSeek-R1 的"蒸馏版"小模型就是这样得到的:用 R1 生成的大量推理轨迹去微调 Qwen、Llama 的基座模型,小模型因此学会了长链推理;
- 剪枝 + 蒸馏:先对大模型做结构化剪枝(去掉部分层、头、FFN 通道),再用原模型当老师蒸馏恢复精度,用远少于从头训练的算力得到一个更小的模型(NVIDIA 的 Minitron 系列);
- 在线(on-policy)蒸馏:学生自己生成文本,老师对学生生成的每个位置给出分布,学生去拟合——解决了"学生只见过老师的文本、没见过自己犯的错"的问题。
对推理系统来说,蒸馏的意义是:同样的质量,用更小的模型服务,成本和延迟成比例下降;投机解码的草稿模型、EAGLE 这类草稿头,本质上也是一种对目标模型的蒸馏。
推理视角
三种压缩手段的取舍:量化几乎无损、不需要训练、各种硬件都支持,是推理服务的首选;2:4 稀疏在支持的硬件上存储和算力都有收益,但精度损失明显、需要再训练;蒸馏得到的是一个新的、更小的模型,收益最大但成本也最高(需要训练和评测)。实际中常常组合使用:蒸馏出小模型,再量化部署。
怎么讲清楚
比较三种压缩手段:量化几乎无损、不需要训练、硬件普遍支持,是推理服务的首选;2:4 稀疏在稀疏 Tensor Core 上存储约为稠密的 56%、算力翻倍,但精度损失明显、要再训练;非结构化剪枝在 GPU 上很难加速。剪哪些比剪多少重要(Wanda 用"权重 × 输入激活范数")。蒸馏得到一个新的小模型,收益最大、成本也最高:DeepSeek-R1 的蒸馏版是用老师生成的推理轨迹做 SFT。实际常常组合:先蒸馏出小模型,再量化部署。
练习
1. 为什么非结构化剪枝在 GPU 上很难加速?
参考答案
GPU 的矩阵乘依赖规整的、连续的数据访问和 Tensor Core 的固定形状。非结构化稀疏的零分布在任意位置,要跳过它们就得存每个非零值的位置(CSR 等格式),访存变得不规则,Tensor Core 也用不上;稀疏度不到 90% 以上时,额外的索引开销往往比省下的计算还多。2:4 通过限定"每 4 个里留 2 个",让硬件可以用固定的 2 比特元数据和专门的数据通路来处理。
2. 蒸馏时温度 \(T\) 设得太高或太低会怎样?
参考答案
太低(接近 1)时软标签接近 one-hot,次要类别的概率几乎为零,学生学不到"哪些类相似"的信息,退化成用老师的预测当硬标签。太高时分布趋于均匀,有用的信息被噪声淹没,而且学生为了拟合高温下的平坦分布,可能牺牲在正确类别上的置信度。常用的范围是 2~8,还要配合硬标签的损失。
小结
- 剪枝分非结构化、2:4 半结构化、结构化;只有后两者能在 GPU 上直接加速,2:4 由稀疏 Tensor Core 支持。
- 剪哪些比剪多少更重要:Wanda 用"权重 × 输入激活范数",在有离群通道时误差约为按大小剪的四成;SparseGPT 再用二阶信息补偿。
- 2:4 的存储约为稠密的 56%、算力翻倍,但精度损失明显,推理服务更常用量化;剪枝多与蒸馏结合,用来做出更小的模型。
- 蒸馏让学生拟合老师的软标签,还能利用无标签数据;大模型里有 logit 蒸馏、序列级蒸馏(R1 蒸馏版)、剪枝 + 蒸馏、在线蒸馏等用法。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题