RL 算法进阶:从 PPO 到 GRPO、DAPO、GSPO
推理模型的后训练几乎都是"可验证奖励的强化学习":采样一组回答、按对错打分、提高答对的概率。2024 年的 GRPO 之后,一年里出现了一串改进:DAPO、Dr. GRPO、GSPO、CISPO……它们改的往往只是损失函数里的一两处——优势怎么算、损失怎么在 token 之间平均、重要性比按 token 还是按序列、裁剪什么。这些细节直接决定训练会不会崩、熵会不会坍缩,也决定了推理引擎要为训练提供什么(比如采样时的 logprobs)。这一章用数值实验把每一处改动的效果算出来。
自测:能答上来就可以跳过本章
- GRPO 的优势是怎么算的?一组回答全对或全错时会怎样?
- "先在每个回答内部平均,再对回答平均"和"所有 token 一起平均"有什么区别?DAPO 为什么改成后者?
- KL 散度的 k1、k2、k3 三种估计量各有什么性质?GRPO 用的是哪一个?
- GSPO 为什么要用序列级的重要性比?为什么是几何平均而不是乘积?
- 训练端和推理端的概率不一致时,TIS 和 MIS 各怎么修正?代价是什么?
自测参考答案(先自己答,再展开对照)
- 同一个问题采样一组回答,优势 =(奖励 − 组内平均)÷ 组内标准差,不需要 critic。全对或全错时组内奖励都一样,优势全是 0,这组没有任何学习信号(DAPO 用动态采样过滤掉这样的组)。
- 先按回答平均时,长回答里每个 token 的权重被稀释,对错误的长回答惩罚不足,助长冗长的错误输出;所有 token 一起平均让每个 token 的权重相同。DAPO 改成后者正是为了这一点。
- k1 \(= -\log r\):无偏但方差大,近一半样本为负;k2 \(= \frac{1}{2}(\log r)^2\):非负、方差小,但有偏;k3 \(= (r-1) - \log r\):无偏、非负、方差也小。GRPO 用的是 k3。
- 逐 token 的比率噪声大,裁剪时会丢掉很多 token 的梯度;奖励本来就是给整条序列的,用序列级的比率更一致。但 token 比率的乘积随长度指数级地发散,所以取几何平均(对数比的平均再取指数),让它和长度无关,并在序列级做裁剪。
- TIS 把训练端 / 推理端的概率比截断到一个上限再乘到损失上(有偏,但方差受控);MIS 直接丢掉比率异常的 token 或序列。代价:截断引入偏差,丢弃浪费样本;而且都需要推理引擎返回采样时的 logprobs。
先看一个六格小剧场,再读正文:
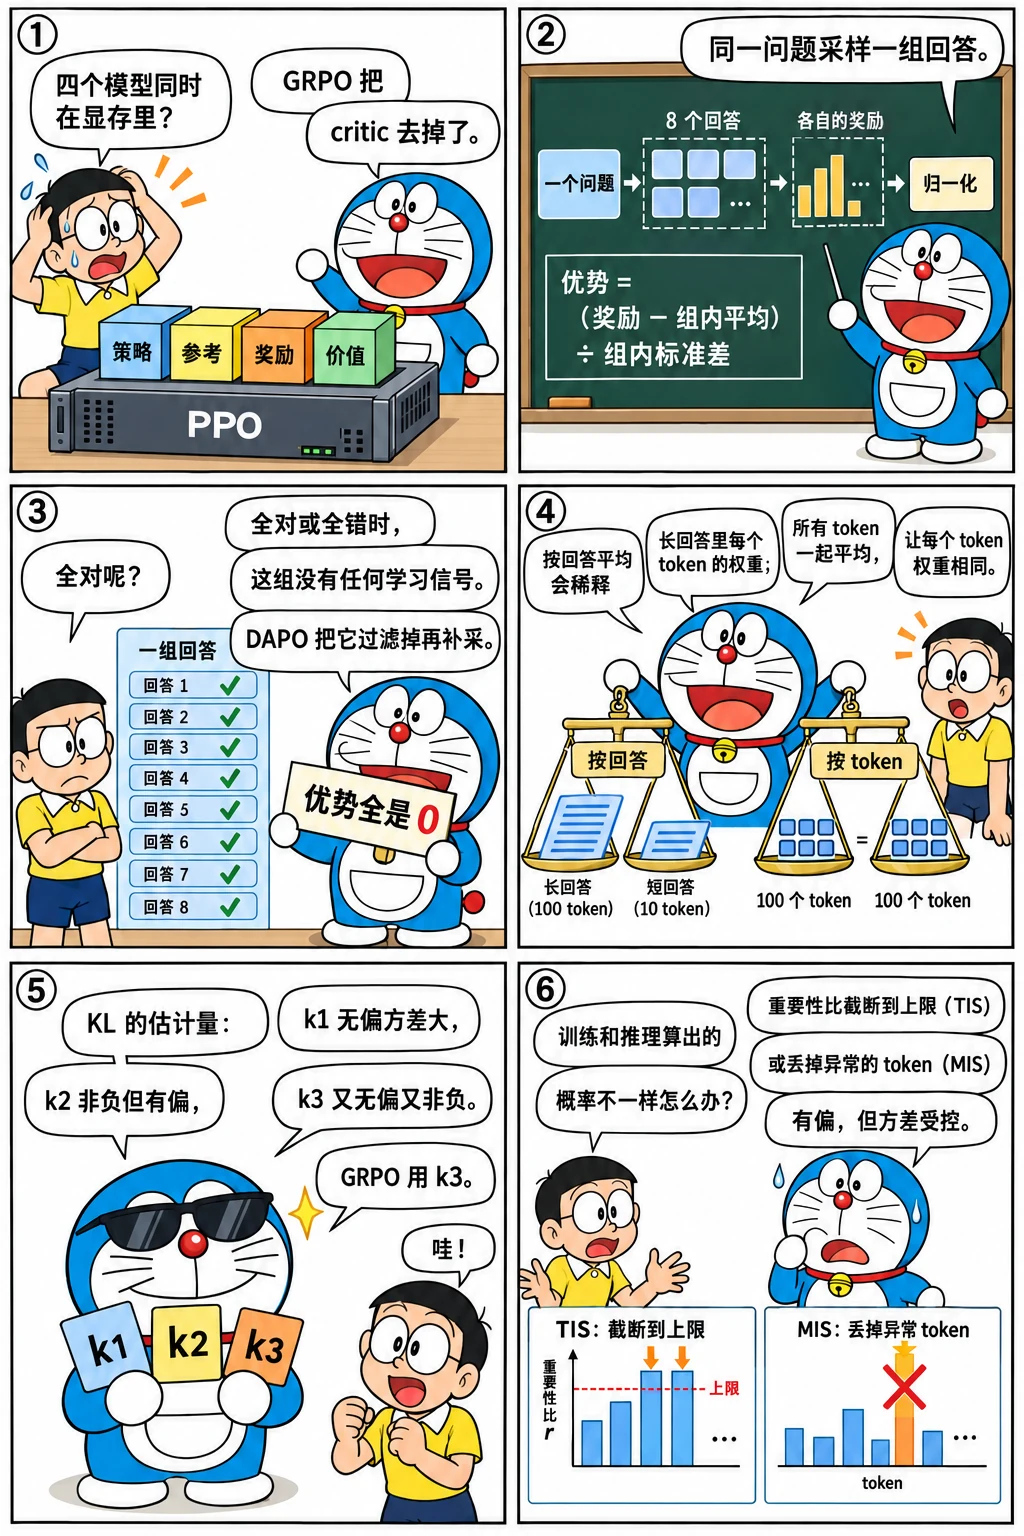
从 PPO 到 GRPO
PPO 的目标是:用旧策略 \(\pi_{\text{old}}\) 采样,对每个 token 计算重要性比 \(r_t = \pi_\theta(o_t) / \pi_{\text{old}}(o_t)\),最大化
优势 \(A_t\) 由一个和策略一样大的价值模型(critic)估计。GRPO(DeepSeekMath)去掉了 critic:同一个问题采样 \(G\) 个回答,用组内的均值(和标准差)做基线,\(A_i = (R_i - \mathrm{mean}(R)) / \mathrm{std}(R)\),同一个回答的所有 token 共享这个优势;再在损失里加一项对参考模型的 KL 惩罚。省掉 critic 省下了一半的显存和计算,代价是每个问题要采好几条。
各个改进版本改动的地方:
| 算法 | 改了什么 | 动机 |
|---|---|---|
| Dr. GRPO | 去掉按回答长度的归一化和按标准差的归一化 | 两者分别引入"长度偏差"和"题目难度偏差" |
| DAPO | 裁剪上界放宽到 \(1 + 0.28\)(Clip-Higher);过滤全对 / 全错的组并补采(动态采样);所有 token 一起平均;超长回答逐渐加罚;去掉 KL | 防止熵坍缩、每个 batch 都有有效信号、长回答的每个 token 与短回答同等对待 |
| GSPO | 重要性比和裁剪都改在序列级,比率取逐 token 比率的几何平均 | 逐 token 的比率噪声大,MoE 模型尤其明显,训练不稳 |
| CISPO | 不裁剪目标函数,而是裁剪重要性权重本身(权重不回传梯度) | 被裁剪的 token 仍然贡献梯度,不会被整个丢掉 |
优势与损失的平均方式
同一组回答,看每个 token 在损失里的权重:
改一改奖励和长度,看每个 token 的权重怎么变:
import torch

# 一个 prompt 采样 4 个回答(GRPO 的组),奖励 1 表示答对
rewards = torch.tensor([1.0, 0.0, 0.0, 1.0])
lengths = torch.tensor([200, 50, 2000, 400])                  # 回答长度差别很大

adv = rewards - rewards.mean()
adv_std = adv / (rewards.std() + 1e-6)
print("组内优势(减均值):", adv.tolist(), " 再除以标准差:", [round(a, 2) for a in adv_std.tolist()])

# 每个 token 的梯度权重 = 优势 × 这个 token 在损失里的系数
seq_mean = adv_std / lengths / len(lengths)                   # GRPO:先在每个回答内部求平均,再对回答求平均
tok_mean = adv_std / lengths.sum()                            # DAPO:所有 token 放在一起求平均
print("回答   奖励  长度   每个 token 的权重(序列平均)  (token 平均)  整条回答的总权重(序列平均)  (token 平均)")
for i in range(4):
    print(f"{i:4d} {rewards[i]:5.0f} {lengths[i]:5d}   {seq_mean[i]:+26.2e}  {tok_mean[i]:+13.2e}"
          f"  {seq_mean[i] * lengths[i]:+27.3f}  {tok_mean[i] * lengths[i]:+13.3f}")

# 全对或全错的组:优势全是 0,这一组对梯度没有任何贡献
for group in ([1.0, 1.0, 1.0, 1.0], [0.0, 0.0, 0.0, 0.0]):
    g = torch.tensor(group)
    print(f"奖励 {group}:优势 {(g - g.mean()).tolist()}")
组内优势(减均值): [0.5, -0.5, -0.5, 0.5]  再除以标准差: [0.87, -0.87, -0.87, 0.87]
回答   奖励  长度   每个 token 的权重(序列平均)  (token 平均)  整条回答的总权重(序列平均)  (token 平均)
   0     1   200                    +1.08e-03      +3.27e-04                       +0.217         +0.065
   1     0    50                    -4.33e-03      -3.27e-04                       -0.217         -0.016
   2     0  2000                    -1.08e-04      -3.27e-04                       -0.217         -0.654
   3     1   400                    +5.41e-04      +3.27e-04                       +0.217         +0.131
奖励 [1.0, 1.0, 1.0, 1.0]:优势 [0.0, 0.0, 0.0, 0.0]
奖励 [0.0, 0.0, 0.0, 0.0]:优势 [0.0, 0.0, 0.0, 0.0]
- 全对或全错的组优势全为 0,对梯度毫无贡献,却照样花了采样和前向的算力。训练后期大多数题要么总是对、要么总是错,这样的组越来越多,有效 batch 越来越小。DAPO 的动态采样把它们过滤掉,继续采样直到凑满一个 batch;
- 序列平均(原始 GRPO)让每个回答的总权重相同:2000 个 token 的错误回答,每个 token 只分到 50 个 token 的错误回答的 1/40。模型因此对"又长又错"的回答惩罚得很轻,容易越写越长。token 平均(DAPO)让所有 token 同等对待,长的错误回答受到的总惩罚更大;
- 除以组内标准差会放大"几乎全对 / 几乎全错"的组的优势(标准差很小),Dr. GRPO 认为这给不同难度的题目引入了偏差,建议只减均值。
KL 惩罚:三种估计量
GRPO 在每个 token 上估计当前策略 \(q\) 相对参考模型 \(p\) 的 KL。只有采样到的 token 能用,所以要用"单样本估计量"。令 \(r = p(x) / q(x)\),\(x \sim q\):
三条曲线画出来:
import torch

torch.manual_seed(0)
V = 1000
p_ref = torch.randn(V).softmax(-1)                            # 参考模型在某个位置的分布
q = (p_ref.log() + 0.3 * torch.randn(V)).softmax(-1)          # 当前策略:离参考模型不远
exact = (q * (q / p_ref).log()).sum()                         # KL(q ‖ p_ref) 的精确值

x = torch.multinomial(q, 100_000, replacement=True)           # 从当前策略采样的 token(rollout)
r = p_ref[x] / q[x]
estimators = {"k1 = -log r": -r.log(), "k2 = (log r)² / 2": r.log() ** 2 / 2, "k3 = (r - 1) - log r": (r - 1) - r.log()}
print(f"精确的 KL:{exact:.4f}")
for name, v in estimators.items():
    print(f"{name:22s} 均值 {v.mean():.4f},标准差 {v.std():.4f},负值的比例 {(v < 0).float().mean():.0%}")
精确的 KL:0.0502
k1 = -log r            均值 0.0497,标准差 0.3221,负值的比例 44%
k2 = (log r)² / 2      均值 0.0531,标准差 0.0744,负值的比例 0%
k3 = (r - 1) - log r   均值 0.0505,标准差 0.0697,负值的比例 0%
- k1 \(= -\log r\) 是无偏的,但方差大,而且近一半的样本是负数——作为损失项,它会在单个 token 上"奖励"偏离参考模型;
- k2 \(= \frac{1}{2}(\log r)^2\) 非负、方差小,但有偏;
- k3 \(= (r - 1) - \log r\) 无偏、非负、方差也小(因为 \(\mathbb{E}_q[r - 1] = 0\),它相当于给 k1 加了一个期望为 0 的控制变量)。GRPO 用的就是它。
推理模型的 RL 往往希望策略离初始模型越远越好(学会新的推理方式),DAPO 等做法干脆去掉了 KL 项。保留 KL 时要注意它的梯度:把 k3 直接当损失项求导,在 \(q\) 的样本上取期望,得到的是正向 KL\((p \| q)\) 的梯度 \(-\sum_x p(x) \nabla \log q(x)\),而不是它所估计的反向 KL\((q \| p)\) 的梯度——数值上估计的是一个量,优化的却是另一个,这是近来一些分析工作指出的细节。
重要性比:按 token 还是按序列
PPO / GRPO 对每个 token 单独计算比率、单独裁剪。更新之后,每个 token 的 log 比率都带着一点噪声(有限样本、学习率,MoE 模型里还有路由的变化):
import torch

torch.manual_seed(0)
# 模拟一批回答:用旧策略采样,更新几步之后,每个 token 的 log 比率 log(π/π_old) 带一点噪声
# (MoE 模型里,同一个 token 在新旧策略下可能被路由到不同的专家,噪声更大)
for sigma in (0.02, 0.2):
    print(f"每个 token 的 log 比率 ~ N(0, {sigma}²):")
    for L in (100, 1000, 4000):
        log_r = torch.randn(512, L) * sigma                   # 512 个回答,每个长 L
        clipped = ((log_r.exp() < 0.8) | (log_r.exp() > 1.28)).float().mean()   # 逐 token 裁剪(ε_low 0.2、ε_high 0.28)
        product = log_r.sum(1).exp()                          # 严格的序列级重要性权重:逐 token 比率的乘积
        geo = log_r.mean(1).exp()                             # GSPO:几何平均,按长度归一化
        print(f"  L={L:4d}:超出裁剪范围的 token {clipped:5.1%};比率的乘积在 [{product.min():.0e}, {product.max():.0e}];"
              f"几何平均在 [{geo.min():.4f}, {geo.max():.4f}]")
每个 token 的 log 比率 ~ N(0, 0.02²):
  L= 100:超出裁剪范围的 token  0.0%;比率的乘积在 [5e-01, 2e+00];几何平均在 [0.9932, 1.0057]
  L=1000:超出裁剪范围的 token  0.0%;比率的乘积在 [2e-01, 6e+00];几何平均在 [0.9983, 1.0018]
  L=4000:超出裁剪范围的 token  0.0%;比率的乘积在 [2e-02, 6e+01];几何平均在 [0.9990, 1.0010]
每个 token 的 log 比率 ~ N(0, 0.2²):
  L= 100:超出裁剪范围的 token 24.0%;比率的乘积在 [2e-03, 5e+02];几何平均在 [0.9392, 1.0639]
  L=1000:超出裁剪范围的 token 24.1%;比率的乘积在 [9e-10, 1e+07];几何平均在 [0.9794, 1.0164]
  L=4000:超出裁剪范围的 token 24.1%;比率的乘积在 [3e-17, 5e+22];几何平均在 [0.9905, 1.0132]
- 逐 token 裁剪时,噪声一大,四分之一的 token 超出裁剪范围、梯度被丢掉,而且这和回答多长无关;
- 从定义上说,一个回答的重要性权重应该是所有 token 比率的乘积。但乘积随长度指数发散:4000 个 token 时横跨 39 个数量级,完全没法用;
- GSPO 用几何平均 \(\big(\pi_\theta(y) / \pi_{\text{old}}(y)\big)^{1/|y|}\):按长度归一化之后始终在 1 附近,回答越长越稳定。它在序列级上做裁剪,裁剪范围设得很窄(论文里是 \(3 \times 10^{-4}\)、\(4 \times 10^{-4}\))。被整条裁掉的回答比例反而比 GRPO 被裁掉的 token 多得多,训练效率却更高——说明逐 token 的比率噪声太大,留下的梯度也没有多少有用的信息。Qwen3 的 MoE 模型用它训练,不再需要"路由回放"这类为了稳定 MoE 的额外措施。
CISPO(MiniMax-M1)换了一个角度:目标函数写成 \(\mathrm{sg}\big(\mathrm{clip}(r_t)\big) \cdot A_t \cdot \log \pi_\theta(o_t)\),裁剪的是重要性权重(不回传梯度),每个 token 的梯度都保留下来。PPO 式的裁剪会把比率超出范围的 token 整个丢掉,而这些 token 往往正是推理中关键的"转折"词(例如"不过""等等,我再检查一下"),CISPO 认为保留它们的梯度对学会反思很重要。
训练端与推理端不一致
RL 的样本由推理引擎采样,概率由训练端重算。两边的数值实现不同(kernel、精度、批的组成),同一个 token 的概率会有差异(推理系统手册在 Qwen3-0.6B 上实测,bf16 下可以相差 10%,见 RL 训练中的推理)。于是训练其实是 off-policy 的:样本来自推理端的分布 \(\mu\),要估计的却是训练端策略 \(\pi\) 的梯度。
import torch

torch.manual_seed(0)
V = 200
logits = torch.randn(V) * 2
pi = logits.softmax(-1)                                        # 训练端的策略
noise = 0.2 * torch.randn(V)
noise[logits.argsort()[-8:-5]] -= 3                            # 少数几个 token 的概率被推理端严重低估(比如某个 kernel 的精度问题)
mu = (logits + noise).softmax(-1)                              # 推理引擎实际采样用的分布
A = torch.randn(V)                                             # 每个动作的优势
true_grad = (pi * A)[:, None] * (torch.eye(V) - pi[None, :])  # 精确的策略梯度 E_π[A ∇log π],对 logits 求导
true_grad = true_grad.sum(0)

w = pi / mu
print(f"重要性比 π/μ:中位数 {w.median():.2f},最大 {w.max():.1f},最小 {w.min():.2f}")


def estimate(kind, n=256, C=2.0, gen=None):
    a = torch.multinomial(mu, n, replacement=True, generator=gen)   # 只能拿到推理端采的样本
    score = torch.eye(V)[a] - pi                               # ∇ log π(a) 对 logits 的梯度
    ratio = w[a]
    weight = {"不修正": torch.ones(n), "重要性采样": ratio, "TIS(截断到 2)": ratio.clamp(max=C),
              "MIS(比率超过 2 的丢掉)": ratio * (ratio <= C)}[kind]
    return (weight * A[a])[:, None].mul(score).mean(0)


gen = torch.Generator().manual_seed(1)
for kind in ("不修正", "重要性采样", "TIS(截断到 2)", "MIS(比率超过 2 的丢掉)"):
    est = torch.stack([estimate(kind, gen=gen) for _ in range(400)])
    bias = (est.mean(0) - true_grad).norm() / true_grad.norm()
    noise = (est - est.mean(0)).norm(dim=1).mean() / true_grad.norm()
    print(f"{kind:18s} 偏差 {bias:5.1%},单个 batch 的噪声 {noise:5.1%}")
重要性比 π/μ:中位数 0.95,最大 19.7,最小 0.56
不修正                偏差 42.5%,单个 batch 的噪声 30.3%
重要性采样              偏差  2.4%,单个 batch 的噪声 54.8%
TIS(截断到 2)         偏差 23.6%,单个 batch 的噪声 30.6%
MIS(比率超过 2 的丢掉)    偏差 26.8%,单个 batch 的噪声 29.6%
- 不修正:梯度有很大的系统偏差,积累下去会让训练悄悄偏离,严重时崩溃;
- 重要性采样(乘 \(\pi / \mu\)):无偏,但少数比率很大的样本让方差几乎翻倍;
- TIS(Truncated IS,把比率截断到 \(C\))和 MIS(Masked IS,比率超过 \(C\) 的样本直接丢掉):用一部分偏差换回可控的方差。实际系统里比率绝大多数接近 1,截断和丢弃只影响少数异常样本,偏差比这个刻意放大的例子小得多。
这要求推理引擎返回采样时每个 token 的 logprob。异步 RL(推理用的是落后几个版本的权重,见推理系统手册的异步 RL)带来的偏差是同一类问题,用同样的办法修正,并限制落后的版本数。更根本的办法是让两边算得一模一样:推理端用与批无关的确定性 kernel,训练端用相同的实现(见推理系统手册的确定性推理)。
怎么讲清楚
讲"GRPO 有哪些问题,后来的算法怎么改的":按损失函数的四个部件讲——优势(组内减均值;全对全错的组没有信号 → DAPO 动态采样;除以标准差带来难度偏差 → Dr. GRPO 去掉);平均方式(按回答平均会让长回答的每个 token 权重变小 → token 平均);重要性比与裁剪(逐 token 比率噪声大 → GSPO 序列级几何平均;裁剪把关键 token 的梯度丢掉 → CISPO 裁剪权重;上界太紧导致熵坍缩 → DAPO Clip-Higher);KL(k3 估计量;推理 RL 常去掉)。再补一句系统层面的:训练端与推理端概率不一致要用 TIS / MIS 修正,这要求推理引擎返回 logprobs。
练习
1. Clip-Higher 为什么能防止熵坍缩? 旧概率 0.01 和 0.9 的两个 token,优势都为正。\(\epsilon = 0.2\) 时一次更新各自最多能涨到多少?上界放宽到 \(0.28\) 呢?
参考答案
比率上限 \(1 + \epsilon\) 限制的是相对变化:0.01 最多到 0.012(放宽后 0.0128),0.9 最多到 1.08,实际上不受限制(概率不超过 1)。高概率的 token 很容易被推得更高,低概率的"探索性" token 每次只能涨一点点,策略于是越来越确定、熵迅速下降。放宽上界让低概率 token 涨得快一些,熵下降得慢。下界不放宽,是为了防止低概率 token 被一步压到接近 0、再也采不到。
2. 为什么原始 GRPO 会让回答越来越长? 用本章的权重表解释。
参考答案
按回答平均时,一个错误回答的总惩罚固定,与长度无关,分摊到每个 token 就与长度成反比:同样是错,写得越长,每个 token 受到的惩罚越小,模型没有压力去缩短错误的回答;而对正确的回答,短的每个 token 得到的奖励反而更大。两者叠加,错误回答倾向于变长。token 平均(DAPO)或者按固定的最大长度归一化(Dr. GRPO)消除了这个偏差。
3. 一个 MoE 模型做 RL,训练到一半 loss 和奖励突然崩掉。你会从哪些方向查?
参考答案
先看训练端与推理端的 logprob 差异(对 MoE,同一个 token 两边的路由可能不同,差异远大于稠密模型)和重要性比的分布:比率的尾部是否在变长、被裁剪的 token 比例是否在上升。对应的办法有:换成序列级的比率(GSPO)、把推理端的路由结果回传给训练端(路由回放)、加 TIS / MIS 修正或丢掉比率异常的样本、提高推理端数值的一致性(确定性 kernel、fp32 的 lm_head)。再看熵是否在崩溃前迅速下降(Clip-Higher、降低学习率),以及奖励是否被"钻了空子"(奖励黑客,例如格式奖励被利用)。
小结
- GRPO 用组内基线代替 critic;全对全错的组没有信号(DAPO 动态采样),除以标准差引入难度偏差(Dr. GRPO 去掉)。
- 按回答平均会让长回答的每个 token 权重变小,助长冗长的错误回答;DAPO 改成 token 平均。
- KL 的 k3 估计量无偏、非负、方差小;推理 RL 常去掉 KL 项。
- 逐 token 的比率噪声大、会丢掉梯度;序列级的乘积随长度发散,GSPO 用几何平均并做序列级裁剪;CISPO 裁剪权重而保留每个 token 的梯度;Clip-Higher 防止熵坍缩。
- 训练端与推理端的概率不一致让 RL 变成 off-policy:重要性采样无偏但方差大,TIS / MIS 截断或丢弃异常比率,需要推理引擎返回 logprobs。
本章练习题(1 道)
在浏览器里直接写代码、跑测试;也可以在本地用 python practice/judge.py 判题。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题