ZeRO 与 FSDP:切分优化器状态、梯度与参数
数据并行的每张卡都放着一份完整的模型状态:参数、梯度、优化器状态,每参数 16 字节。64 张卡就存了 64 份一模一样的 Adam 状态——这是巨大的浪费。ZeRO 的思路是:既然每张卡只需要在某个时刻用到某一部分,那就把这些状态切开,每张卡只存 1/N,用的时候再通信取回。这一章从零实现一个切分优化器状态的 Adam,再用 PyTorch 的 FSDP2 在 CPU 上跑一遍,并把三个级别的显存和通信代价算清楚。
自测:能答上来就可以跳过本章
- ZeRO-1、ZeRO-2、ZeRO-3 分别切分了什么?每张卡的模型状态各是多少?
- ZeRO-1、2 的通信量和普通数据并行相比是多少?ZeRO-3 呢?
- ZeRO-3 在前向和反向中什么时候通信?为什么要"预取"?
- FSDP 和 ZeRO-3 是什么关系?"FSDP 单元"的粒度怎么选?
- ZeRO 能减少激活占用的显存吗?
自测参考答案(先自己答,再展开对照)
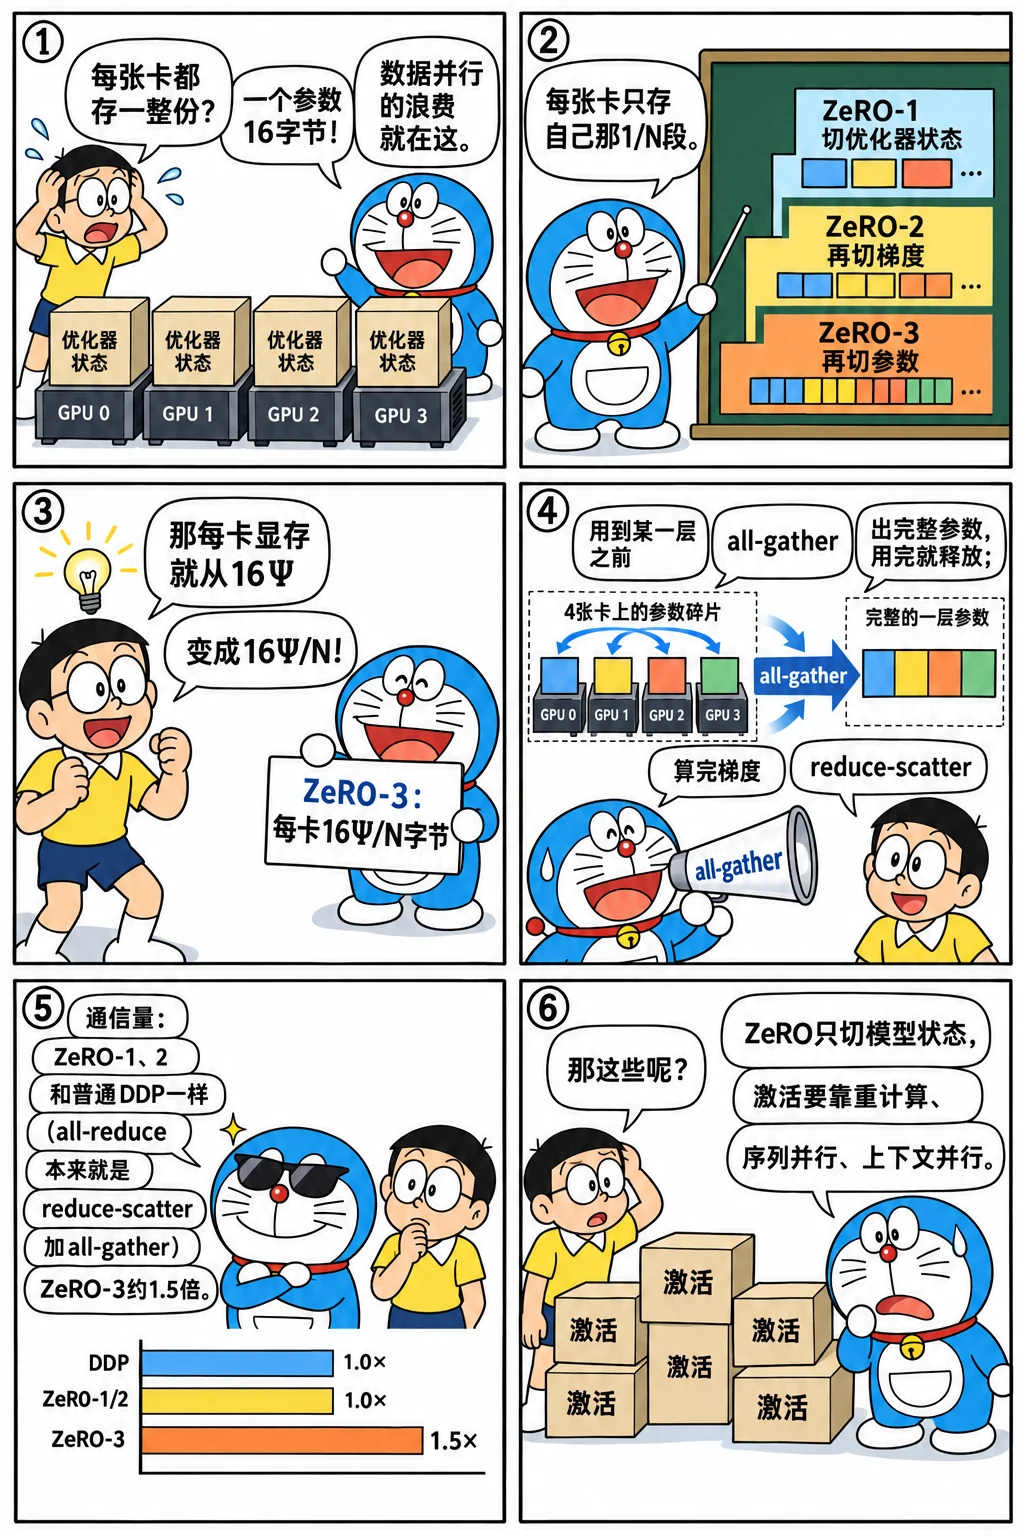
- ZeRO-1 切优化器状态,每卡 \(4\Psi + 12\Psi/N\) 字节;ZeRO-2 再切梯度,\(2\Psi + 14\Psi/N\);ZeRO-3 再切参数,\(16\Psi/N\)(\(\Psi\) 是参数量,\(N\) 是卡数)。
- ZeRO-1、2 与普通数据并行相同:all-reduce 本来就等于 reduce-scatter + all-gather,只是拆开来用(先 reduce-scatter 梯度、更新自己那一段,再 all-gather 参数)。ZeRO-3 约是 1.5 倍:前向、反向各要 all-gather 一次参数,再加一次梯度的 reduce-scatter。
- 每个单元(一层或几层)在前向和反向用到之前 all-gather 出完整参数,用完就释放;反向算完一个单元的梯度后 reduce-scatter。预取就是在算当前单元时提前发起下一个单元的 all-gather,把通信藏到计算后面。
- FSDP 是 PyTorch 对 ZeRO-3 思路的实现。单元太小,通信次数多、每次消息小,效率低;太大,同时展开的完整参数多,显存峰值高——通常按 Transformer 层包装。
- 不能,它只切模型状态(参数、梯度、优化器状态)。激活要靠重计算、张量并行加序列并行、上下文并行来减少。
先看一个六格小剧场,再读正文:
三个级别
设参数量为 \(\Psi\)、数据并行度为 \(N\),混合精度 Adam 下:
| 级别 | 切分 | 每张卡的模型状态 | 每步通信量(每张卡发送) |
|---|---|---|---|
| 数据并行 | 不切分 | \(16\Psi\) | all-reduce bf16 梯度:约 \(2 \times 2\Psi = 4\Psi\) 字节 |
| ZeRO-1 | 优化器状态 | \(4\Psi + 12\Psi/N\) | 同上(reduce-scatter 梯度 + all-gather 参数,总量和 all-reduce 相同) |
| ZeRO-2 | + 梯度 | \(2\Psi + 14\Psi/N\) | 同上 |
| ZeRO-3 | + 参数 | \(16\Psi/N\) | 约 1.5 倍:前向 all-gather 参数、反向再 all-gather 一次、reduce-scatter 梯度 |
换个模型规模和并行度,看四级各自还剩多少、够不够塞进一张卡:
ZeRO-1、2 不增加通信:all-reduce 本来就是 reduce-scatter + all-gather,ZeRO 只是把中间那一步(优化器更新)放在切片上做——reduce-scatter 之后每张卡恰好只拿到自己那片的梯度总和,用它更新自己那片的参数,再 all-gather 回完整参数。ZeRO-3 连参数都不常驻,前向、反向用到每一层之前都要 all-gather 这一层的参数,所以多了一次参数的 all-gather。
从零实现 ZeRO 的 Adam
把所有参数展平成一个一维向量,按 rank 均分成 \(N\) 片。每个 rank 只保存自己那一片的主参数和 Adam 的两个矩:
import math

import torch
import torch.distributed as dist


class ZeroAdam:
    """ZeRO(第 2 级)的 Adam:梯度用 reduce-scatter 求和并切分,每个 rank 只保存、只更新自己那一片参数的
    主参数和 Adam 状态,更新完用 all-gather 把参数拼回来。"""

    def __init__(self, params, lr, betas=(0.9, 0.999), eps=1e-8):
        self.params = list(params)
        self.lr, self.betas, self.eps, self.t = lr, betas, eps, 0
        self.rank, self.world = dist.get_rank(), dist.get_world_size()
        self.numel = sum(p.numel() for p in self.params)
        self.shard = math.ceil(self.numel / self.world)          # 每个 rank 负责的元素个数(末尾补零对齐)
        flat = self._flatten([p.data for p in self.params])
        lo = self.rank * self.shard
        self.master = flat[lo:lo + self.shard].clone()           # 只保存自己那一片(真实训练里这是 fp32 主参数)
        self.m = torch.zeros_like(self.master)
        self.v = torch.zeros_like(self.master)

    def _flatten(self, tensors):
        flat = torch.zeros(self.shard * self.world)
        flat[:self.numel] = torch.cat([t.flatten() for t in tensors])
        return flat

    def step(self):
        grads = self._flatten([p.grad for p in self.params])
        g = torch.empty(self.shard)
        dist.reduce_scatter_tensor(g, grads)                     # 求和并切分:每个 rank 只拿到自己那片的梯度
        g /= self.world                                          # 求平均
        self.t += 1
        b1, b2 = self.betas
        self.m.mul_(b1).add_(g, alpha=1 - b1)
        self.v.mul_(b2).addcmul_(g, g, value=1 - b2)
        m_hat = self.m / (1 - b1 ** self.t)
        v_hat = self.v / (1 - b2 ** self.t)
        self.master -= self.lr * m_hat / (v_hat.sqrt() + self.eps)
        full = torch.empty(self.shard * self.world)
        dist.all_gather_into_tensor(full, self.master)           # 把各 rank 更新好的片拼回完整参数
        offset = 0
        for p in self.params:
            p.data.copy_(full[offset:offset + p.numel()].view_as(p))
            offset += p.numel()

    def zero_grad(self):
        for p in self.params:
            p.grad = None

    def state_bytes(self):
        return sum(t.numel() * t.element_size() for t in (self.master, self.m, self.v))
在 4 个进程上训练 3 步,和"单进程在完整 batch 上用 torch.optim.Adam"对比:
import torch
import torch.distributed as dist

from zero_adam import ZeroAdam

dist.init_process_group("gloo")
rank, world = dist.get_rank(), dist.get_world_size()


def make_model():
    torch.manual_seed(0)
    return torch.nn.Sequential(torch.nn.Linear(64, 256), torch.nn.GELU(), torch.nn.Linear(256, 10))


torch.manual_seed(123)
X, Y = torch.randn(32, 64), torch.randint(0, 10, (32,))
local = slice(rank * 32 // world, (rank + 1) * 32 // world)
loss_fn = torch.nn.CrossEntropyLoss()

ref, model = make_model(), make_model()
opt_ref = torch.optim.Adam(ref.parameters(), lr=1e-2)
opt = ZeroAdam(model.parameters(), lr=1e-2)
for step in range(3):
    opt_ref.zero_grad()
    loss_fn(ref(X), Y).backward()
    opt_ref.step()
    opt.zero_grad()
    loss_fn(model(X[local]), Y[local]).backward()
    opt.step()

diff = max((a - b).abs().max().item() for a, b in zip(ref.parameters(), model.parameters()))
full_state = 3 * sum(p.numel() for p in model.parameters()) * 4   # 不切分时:主参数 + 两个矩,fp32
if rank == 0:
    print("训练 3 步后与单进程的 Adam 一致:", diff < 1e-5)
    print(f"每个 rank 的优化器状态 {opt.state_bytes()} 字节,不切分时 {full_state} 字节,约为 1/{round(full_state / opt.state_bytes())}")
dist.destroy_process_group()
这个实现里每个 rank 的梯度仍然是完整的(反向照常产生完整梯度),真正的 ZeRO-2 会在反向过程中按桶 reduce-scatter,桶发出去之后立刻释放完整的梯度,所以梯度的常驻显存也降到 \(1/N\)。
ZeRO-3 与 FSDP
ZeRO-3 把参数也切开。模型被分成若干单元(通常是一个 Transformer 层),每个单元的执行流程是:
- 前向:all-gather 这个单元的完整参数 → 计算 → 释放完整参数,只留自己那一片;
- 反向:再 all-gather 一次完整参数 → 计算梯度 → reduce-scatter 梯度,每个 rank 留下自己那片的梯度 → 释放完整参数和完整梯度。
所以任意时刻只有"当前正在计算的那一个单元"的完整参数在显存里。为了让通信不暴露,要预取:计算第 \(i\) 层的同时 all-gather 第 \(i+1\) 层的参数。单元越大,通信越少越大块,但峰值显存越高;按 Transformer 层划分是常见的折中。
PyTorch 的 FSDP(Fully Sharded Data Parallel)就是 ZeRO-3 的实现。新版的 FSDP2(fully_shard)把每个参数表示成按第 0 维切分的 DTensor:
import torch
import torch.distributed as dist
from torch.distributed.device_mesh import init_device_mesh
from torch.distributed.fsdp import fully_shard

dist.init_process_group("gloo")
rank, world = dist.get_rank(), dist.get_world_size()
mesh = init_device_mesh("cpu", (world,))          # GPU 上是 init_device_mesh("cuda", ...)


def make_model():
    torch.manual_seed(0)
    return torch.nn.Sequential(torch.nn.Linear(64, 256), torch.nn.GELU(), torch.nn.Linear(256, 10))


torch.manual_seed(123)
X, Y = torch.randn(32, 64), torch.randint(0, 10, (32,))
local = slice(rank * 32 // world, (rank + 1) * 32 // world)
loss_fn = torch.nn.CrossEntropyLoss()

ref, model = make_model(), make_model()
for layer in model:                               # 每个线性层是一个 FSDP 单元:用到它时才 all-gather 它的参数
    if isinstance(layer, torch.nn.Linear):
        fully_shard(layer, mesh=mesh)
fully_shard(model, mesh=mesh)

w = model[0].weight
shapes = [None] * world
dist.all_gather_object(shapes, tuple(w.to_local().shape))
opt_ref = torch.optim.Adam(ref.parameters(), lr=1e-2)
opt = torch.optim.Adam(model.parameters(), lr=1e-2)    # 优化器直接作用在切分后的参数上:状态也是切分的
for step in range(3):
    opt_ref.zero_grad()
    loss_fn(ref(X), Y).backward()
    opt_ref.step()
    opt.zero_grad()
    loss_fn(model(X[local]), Y[local]).backward()
    opt.step()

full = [p.full_tensor() for p in model.parameters()]   # 调试时把切片拼回完整参数
diff = max((a - b).abs().max().item() for a, b in zip(ref.parameters(), full))
if rank == 0:
    print(f"第一层权重的类型:{type(w).__name__},完整形状 {tuple(w.shape)},各 rank 本地的形状 {shapes}")
    print("训练 3 步后与单进程一致:", diff < 1e-5)
dist.destroy_process_group()
每个 rank 本地只有 128 行;优化器直接作用在切分后的参数上,于是优化器状态天然也是切分的。
什么时候用哪一级
- ZeRO-1 / ZeRO-2:不增加通信,几乎是免费的显存节省,配合张量并行、流水线并行时最常用(Megatron-LM 的"分布式优化器"就是 ZeRO-1);
- ZeRO-3 / FSDP:模型状态在数据并行维度上完全切开,适合"模型不算太大、不想用张量并行"的场景(比如几十 B 以内的模型用纯 FSDP 训练,torchtitan、很多 RL 框架的训练侧都这样做);代价是 1.5 倍的通信,以及每层的 all-gather 延迟需要靠预取藏住;
- ZeRO 不减少激活:激活和批大小、序列长度成正比,要靠重计算、张量并行 + 序列并行、上下文并行来解决(总论里 ZeRO-3 之后仍然放不下的那一行就是激活)。
卸载(ZeRO-Offload / ZeRO-Infinity)把优化器状态甚至参数放到 CPU 内存或 NVMe 上,用 PCIe 带宽换显存,适合卡少、模型大、对速度要求不高的场景。
怎么讲清楚
讲 ZeRO 先报每张卡的模型状态(\(\Psi\) 为参数量、\(N\) 为卡数):ZeRO-1 切优化器状态 \(4\Psi + 12\Psi/N\),ZeRO-2 再切梯度 \(2\Psi + 14\Psi/N\),ZeRO-3 再切参数 \(16\Psi/N\)。通信:ZeRO-1、2 与普通数据并行相同(all-reduce 拆成 reduce-scatter + all-gather),ZeRO-3 约 1.5 倍——前向、反向各要 all-gather 一次参数,靠按单元预取藏住。FSDP 就是 PyTorch 版的 ZeRO-3,FSDP2 用按第 0 维切分的 DTensor 表示参数。最后提醒:ZeRO 不减少激活,激活要靠重计算、TP + SP、CP。
练习
- 一个 13B 模型在 16 张 80 GB 的卡上训练。分别算出 ZeRO-1、ZeRO-2、ZeRO-3 下每张卡的模型状态。只看模型状态,哪一级之后能留出 40 GB 以上给激活?
参考答案
\(\Psi = 13 \times 10^9\),\(N = 16\):ZeRO-1 \(= 4\Psi + 12\Psi/16 = 52 + 9.75 = 61.75\) GB;ZeRO-2 \(= 2\Psi + 14\Psi/16 = 26 + 11.4 = 37.4\) GB;ZeRO-3 \(= 16\Psi/16 = 13\) GB。 留出 40 GB 给激活(80 GB 卡上模型状态不超过约 40 GB):ZeRO-2 勉强够,ZeRO-3 很充裕。
- 为什么说 ZeRO-1 和 ZeRO-2 "不增加通信",而不是"通信量减半"?
参考答案
普通数据并行的 all-reduce 在实现上就是 reduce-scatter + all-gather,每张卡发送 \(2(N-1)/N\) 倍的梯度大小。 ZeRO-1、2 把这两步拆开:reduce-scatter 梯度、在切片上更新、all-gather 参数。参数和梯度同样是 bf16、大小相同,所以总的通信量和 all-reduce 完全一样——省下的只是显存,通信既没多也没少。
小结
- ZeRO-1 切优化器状态,ZeRO-2 再切梯度,ZeRO-3 再切参数;每张卡的模型状态分别是 \(4\Psi + 12\Psi/N\)、\(2\Psi + 14\Psi/N\)、\(16\Psi/N\)。
- ZeRO-1、2 的通信量与普通数据并行相同(all-reduce 拆成 reduce-scatter + all-gather);ZeRO-3 约 1.5 倍。
- ZeRO-3 / FSDP 按单元在用之前 all-gather 参数、用完释放,靠预取藏住通信;FSDP2 用按第 0 维切分的 DTensor 表示参数。
- ZeRO 不减少激活;激活要靠重计算、TP + SP、CP。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题