流水线并行:从 GPipe 到零气泡
流水线并行(PP)按深度把模型切成若干段(stage),每张卡负责连续的几层,激活在相邻的卡之间点对点传递。它的通信量小、可以跨节点,但有一个天生的问题:流水线的"灌满"和"排空"期间总有卡在等待,这就是气泡。这一章先用一个调度模拟器把 GPipe 和 1F1B 的时间线画出来,再在多个进程上真跑一遍 1F1B、与单进程对齐梯度,最后介绍交错调度、零气泡和 DualPipe 是怎样继续压缩气泡的。
自测:能答上来就可以跳过本章
- 为什么流水线要把一个 batch 切成多个 micro-batch?
- GPipe 和 1F1B 的气泡一样大吗?它们的区别在哪?
- 1F1B 调度下,第一个 stage 最多同时保存几个 micro-batch 的激活?
- 交错式 1F1B(virtual pipeline)用什么换来了更小的气泡?
- 零气泡调度把反向拆成了哪两部分?为什么这样能填上气泡?
自测参考答案(先自己答,再展开对照)
- 只有一个 micro-batch 时,任何时刻只有一个 stage 在工作,利用率 \(1/p\);切成多个 micro-batch 之后,前一个离开第一个 stage 时下一个就能进来,多个 stage 同时工作,只剩开头灌满和结尾排空的气泡。
- 气泡一样大,都是 \((p-1)/(m+p-1)\)。区别在激活显存:GPipe 先做完所有前向,每个 stage 要同时保存 \(m\) 份激活;1F1B 预热之后一个前向一个反向交替,做完反向就释放。
- 最多 \(p\) 份(stage 数),与 micro-batch 数 \(m\) 无关。
- 每张卡负责多段不相邻的层(虚拟 stage),流水线变长、每段的计算变短,气泡缩小到原来的 \(1/v\);代价是点对点通信多了 \(v\) 倍。
- 拆成"对输入的梯度"(B,下一个 stage 等着要,必须尽快算)和"对权重的梯度"(W,谁也不等它,可以延后)。把 W 挪到原本空闲的气泡里去算,就把气泡填上了。
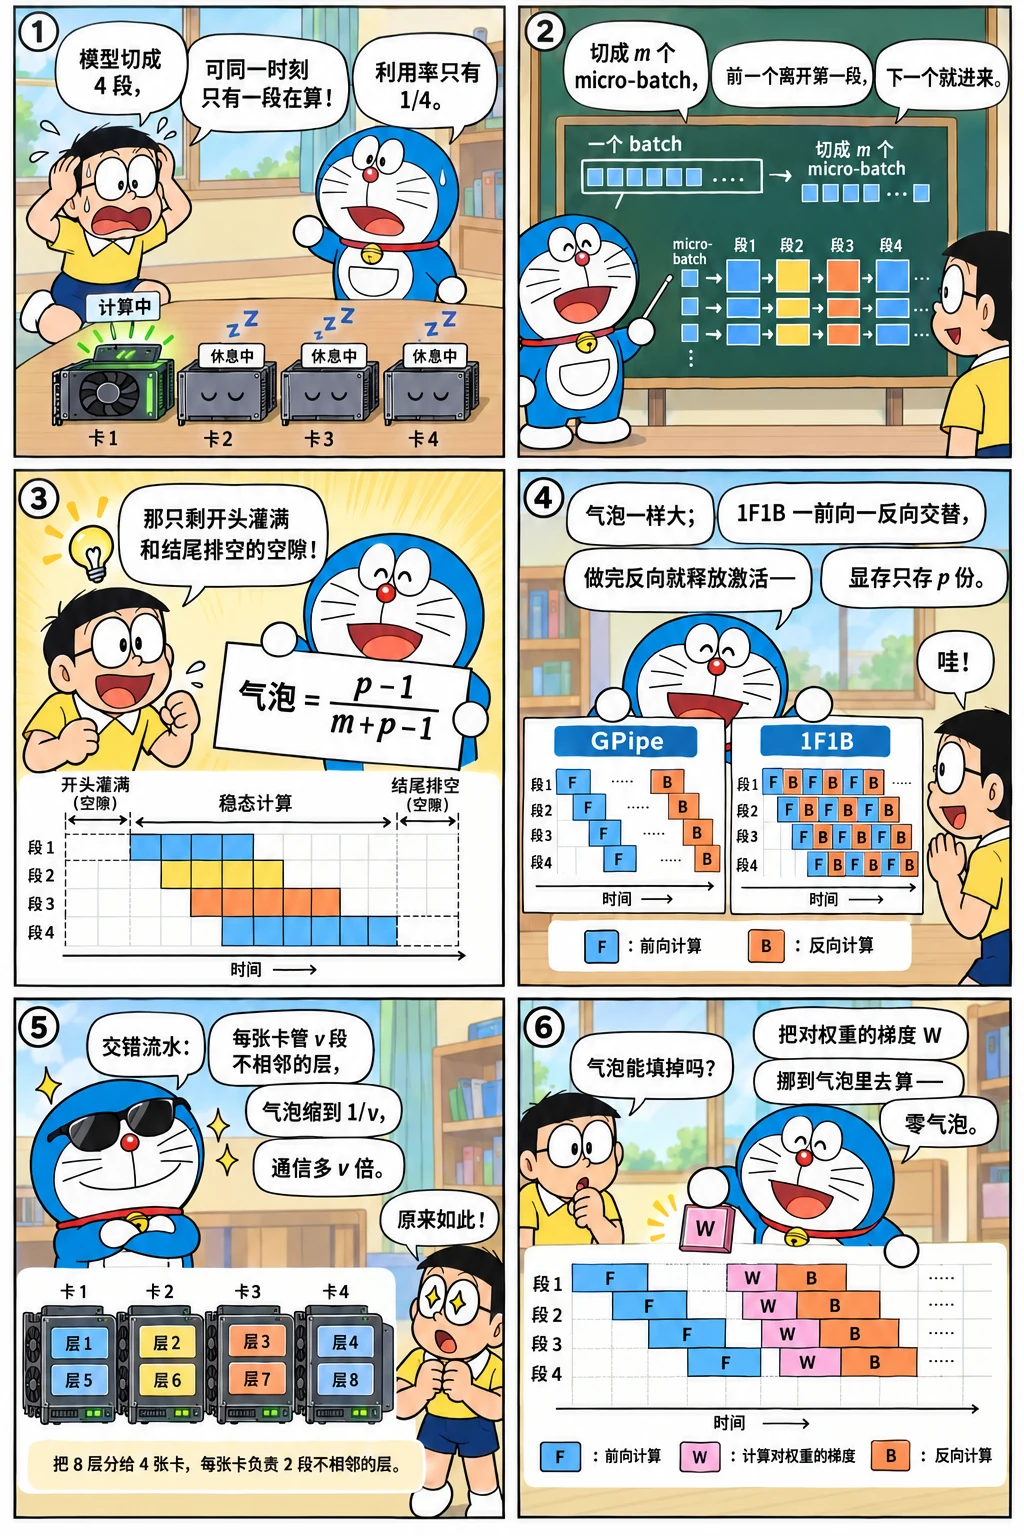
先看一个六格小剧场,再读正文:
气泡从哪里来
只有一个 micro-batch 时,\(p\) 个 stage 依次执行,任何时刻只有一张卡在工作,利用率 \(1/p\)。把 batch 切成 \(m\) 个 micro-batch,前一个 micro-batch 离开 stage 0 之后下一个就可以进入,多个 stage 就能同时工作——但开头要等流水线灌满、结尾要等它排空,这两段时间就是气泡。
下面的模拟器按依赖关系(stage \(s\) 的前向要等 stage \(s-1\) 的前向,反向要等 stage \(s+1\) 的反向)排出每个 stage 的时间线。数字是第几个 micro-batch 的前向(耗时 1),字母是对应的反向(耗时 2),. 是空闲:
def schedule(kind, p, m):
    """每个 stage 按什么顺序执行前向 (F, i) 和反向 (B, i)"""
    orders = []
    for s in range(p):
        if kind == "gpipe":
            orders.append([("F", i) for i in range(m)] + [("B", i) for i in range(m)])
        else:                                   # 1F1B:先做 p-s-1 个前向"预热",之后一前一后交替
            warm = min(p - s - 1, m)
            order = [("F", i) for i in range(warm)]
            for i in range(m - warm):
                order += [("F", warm + i), ("B", i)]
            order += [("B", i) for i in range(m - warm, m)]
            orders.append(order)
    return orders


def simulate(kind, p, m, tf=1, tb=2):
    orders, done, t_free = schedule(kind, p, m), {}, [0] * p
    pos, rows = [0] * p, [[] for _ in range(p)]
    live, peak = [0] * p, [0] * p
    while any(pos[s] < len(orders[s]) for s in range(p)):
        for s in range(p):
            if pos[s] == len(orders[s]):
                continue
            op, i = orders[s][pos[s]]
            dep = ("F", s - 1, i) if op == "F" else (("B", s + 1, i) if s < p - 1 else ("F", s, i))
            if op == "F" and s == 0:
                dep = None
            if dep is not None and dep not in done:
                continue
            start = max(t_free[s], done.get(dep, 0))
            end = start + (tf if op == "F" else tb)
            rows[s] += ["."] * (start - len(rows[s])) + [str(i) if op == "F" else chr(ord("a") + i)] * (end - start)
            done[(op, s, i)], t_free[s] = end, end
            live[s] += 1 if op == "F" else -1
            peak[s] = max(peak[s], live[s])
            pos[s] += 1
    total = max(t_free)
    busy = p * m * (tf + tb)
    return rows, total, 1 - busy / (p * total), peak


for kind in ("gpipe", "1f1b"):
    rows, total, bubble, peak = simulate(kind, p=4, m=8)
    print(f"{kind}:总时间 {total},气泡占比 {bubble:.1%},每个 stage 同时保存的激活份数 {peak}")
    for s, r in enumerate(rows):
        print(f"  stage {s} |{''.join(r).ljust(total, '.')}|")
print("理论气泡占比 (p-1)/(m+p-1) =", f"{3 / 11:.1%}")
gpipe:总时间 33,气泡占比 27.3%,每个 stage 同时保存的激活份数 [8, 8, 8, 8]
  stage 0 |01234567.........aabbccddeeffgghh|
  stage 1 |.01234567......aabbccddeeffgghh..|
  stage 2 |..01234567...aabbccddeeffgghh....|
  stage 3 |...01234567aabbccddeeffgghh......|
1f1b:总时间 33,气泡占比 27.3%,每个 stage 同时保存的激活份数 [4, 3, 2, 1]
  stage 0 |0123......aa4bb5cc6dd7ee.ff.gg.hh|
  stage 1 |.012....aa3bb4cc5dd6ee7ff.gg.hh..|
  stage 2 |..01..aa2bb3cc4dd5ee6ff7gg.hh....|
  stage 3 |...0aa1bb2cc3dd4ee5ff6gg7hh......|
理论气泡占比 (p-1)/(m+p-1) = 27.3%
两个结论:
- GPipe 和 1F1B 的气泡一样大,都是 \((p-1)/(m+p-1)\)。减小气泡的直接办法是增大 \(m\),但 \(m\) 受全局 batch 限制;
- 区别在显存:GPipe 先做完全部前向,每个 stage 要同时保存 \(m\) 个 micro-batch 的激活;1F1B 在预热之后"做一个前向就做一个反向",一个 micro-batch 的反向一做完它的激活就释放了,第一个 stage 最多保存 \(p\) 份。\(m\) 可以远大于 \(p\),所以 1F1B 是所有现代训练框架的默认调度。
自己拖一拖 p 和 m,对比两种调度的时间线、气泡和激活份数:
真跑一遍 1F1B
每个进程是一个 stage,负责两层。前向的激活用 isend 异步发给下一个 stage、用 recv 从上一个 stage 接收;反向时反过来传梯度。最后把每个 stage 的参数梯度和单进程在完整 batch 上的梯度比较:
import torch
import torch.distributed as dist

dist.init_process_group("gloo")
stage, p = dist.get_rank(), dist.get_world_size()
M, MB, H = 4, 2, 16                                     # micro-batch 个数、每个 micro-batch 的样本数、隐藏维度


def make_layers():
    torch.manual_seed(0)
    return [torch.nn.Sequential(torch.nn.Linear(H, H), torch.nn.Tanh()) for _ in range(2 * p)]


torch.manual_seed(1)
X, Y = torch.randn(M * MB, H), torch.randn(M * MB, H)
layers = make_layers()

# 单进程参照:整个模型、整个 batch(损失是全 batch 的平均,等于各 micro-batch 平均损失的平均)
ref = torch.nn.Sequential(*make_layers())
torch.nn.functional.mse_loss(ref(X), Y).backward()
ref_grads = [q.grad for q in ref.parameters()]

# 流水线:stage s 负责第 2s、2s+1 层
mine = torch.nn.Sequential(*layers[2 * stage:2 * stage + 2])
first, last = stage == 0, stage == p - 1
inputs, outputs, trace, pending = {}, {}, [], []


def forward(i):
    if first:
        x = X[i * MB:(i + 1) * MB]
    else:
        x = torch.empty(MB, H)
        dist.recv(x, stage - 1)                          # 收上一个 stage 的激活
        x.requires_grad_()
    y = mine(x)
    inputs[i], outputs[i] = x, y
    if not last:
        pending.append(dist.isend(y.detach(), stage + 1))   # 异步发给下一个 stage,不阻塞
    trace.append(f"F{i}")


def backward(i):
    y = outputs.pop(i)
    if last:
        (torch.nn.functional.mse_loss(y, Y[i * MB:(i + 1) * MB]) / M).backward()
    else:
        g = torch.empty(MB, H)
        dist.recv(g, stage + 1)                          # 收下一个 stage 传回的梯度
        y.backward(g)
    x = inputs.pop(i)
    if not first:
        pending.append(dist.isend(x.grad, stage - 1))    # 把对输入的梯度传回上一个 stage
    trace.append(f"B{i}")


warm = min(p - stage - 1, M)                             # 1F1B:先做几个前向"预热",然后一前一后交替
for i in range(warm):
    forward(i)
for i in range(M - warm):
    forward(warm + i)
    backward(i)
for i in range(M - warm, M):
    backward(i)
for w in pending:
    w.wait()

ok = all(torch.allclose(q.grad, r, atol=1e-6) for q, r in zip(mine.parameters(), ref_grads[4 * stage:4 * stage + 4]))
traces = [None] * p
dist.all_gather_object(traces, " ".join(trace))
flags = torch.tensor([int(ok)])
dist.all_reduce(flags, op=dist.ReduceOp.MIN)
if stage == 0:
    for s, t in enumerate(traces):
        print(f"stage {s} 的执行顺序:{t}")
    print("各 stage 的参数梯度与单进程一致:", bool(flags.item()))
dist.destroy_process_group()
stage 0 的执行顺序:F0 F1 F2 F3 B0 B1 B2 B3
stage 1 的执行顺序:F0 F1 F2 B0 F3 B1 B2 B3
stage 2 的执行顺序:F0 F1 B0 F2 B1 F3 B2 B3
stage 3 的执行顺序:F0 B0 F1 B1 F2 B2 F3 B3
各 stage 的参数梯度与单进程一致: True
几个实现上的要点:
- 发送用异步的
isend:如果用阻塞的send,stage 0 在等 stage 1 接收第二个激活时,stage 1 可能正在等 stage 0 接收第一个梯度,双方互相等待就死锁了; - 最后一个 stage 的损失除以 micro-batch 数 \(M\),各 micro-batch 的梯度累加起来,才等于整个 batch 的平均损失的梯度;
- 这里 \(M = p = 4\),stage 0 的预热正好把 4 个前向全做完,所以它的顺序和 GPipe 一样;\(M\) 更大时,中间就会出现一前一后交替的稳定阶段;
- 真实框架里每个 stage 内部还有 TP、DP,激活的形状也要在 stage 之间提前约定(或者先传一次形状)。
进一步压缩气泡
交错式 1F1B(Megatron 的 virtual pipeline):每张卡不再负责连续的一段层,而是负责 \(v\) 段不连续的层(比如 4 张卡、16 层,卡 0 负责第 0、4、8、12 层)。micro-batch 在卡之间转 \(v\) 圈,每一段的计算时间变成原来的 \(1/v\),灌满和排空也快了 \(v\) 倍,气泡变成 \(\frac{p-1}{v\,m + p - 1}\)。代价是点对点通信多了 \(v\) 倍。
零气泡(Zero Bubble):反向其实包含两部分——对输入的梯度 \(\partial L/\partial x\)(B,前一个 stage 在等它)和对权重的梯度 \(\partial L/\partial W\)(W,没人等它,只要在优化器更新之前算完就行)。把 W 拆出来往后挪,用它去填本来空闲的气泡,理论上可以把气泡压到接近零。
DualPipe(DeepSeek-V3):从流水线的两端同时送入 micro-batch(双向流水线),并把每个块内的计算与通信(尤其是专家并行的 all-to-all)精细地重叠起来。它针对的是"跨节点专家并行的通信很重"这一具体场景,代价是每张卡要保存两份参数。
怎么讲清楚
讲流水线:切成 \(m\) 个 micro-batch 才能让 \(p\) 个 stage 同时工作,灌满和排空造成的气泡占比 \((p-1)/(m+p-1)\);GPipe 和 1F1B 的气泡一样大,区别在显存——1F1B 让第一个 stage 最多同时保存 \(p\) 份激活(GPipe 是 \(m\) 份),所以是默认调度。继续压缩气泡:交错调度用 \(v\) 倍的点对点通信把气泡缩小 \(v\) 倍,零气泡把反向拆成"对输入的梯度"和"对权重的梯度"、用后者填气泡,DualPipe 双向流水并重叠计算与通信。实现时发送要异步,避免 stage 之间互相等待死锁。
练习
- 用本章的模拟器,把 \(p = 4\) 固定,\(m\) 分别取 4、8、16、32,记录 1F1B 的气泡占比,并与公式 \((p-1)/(m+p-1)\) 对比。
参考答案
气泡占比依次约为 42.9%、27.3%、15.8%、8.6%,与公式一致。\(m\) 翻倍,气泡大约减半;但 \(m\) 越大,每个 micro-batch 越小(全局 batch 固定时),矩阵乘的效率会下降,所以实际中 \(m\) 通常取 \(p\) 的 4~8 倍。
- 为什么流水线并行的通信量比张量并行小得多,却很少单独使用?
参考答案
PP 每个 micro-batch 在相邻 stage 之间只传一次激活(和一次梯度),约 \(sbh\) 个元素,远小于 TP 每层 4 次通信;而且可以跨节点。 但它有气泡,要靠很多 micro-batch 摊薄,而 micro-batch 数受全局 batch 限制;stage 之间还要负载均衡(嵌入层、输出层让首尾 stage 更重)。所以它通常和 TP(节点内)、DP(最外层)组合使用,用来把"一个 TP 组放不下的模型"按深度切开。
小结
- 流水线把 batch 切成 micro-batch 让多个 stage 同时工作;灌满和排空造成气泡,占比 \((p-1)/(m+p-1)\)。
- GPipe 和 1F1B 气泡相同,1F1B 把每个 stage 同时保存的激活从 \(m\) 份降到最多 \(p\) 份,是默认调度。
- 交错调度用 \(v\) 倍的点对点通信把气泡缩小 \(v\) 倍;零气泡把"对权重的梯度"挪去填气泡;DualPipe 双向流水并重叠计算与通信。
- 实现时发送要异步,避免 stage 之间互相等待死锁;损失按 micro-batch 数缩放。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题