GEMM 优化之路
矩阵乘法(GEMM)是深度学习里最重要的算子,大模型的绝大部分计算量都在这里。从一个每线程算一个元素的朴素版本,到接近 cuBLAS 的实现,要依次用上合并访问、共享内存分块、寄存器分块、向量化、双缓冲……这是 GPU 优化知识最集中的一章,也是面试"手写 kernel 并逐步优化"最常见的题目。
自测:能答上来就可以跳过本章
- M=N=K=4096 的 FP32 GEMM 有多少次浮点运算?最少要读写多少数据?它是计算瓶颈还是访存瓶颈?
- 朴素实现里,为什么让
threadIdx.x对应列比对应行快得多? - 共享内存分块把全局内存的访问量降低了多少倍?
- 寄存器分块(每个线程算 8×8 个输出)为什么还能再快好几倍?瓶颈从哪里转移到了哪里?
- 双缓冲解决的是什么问题?
自测参考答案(先自己答,再展开对照)
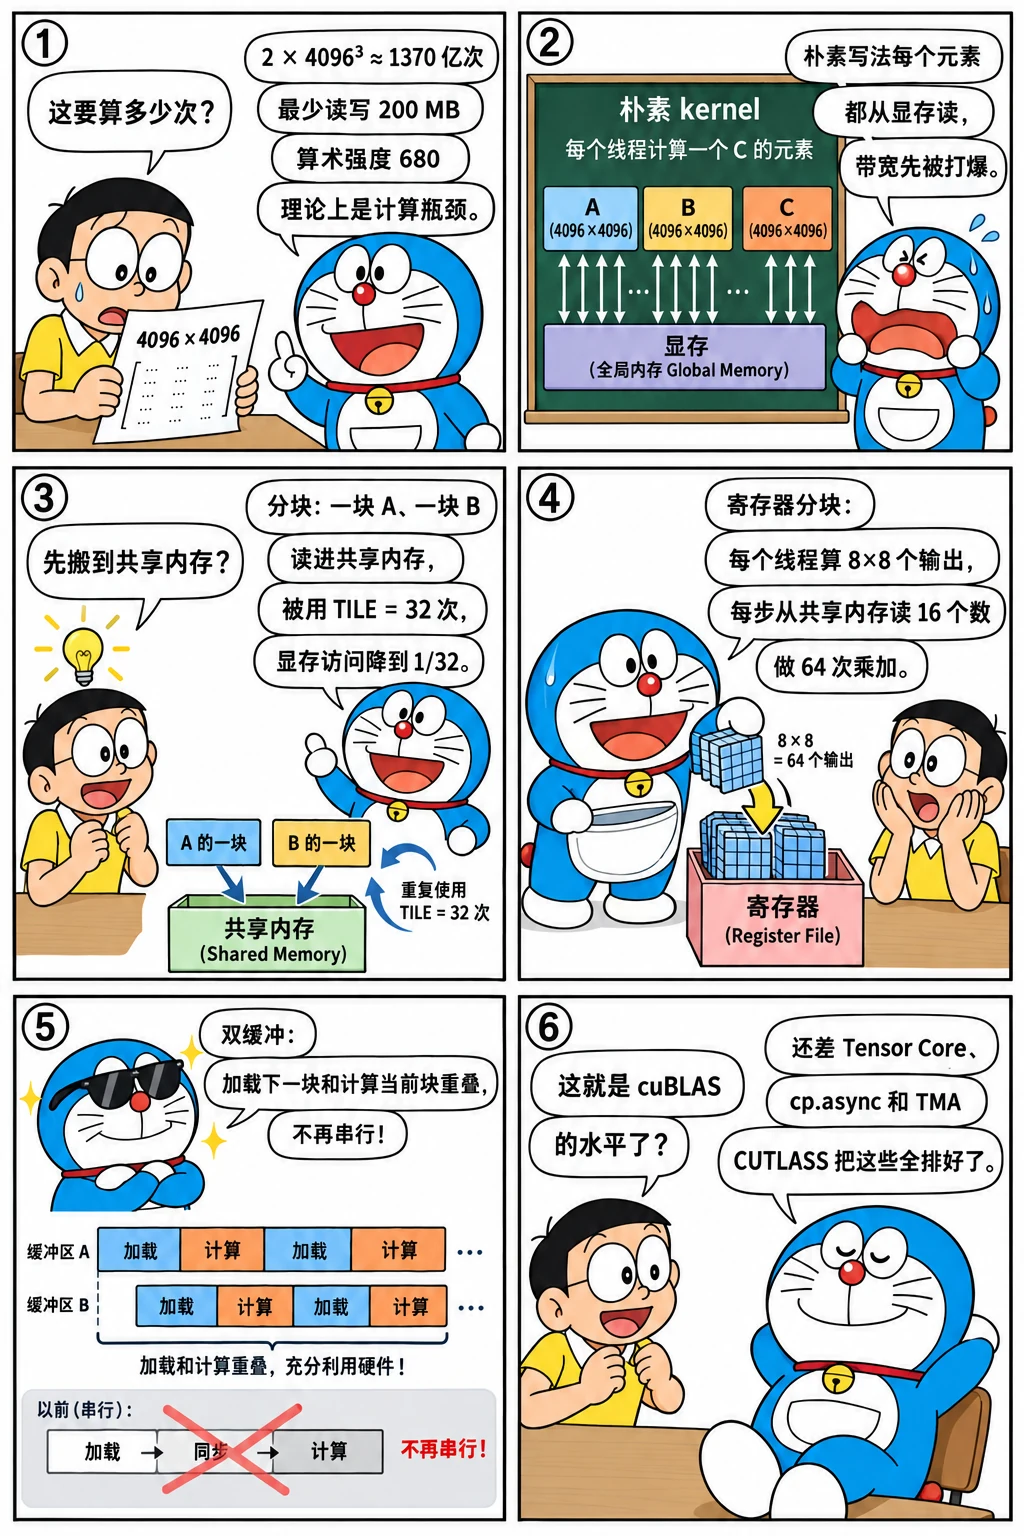
- \(2 \times 4096^3 \approx 1.37 \times 10^{11}\) 次运算;最少读 A、B、写 C 各 \(4096^2\) 个 float,约 200 MB。算术强度约 680 FLOP/字节,远高于屋脊点,理论上是计算瓶颈。
- 让
threadIdx.x对应列时,一个 warp 读 B 的同一行里连续的 32 个元素(合并)、读 A 的同一个元素(广播)、写 C 也连续;对应行时每个线程读 B 的不同行,完全不合并。 - 每个元素从全局内存读进共享内存后被使用 TILE 次(本章 TILE = 32),全局内存的访问量降低到 1/32。
- 每个线程在寄存器里算 8×8 个输出:每一步从共享内存读 8 + 8 个数,做 64 次乘加,复用从共享内存层提升到寄存器层(比例是只做共享内存分块时的 8 倍)。瓶颈从共享内存带宽和访存指令转移到了计算本身。
- 一边从全局内存加载下一块、一边用当前块计算:用两份共享内存缓冲区交替,把加载的延迟藏到计算后面,而不是"加载 → 同步 → 计算 → 同步"串行进行。
先看一个六格小剧场,再读正文:
问题定义与性能上限
计算 \(C = \alpha AB + \beta C\),其中 A 是 M×K,B 是 K×N,C 是 M×N,全部为行主序的 FP32 矩阵。
- 计算量:每个输出元素需要 K 次乘加,共 \(2MNK\) 次浮点运算。M=N=K=4096 时约 1374 亿次。
- 最少访存量:读 A、B,读写 C,约 \(4(MK + KN + 2MN)\) 字节。4096 时约 268 MB。
- 算术强度:约 1374e9 / 268e6 ≈ 512 FLOP/Byte,远高于任何 GPU 的脊点(A100 FP32 约 9.6)。
所以理论上大矩阵 GEMM 是计算瓶颈,性能上限是 FP32 峰值算力(A100 约 19.5 TFLOPS,4096 的 GEMM 理论最短约 7 ms)。但"最少访存量"的前提是每个数据只从显存读一次,朴素实现远远做不到:每个 A 元素会被读 N 次、每个 B 元素被读 M 次。GEMM 优化的主线,就是一步步提高数据复用率,把真实的算术强度拉到脊点之上,然后再优化计算本身的效率。
本章用 FP32 的 CUDA Core 实现来讲清这条主线。真正的大模型 GEMM 用 FP16/BF16/FP8 的 Tensor Core,思路完全相同,只是最内层的计算换成矩阵指令,见 Tensor Core。
v0 → v1:朴素实现与合并访问
每个线程计算 C 的一个元素:
__global__ void sgemm_naive(int M, int N, int K, float alpha, const float* A,
                            const float* B, float beta, float* C) {
  int row = blockIdx.x * blockDim.x + threadIdx.x;   // v0:x 对应行
  int col = blockIdx.y * blockDim.y + threadIdx.y;
  if (row < M && col < N) {
    float acc = 0.f;
    for (int k = 0; k < K; ++k) acc += A[row * K + k] * B[k * N + col];
    C[row * N + col] = alpha * acc + beta * C[row * N + col];
  }
}
同一个 warp 的 32 个线程 threadIdx.x 连续,对应 32 个不同的行:读 A 时 32 个线程访问 32 个不同行的同一列,地址相差 K 个元素,完全不合并;读 B 时 32 个线程读同一个元素(广播)。
v1 只改了一处:让 threadIdx.x 对应列。这样读 B 时 32 个线程访问同一行里连续的 32 个元素,合并;读 A 时 32 个线程读同一个元素,广播;写 C 也连续。仅仅换一下下标映射,性能就能提升好几倍。这是二维问题里最基本的习惯:让 threadIdx.x 沿着内存连续的维度变化。
但 v1 仍然很慢:每做一次乘加(2 FLOP),要从全局内存(其实大部分命中了 L1/L2)读两个 float(8 字节),算术强度只有 0.25 FLOP/Byte。
v2:共享内存分块
把 C 分成 32×32 的块,每个 block 负责一块。计算这一块需要 A 的 32 行和 B 的 32 列,沿 K 方向切成若干个 32×32 的小块,逐块处理:
- block 内 1024 个线程协作把 A 的一个 32×32 块和 B 的一个 32×32 块加载到共享内存(每个线程各加载一个元素,读取是合并的);
__syncthreads();- 每个线程用共享内存里的数据做 32 次乘加,累加到自己的寄存器;
__syncthreads()(确保大家都用完了,才能加载下一块覆盖它);- 沿 K 方向移动到下一块,重复。
for (int k0 = 0; k0 < K; k0 += TILE) {
  As[ty][tx] = A[row * K + k0 + tx];
  Bs[ty][tx] = B[(k0 + ty) * N + col];
  __syncthreads();
  for (int k = 0; k < TILE; ++k) acc += As[ty][k] * Bs[k][tx];
  __syncthreads();
}
每个从全局内存加载的元素,现在在共享内存里被使用了 32 次,全局内存的访问量降低到 1/32。
不过,内层循环每次乘加仍然要读两次共享内存(As[ty][k] 是 warp 内广播,Bs[k][tx] 是连续访问,都没有 bank 冲突)。共享内存的带宽虽然比显存高得多,但也是有限的:此时的瓶颈从显存转移到了共享内存带宽,以及大量的访存指令本身。
v3:一维寄存器分块
继续沿着"复用"的思路往下走:让每个线程计算多个输出元素,把复用从共享内存层提升到寄存器层。
v3 让每个线程计算同一列上的 TM = 8 个元素。block 负责 64×64 的 C 块,K 方向每次取 8:
for (int dot = 0; dot < BK; ++dot) {
  float b = Bs[dot * BN + threadCol];                 // 读一次 B
  for (int r = 0; r < TM; ++r)
    acc[r] += As[(threadRow * TM + r) * BK + dot] * b;  // 复用 8 次
}
每个从共享内存读出的 B 元素被放在寄存器里复用了 8 次。每个输出所需的共享内存读取次数从 2 次降到约 1.1 次。
v4:二维寄存器分块
再进一步,每个线程计算一个 TM×TN = 8×8 的输出小块。每一步 dot,线程从共享内存读 8 个 A 元素和 8 个 B 元素到寄存器,然后做 8×8 = 64 次乘加(外积):
for (int dot = 0; dot < BK; ++dot) {
  for (int i = 0; i < TM; ++i) regM[i] = As[(threadRow * TM + i) * BK + dot];
  for (int i = 0; i < TN; ++i) regN[i] = Bs[dot * BN + threadCol * TN + i];
  for (int m = 0; m < TM; ++m)
    for (int n = 0; n < TN; ++n) acc[m][n] += regM[m] * regN[n];
}
16 次共享内存读取支撑 64 次乘加,比例是 v2 的 8 倍。现在每个 block 负责 128×128 的 C 块、256 个线程,每个线程用 64 个寄存器存放累加结果。
这是 GEMM 优化里收益最大的一步。从这里开始,内层循环主要由 FFMA 指令组成,性能开始接近 CUDA Core 的计算上限。
为什么寄存器分块这么有效
分块的本质都是一样的:一个 a×b 的输出块,需要 a 个 A 元素和 b 个 B 元素,做 a×b 次乘加。访存量随周长增长,计算量随面积增长。块越大、越接近正方形,每次访存支撑的计算越多。GPU 的每一级存储都在做同样的事:显存 → 共享内存(block 级分块)、共享内存 → 寄存器(线程级分块),在 Tensor Core 版本里还会多一层 warp 级分块。
v5:向量化访存
v4 的内层循环里,读 As 的 8 个元素时地址相差 BK,是 8 条独立的标量读取。v5 做了两处改动:
- 加载 A 时转置存入共享内存:
As改为[BK][BM]布局,线程需要的 8 个 A 元素在共享内存里变成连续的,可以用两条 128 位指令读出; - 全局内存的读写都用
float4:读 A、B 和写 C 的指令数减少到 1/4。
这些改动减少了指令数和地址计算,让 FFMA 在指令流里的占比更高。
完整代码
// gemm.cu —— SGEMM 从朴素实现到二维寄存器分块 + 向量化
// 编译:nvcc -O3 -arch=sm_80 gemm.cu -o gemm
// 对比 cuBLAS:nvcc -O3 -arch=sm_80 -DWITH_CUBLAS gemm.cu -o gemm -lcublas
// 要求:M、N、K 都是 128 的倍数(为了代码简洁,没有处理边界)
#include "common.cuh"
#ifdef WITH_CUBLAS
#include <cublas_v2.h>
#endif
// ---------------- v0:threadIdx.x 对应行,访存不合并 ----------------
__global__ void sgemm_v0(int M, int N, int K, float alpha, const float* __restrict__ A,
const float* __restrict__ B, float beta, float* __restrict__ C) {
int row = blockIdx.x * blockDim.x + threadIdx.x;
int col = blockIdx.y * blockDim.y + threadIdx.y;
if (row < M && col < N) {
float acc = 0.f;
for (int k = 0; k < K; ++k) acc += A[row * K + k] * B[k * N + col];
C[row * N + col] = alpha * acc + beta * C[row * N + col];
}
}
// ---------------- v1:threadIdx.x 对应列,读 B / 写 C 合并 ----------------
__global__ void sgemm_v1(int M, int N, int K, float alpha, const float* __restrict__ A,
const float* __restrict__ B, float beta, float* __restrict__ C) {
int col = blockIdx.x * blockDim.x + threadIdx.x;
int row = blockIdx.y * blockDim.y + threadIdx.y;
if (row < M && col < N) {
float acc = 0.f;
for (int k = 0; k < K; ++k) acc += A[row * K + k] * B[k * N + col];
C[row * N + col] = alpha * acc + beta * C[row * N + col];
}
}
// ---------------- v2:32x32 共享内存分块 ----------------
template <int TILE>
__global__ void sgemm_v2(int M, int N, int K, float alpha, const float* __restrict__ A,
const float* __restrict__ B, float beta, float* __restrict__ C) {
__shared__ float As[TILE][TILE];
__shared__ float Bs[TILE][TILE];
const int tx = threadIdx.x, ty = threadIdx.y;
const int row = blockIdx.y * TILE + ty, col = blockIdx.x * TILE + tx;
float acc = 0.f;
for (int k0 = 0; k0 < K; k0 += TILE) {
As[ty][tx] = A[row * K + k0 + tx];
Bs[ty][tx] = B[(k0 + ty) * N + col];
__syncthreads();
#pragma unroll
for (int k = 0; k < TILE; ++k) acc += As[ty][k] * Bs[k][tx];
__syncthreads();
}
C[row * N + col] = alpha * acc + beta * C[row * N + col];
}
// ---------------- v3:一维寄存器分块,每线程算一列上的 TM 个元素 ----------------
template <int BM, int BN, int BK, int TM>
__global__ void __launch_bounds__((BM * BN) / TM)
sgemm_v3(int M, int N, int K, float alpha, const float* __restrict__ A, const float* __restrict__ B,
float beta, float* __restrict__ C) {
static_assert(BM * BK == (BM * BN) / TM && BN * BK == (BM * BN) / TM, "one element per thread per load");
__shared__ float As[BM * BK];
__shared__ float Bs[BK * BN];
const int threadCol = threadIdx.x % BN, threadRow = threadIdx.x / BN;
const int innerColA = threadIdx.x % BK, innerRowA = threadIdx.x / BK;
const int innerColB = threadIdx.x % BN, innerRowB = threadIdx.x / BN;
A += blockIdx.y * BM * K;
B += blockIdx.x * BN;
C += blockIdx.y * BM * N + blockIdx.x * BN;
float acc[TM] = {0.f};
for (int k0 = 0; k0 < K; k0 += BK) {
As[innerRowA * BK + innerColA] = A[innerRowA * K + innerColA];
Bs[innerRowB * BN + innerColB] = B[innerRowB * N + innerColB];
__syncthreads();
A += BK;
B += BK * N;
#pragma unroll
for (int dot = 0; dot < BK; ++dot) {
const float b = Bs[dot * BN + threadCol];
#pragma unroll
for (int r = 0; r < TM; ++r) acc[r] += As[(threadRow * TM + r) * BK + dot] * b;
}
__syncthreads();
}
#pragma unroll
for (int r = 0; r < TM; ++r) {
float& c = C[(threadRow * TM + r) * N + threadCol];
c = alpha * acc[r] + beta * c;
}
}
// ---------------- v4:二维寄存器分块,每线程算 TM x TN ----------------
template <int BM, int BN, int BK, int TM, int TN>
__global__ void __launch_bounds__((BM * BN) / (TM * TN))
sgemm_v4(int M, int N, int K, float alpha, const float* __restrict__ A, const float* __restrict__ B,
float beta, float* __restrict__ C) {
constexpr int kThreads = (BM * BN) / (TM * TN);
__shared__ float As[BM * BK];
__shared__ float Bs[BK * BN];
const int threadCol = threadIdx.x % (BN / TN), threadRow = threadIdx.x / (BN / TN);
const int innerRowA = threadIdx.x / BK, innerColA = threadIdx.x % BK;
constexpr int strideA = kThreads / BK;
const int innerRowB = threadIdx.x / BN, innerColB = threadIdx.x % BN;
constexpr int strideB = kThreads / BN;
A += blockIdx.y * BM * K;
B += blockIdx.x * BN;
C += blockIdx.y * BM * N + blockIdx.x * BN;
float acc[TM][TN] = {{0.f}};
float regM[TM], regN[TN];
for (int k0 = 0; k0 < K; k0 += BK) {
#pragma unroll
for (int off = 0; off < BM; off += strideA)
As[(innerRowA + off) * BK + innerColA] = A[(innerRowA + off) * K + innerColA];
#pragma unroll
for (int off = 0; off < BK; off += strideB)
Bs[(innerRowB + off) * BN + innerColB] = B[(innerRowB + off) * N + innerColB];
__syncthreads();
A += BK;
B += BK * N;
#pragma unroll
for (int dot = 0; dot < BK; ++dot) {
#pragma unroll
for (int i = 0; i < TM; ++i) regM[i] = As[(threadRow * TM + i) * BK + dot];
#pragma unroll
for (int i = 0; i < TN; ++i) regN[i] = Bs[dot * BN + threadCol * TN + i];
#pragma unroll
for (int m = 0; m < TM; ++m)
#pragma unroll
for (int n = 0; n < TN; ++n) acc[m][n] += regM[m] * regN[n];
}
__syncthreads();
}
#pragma unroll
for (int m = 0; m < TM; ++m)
#pragma unroll
for (int n = 0; n < TN; ++n) {
float& c = C[(threadRow * TM + m) * N + threadCol * TN + n];
c = alpha * acc[m][n] + beta * c;
}
}
// ---------------- v5:v4 + A 转置存入共享内存 + float4 访存 ----------------
template <int BM, int BN, int BK, int TM, int TN>
__global__ void __launch_bounds__((BM * BN) / (TM * TN))
sgemm_v5(int M, int N, int K, float alpha, const float* __restrict__ A, const float* __restrict__ B,
float beta, float* __restrict__ C) {
constexpr int kThreads = (BM * BN) / (TM * TN);
static_assert(BM * BK / 4 == kThreads && BK * BN / 4 == kThreads, "one float4 per thread per load");
__shared__ __align__(16) float As[BK * BM]; // 转置存放:As[k][m];float4 访问要求 16 字节对齐
__shared__ __align__(16) float Bs[BK * BN];
const int threadCol = threadIdx.x % (BN / TN), threadRow = threadIdx.x / (BN / TN);
const int innerRowA = threadIdx.x / (BK / 4), innerColA = threadIdx.x % (BK / 4);
const int innerRowB = threadIdx.x / (BN / 4), innerColB = threadIdx.x % (BN / 4);
A += blockIdx.y * BM * K;
B += blockIdx.x * BN;
C += blockIdx.y * BM * N + blockIdx.x * BN;
float acc[TM][TN] = {{0.f}};
float regM[TM], regN[TN];
for (int k0 = 0; k0 < K; k0 += BK) {
const float4 a4 = reinterpret_cast<const float4*>(&A[innerRowA * K + innerColA * 4])[0];
As[(innerColA * 4 + 0) * BM + innerRowA] = a4.x;
As[(innerColA * 4 + 1) * BM + innerRowA] = a4.y;
As[(innerColA * 4 + 2) * BM + innerRowA] = a4.z;
As[(innerColA * 4 + 3) * BM + innerRowA] = a4.w;
reinterpret_cast<float4*>(&Bs[innerRowB * BN + innerColB * 4])[0] =
reinterpret_cast<const float4*>(&B[innerRowB * N + innerColB * 4])[0];
__syncthreads();
A += BK;
B += BK * N;
#pragma unroll
for (int dot = 0; dot < BK; ++dot) {
#pragma unroll
for (int i = 0; i < TM; i += 4)
*reinterpret_cast<float4*>(®M[i]) = *reinterpret_cast<const float4*>(&As[dot * BM + threadRow * TM + i]);
#pragma unroll
for (int i = 0; i < TN; i += 4)
*reinterpret_cast<float4*>(®N[i]) = *reinterpret_cast<const float4*>(&Bs[dot * BN + threadCol * TN + i]);
#pragma unroll
for (int m = 0; m < TM; ++m)
#pragma unroll
for (int n = 0; n < TN; ++n) acc[m][n] += regM[m] * regN[n];
}
__syncthreads();
}
#pragma unroll
for (int m = 0; m < TM; ++m)
#pragma unroll
for (int n = 0; n < TN; n += 4) {
float4* cp = reinterpret_cast<float4*>(&C[(threadRow * TM + m) * N + threadCol * TN + n]);
float4 c = *cp;
c.x = alpha * acc[m][n + 0] + beta * c.x;
c.y = alpha * acc[m][n + 1] + beta * c.y;
c.z = alpha * acc[m][n + 2] + beta * c.z;
c.w = alpha * acc[m][n + 3] + beta * c.w;
*cp = c;
}
}
// ---------------- 启动封装 ----------------
using Launcher = void (*)(int, int, int, float, const float*, const float*, float, float*);
void launch_v0(int M, int N, int K, float a, const float* A, const float* B, float b, float* C) {
dim3 block(32, 32), grid(M / 32, N / 32);
sgemm_v0<<<grid, block>>>(M, N, K, a, A, B, b, C);
}
void launch_v1(int M, int N, int K, float a, const float* A, const float* B, float b, float* C) {
dim3 block(32, 32), grid(N / 32, M / 32);
sgemm_v1<<<grid, block>>>(M, N, K, a, A, B, b, C);
}
void launch_v2(int M, int N, int K, float a, const float* A, const float* B, float b, float* C) {
dim3 block(32, 32), grid(N / 32, M / 32);
sgemm_v2<32><<<grid, block>>>(M, N, K, a, A, B, b, C);
}
void launch_v3(int M, int N, int K, float a, const float* A, const float* B, float b, float* C) {
constexpr int BM = 64, BN = 64, BK = 8, TM = 8;
dim3 grid(N / BN, M / BM);
sgemm_v3<BM, BN, BK, TM><<<grid, (BM * BN) / TM>>>(M, N, K, a, A, B, b, C);
}
void launch_v4(int M, int N, int K, float a, const float* A, const float* B, float b, float* C) {
constexpr int BM = 128, BN = 128, BK = 8, TM = 8, TN = 8;
dim3 grid(N / BN, M / BM);
sgemm_v4<BM, BN, BK, TM, TN><<<grid, (BM * BN) / (TM * TN)>>>(M, N, K, a, A, B, b, C);
}
void launch_v5(int M, int N, int K, float a, const float* A, const float* B, float b, float* C) {
constexpr int BM = 128, BN = 128, BK = 8, TM = 8, TN = 8;
dim3 grid(N / BN, M / BM);
sgemm_v5<BM, BN, BK, TM, TN><<<grid, (BM * BN) / (TM * TN)>>>(M, N, K, a, A, B, b, C);
}
// CPU 参考实现:i-k-j 循环顺序,对缓存友好
void gemm_cpu(int M, int N, int K, float alpha, const float* A, const float* B, float beta, float* C) {
std::vector<float> acc(N);
for (int i = 0; i < M; ++i) {
std::fill(acc.begin(), acc.end(), 0.f);
for (int k = 0; k < K; ++k) {
const float a = A[i * K + k];
const float* b = B + k * N;
for (int j = 0; j < N; ++j) acc[j] += a * b[j];
}
for (int j = 0; j < N; ++j) C[i * N + j] = alpha * acc[j] + beta * C[i * N + j];
}
}
int main(int argc, char** argv) {
const int check_n = 512; // 正确性检查用小矩阵(CPU 算得快)
const int bench_n = argc > 1 ? std::atoi(argv[1]) : 4096;
const float alpha = 1.f, beta = 0.5f;
struct { const char* name; Launcher fn; } versions[] = {
{"v0 naive (x->row)", launch_v0}, {"v1 coalesced (x->col)", launch_v1},
{"v2 smem tiling", launch_v2}, {"v3 1D register tiling", launch_v3},
{"v4 2D register tiling", launch_v4}, {"v5 vectorized", launch_v5},
};
// ---- 正确性 ----
{
const int n = check_n;
std::vector<float> hA(n * n), hB(n * n), hC(n * n), ref(n * n), got(n * n);
fill_random(hA, 1);
fill_random(hB, 2);
fill_random(hC, 3);
ref = hC;
gemm_cpu(n, n, n, alpha, hA.data(), hB.data(), beta, ref.data());
float *A, *B, *C;
CUDA_CHECK(cudaMalloc(&A, n * n * sizeof(float)));
CUDA_CHECK(cudaMalloc(&B, n * n * sizeof(float)));
CUDA_CHECK(cudaMalloc(&C, n * n * sizeof(float)));
CUDA_CHECK(cudaMemcpy(A, hA.data(), n * n * sizeof(float), cudaMemcpyHostToDevice));
CUDA_CHECK(cudaMemcpy(B, hB.data(), n * n * sizeof(float), cudaMemcpyHostToDevice));
bool ok = true;
for (auto& v : versions) {
CUDA_CHECK(cudaMemcpy(C, hC.data(), n * n * sizeof(float), cudaMemcpyHostToDevice));
v.fn(n, n, n, alpha, A, B, beta, C);
CUDA_CHECK_LAST();
CUDA_CHECK(cudaMemcpy(got.data(), C, n * n * sizeof(float), cudaMemcpyDeviceToHost));
std::printf("%-24s ", v.name);
ok &= check_close(got.data(), ref.data(), n * n, 1e-4f, 1e-4f);
}
CUDA_CHECK(cudaFree(A));
CUDA_CHECK(cudaFree(B));
CUDA_CHECK(cudaFree(C));
if (!ok) return 1;
}
// ---- 性能 ----
const int n = bench_n;
const size_t elems = static_cast<size_t>(n) * n;
std::vector<float> h(elems);
float *A, *B, *C;
CUDA_CHECK(cudaMalloc(&A, elems * sizeof(float)));
CUDA_CHECK(cudaMalloc(&B, elems * sizeof(float)));
CUDA_CHECK(cudaMalloc(&C, elems * sizeof(float)));
fill_random(h, 4);
CUDA_CHECK(cudaMemcpy(A, h.data(), elems * sizeof(float), cudaMemcpyHostToDevice));
CUDA_CHECK(cudaMemcpy(B, h.data(), elems * sizeof(float), cudaMemcpyHostToDevice));
CUDA_CHECK(cudaMemset(C, 0, elems * sizeof(float)));
const double flops = 2.0 * n * n * n;
std::printf("\nM = N = K = %d\n%-24s %10s %10s\n", n, "version", "time(ms)", "TFLOPS");
#ifdef WITH_CUBLAS
cublasHandle_t handle;
cublasCreate(&handle);
// cuBLAS 是列主序:行主序的 C = A B 等价于列主序的 C^T = B^T A^T
float ms_cublas = time_ms([&] {
cublasSgemm(handle, CUBLAS_OP_N, CUBLAS_OP_N, n, n, n, &alpha, B, n, A, n, &beta, C, n);
}, 10, 2);
std::printf("%-24s %10.3f %10.2f\n", "cuBLAS", ms_cublas, tflops(flops, ms_cublas));
cublasDestroy(handle);
#endif
for (auto& v : versions) {
const int iters = (v.fn == launch_v0) ? 1 : 10; // v0 太慢,只跑一次
float ms = time_ms([&] { v.fn(n, n, n, alpha, A, B, beta, C); }, iters, 1);
std::printf("%-24s %10.3f %10.2f\n", v.name, ms, tflops(flops, ms));
}
CUDA_CHECK(cudaFree(A));
CUDA_CHECK(cudaFree(B));
CUDA_CHECK(cudaFree(C));
return 0;
}
把结果记录下来。按公开资料中的经验(例如 Simon Boehm 的博客 How to Optimize a CUDA Matmul Kernel for cuBLAS-like Performance,在 A6000 上从朴素版本一路优化到 cuBLAS 的九成以上),你应该能看到这样的趋势:v0 → v1 提升数倍,v2 再提升约一倍,v4 相对 v2 提升数倍,v5 进一步接近 cuBLAS 的七到八成。具体比例因 GPU 而异,以你的实测为准。
| 版本 | 核心改动 | 耗时 | TFLOPS | 占 cuBLAS |
|---|---|---|---|---|
| cuBLAS | 基准 | 100% | ||
| v0 | 朴素 | |||
| v1 | 合并访问 | |||
| v2 | 共享内存分块 | |||
| v3 | 一维寄存器分块 | |||
| v4 | 二维寄存器分块 | |||
| v5 | 向量化 |
接下来的优化方向
到 v5 为止,还有几个经典的优化没有做,它们是逼近 cuBLAS 最后那段距离的关键:
warp 级分块(warp tiling)。在 block 分块和线程分块之间再加一层:每个 warp 负责 block 内的一个子块(比如 64×32)。这样做让同一个 warp 的线程访问的共享内存区域更集中,减少 bank 冲突,并为改用 Tensor Core 做好准备(Tensor Core 的 mma 指令就是以 warp 为单位的)。CUTLASS 的分层结构就是 block tile → warp tile → thread tile / mma 指令。
双缓冲(double buffering)/ 多级流水。v5 的每一轮循环里,"加载下一块"和"计算当前块"是串行的:加载时计算单元闲着,计算时访存单元闲着。双缓冲分配两份共享内存,计算第 i 块的同时预取第 i+1 块,把访存延迟藏在计算后面。在 Ampere 及以后,用 cp.async 可以直接从全局内存异步拷贝到共享内存,不经过寄存器,实现 3-4 级流水,见异步拷贝。
消除共享内存的 bank 冲突。v5 中把 A 转置写入共享内存时存在少量冲突,可以用填充或 swizzle 消除。
参数自动调优(autotuning)。BM、BN、BK、TM、TN 的最佳取值与 GPU 型号、矩阵形状都有关。实际的库会针对不同形状选择不同的配置。对于 M 很小(比如大模型 decode 时 batch 很小)的情况,还需要 split-K 等策略来填满 GPU。
使用 Tensor Core。FP32 CUDA Core 的上限在 A100 上是 19.5 TFLOPS,而 BF16 Tensor Core 是 312 TFLOPS,差了 16 倍。实际的深度学习 GEMM 都在 Tensor Core 上,见 Tensor Core。另外 A100 及以后的 GPU 支持 TF32:输入仍是 FP32,Tensor Core 内部用 10 位尾数计算,PyTorch 里用 torch.backends.cuda.matmul.allow_tf32 = True 开启。
怎么讲清楚
"手写一个矩阵乘法并优化"是最高频的题目之一。建议的节奏:
- 写出 v1(注意
threadIdx.x对应列),算出它的算术强度,指出它受限于访存; - 写出 v2 的共享内存分块(重点写对两个
__syncthreads()的位置并解释原因),说明访存量降低到 1/TILE; - 口头讲清楚寄存器分块的思想和"周长与面积"的比喻,能写出 v4 的内层循环最好;
- 继续列举双缓冲、warp 分块、向量化、Tensor Core、CUTLASS,说明各自解决什么问题;
- 最后给出你自己优化过的实测数据,比如"4096 的 SGEMM,我的实现在 A100 上达到 cuBLAS 的 X%"。
怎么讲清楚
GEMM 优化是最常见的"讲一讲你怎么优化"的例子:4096³ 的 FP32 GEMM 有约 137 GFLOP,最少只读写约 200 MB,理论上是计算瓶颈,主线是逐级提高数据复用。朴素实现先让 threadIdx.x 对应内存连续的维度;共享内存分块把全局访存降低到 1/分块大小;二维寄存器分块(每个线程算 8×8 个输出)是收益最大的一步,瓶颈从访存转到计算;之后是向量化、双缓冲 / cp.async 流水、warp 分块、消除 bank 冲突和调参。最后提 Tensor Core:思路相同,最内层换成矩阵指令。
练习
1. 计算题。 v2(TILE=32)和 v4(BM=BN=128、TM=TN=8)中,每做一次乘加,平均要读多少次共享内存?每个 block 从全局内存加载的数据总量分别是多少(以 M=N=K=4096 为例)?
参考答案
- 共享内存读取:v2 每次乘加读
As和Bs各一次,共 2 次。v4 每个dot步骤读 8 + 8 = 16 次,做 64 次乘加,平均 0.25 次。 - 全局内存加载:v2 的 block 负责 32×32 的 C 块,需要 A 的 32 行(32×4096)和 B 的 32 列(4096×32),共 2 × 32 × 4096 × 4 B = 1 MB;总共 (4096/32)² = 16384 个 block,总加载量 16 GB。v4 的 block 负责 128×128,加载 2 × 128 × 4096 × 4 B = 4 MB,共 1024 个 block,总加载量 4 GB。块边长扩大 4 倍,全局访存总量降到 1/4。(实际上很多加载会命中 L2,显存流量会更少。)
2. 支持任意尺寸。 给 v2 加上边界处理,使它能正确计算 M=1000、N=999、K=777 的 GEMM。
参考思路
加载时越界的位置填 0:As[ty][tx] = (row < M && k0 + tx < K) ? A[row * K + k0 + tx] : 0.f;,Bs 同理检查 k0 + ty < K && col < N。计算部分不需要改动,因为填充的 0 不影响结果。写回时检查 row < M && col < N。注意越界的线程不能提前 return,它们仍然要参与加载和 __syncthreads()。v4、v5 的边界处理更复杂,实际的库通常把"整块"和"边缘块"分成不同的代码路径,或者对输入做填充。
3. 实现双缓冲。 在 v4 的基础上,分配两份 As、Bs,在计算当前块之前先发出下一块的全局内存读取(读到寄存器),计算完再写入另一份共享内存。对比性能变化。
参考思路
结构如下(伪代码):
load_tile_to_regs(0);  store_regs_to_smem(buf = 0);  __syncthreads();
for (int t = 0; t < numTiles; ++t) {
  if (t + 1 < numTiles) load_tile_to_regs(t + 1);   // 发出全局读取,不等待结果
  compute_from_smem(buf);                            // 与上面的读取重叠
  if (t + 1 < numTiles) store_regs_to_smem(buf ^ 1);
  __syncthreads();
  buf ^= 1;
}
因为读写的是两份不同的缓冲,每轮只需要一次 __syncthreads()。代价是寄存器和共享内存用量增加,占用率可能下降,需要实测权衡。在 sm_80 以上用 cp.async 实现会更简洁、也更快。
小结
- GEMM 在理论上是计算瓶颈,优化主线是逐级提高数据复用:共享内存分块 → 寄存器分块。
-
threadIdx.x对应内存连续的维度;共享内存分块循环里的两个__syncthreads()缺一不可。 - 分块越大越接近正方形,访存/计算比越低;二维寄存器分块是收益最大的一步。
- 继续优化:向量化、双缓冲 / cp.async 流水、warp 分块、消除 bank 冲突、调参。
- 深度学习的 GEMM 在 Tensor Core 上,思路相同,最内层换成矩阵指令。
本章练习题(3 道)
在浏览器里直接写代码、跑测试;也可以在本地用 python practice/judge.py 判题。
- 79. 估算:分块 GEMM 的全局访存量与共享内存预算(中等)
- 80. 估算:GEMM 的波次量化与 tile 选择(中等)
- 81. 共享内存分块 GEMM(困难,另有 CUDA C++ 版本)
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题