Tensor Core
Tensor Core 是专门做小矩阵乘加的硬件单元,吞吐量是普通 CUDA Core 的十几倍,现代大模型的训练和推理几乎全部运行在它上面。这一章讲它的工作方式、几种编程接口(WMMA、mma.sync、wgmma),以及数据布局和精度方面必须知道的事。
自测:能答上来就可以跳过本章
- Tensor Core 一条指令完成什么运算?以什么粒度(线程、warp、block)发出?
- A100 上 FP32 CUDA Core 和 BF16 Tensor Core 的峰值算力分别是多少?
- WMMA 的 fragment 里的数据在各线程之间是怎么分布的?程序员需要关心吗?
mma.sync.m16n8k16的 A、B、C 分别是多大?- FP16 和 BF16 有什么区别?为什么累加器通常用 FP32?
自测参考答案(先自己答,再展开对照)
- 一个小矩阵乘加 \(D = A \times B + C\)(例如 16×8×16),由一个 warp 协作发出(Hopper 的 wgmma 由 4 个 warp 组成的 warpgroup 发出),数据分布在各线程的寄存器里。
- FP32 CUDA Core 约 19.5 TFLOPS;BF16 Tensor Core(稠密)312 TFLOPS,高出一个数量级。
- 分布是由实现决定、不公开的:每个线程持有 fragment 的哪些元素没有规定,程序员只能整体加载、计算、存储,不应该依赖具体的布局(要逐元素处理时用 mma.sync 的明确布局)。
- A 是 16×16、B 是 16×8、C 和 D 是 16×8(m16n8k16)。
- FP16 有 5 位指数、10 位尾数,BF16 有 8 位指数、7 位尾数(范围和 FP32 相同,不容易溢出)。累加器用 FP32,是因为几千项的长累加在低精度下误差会迅速增大。
先看一个六格小剧场,再读正文:
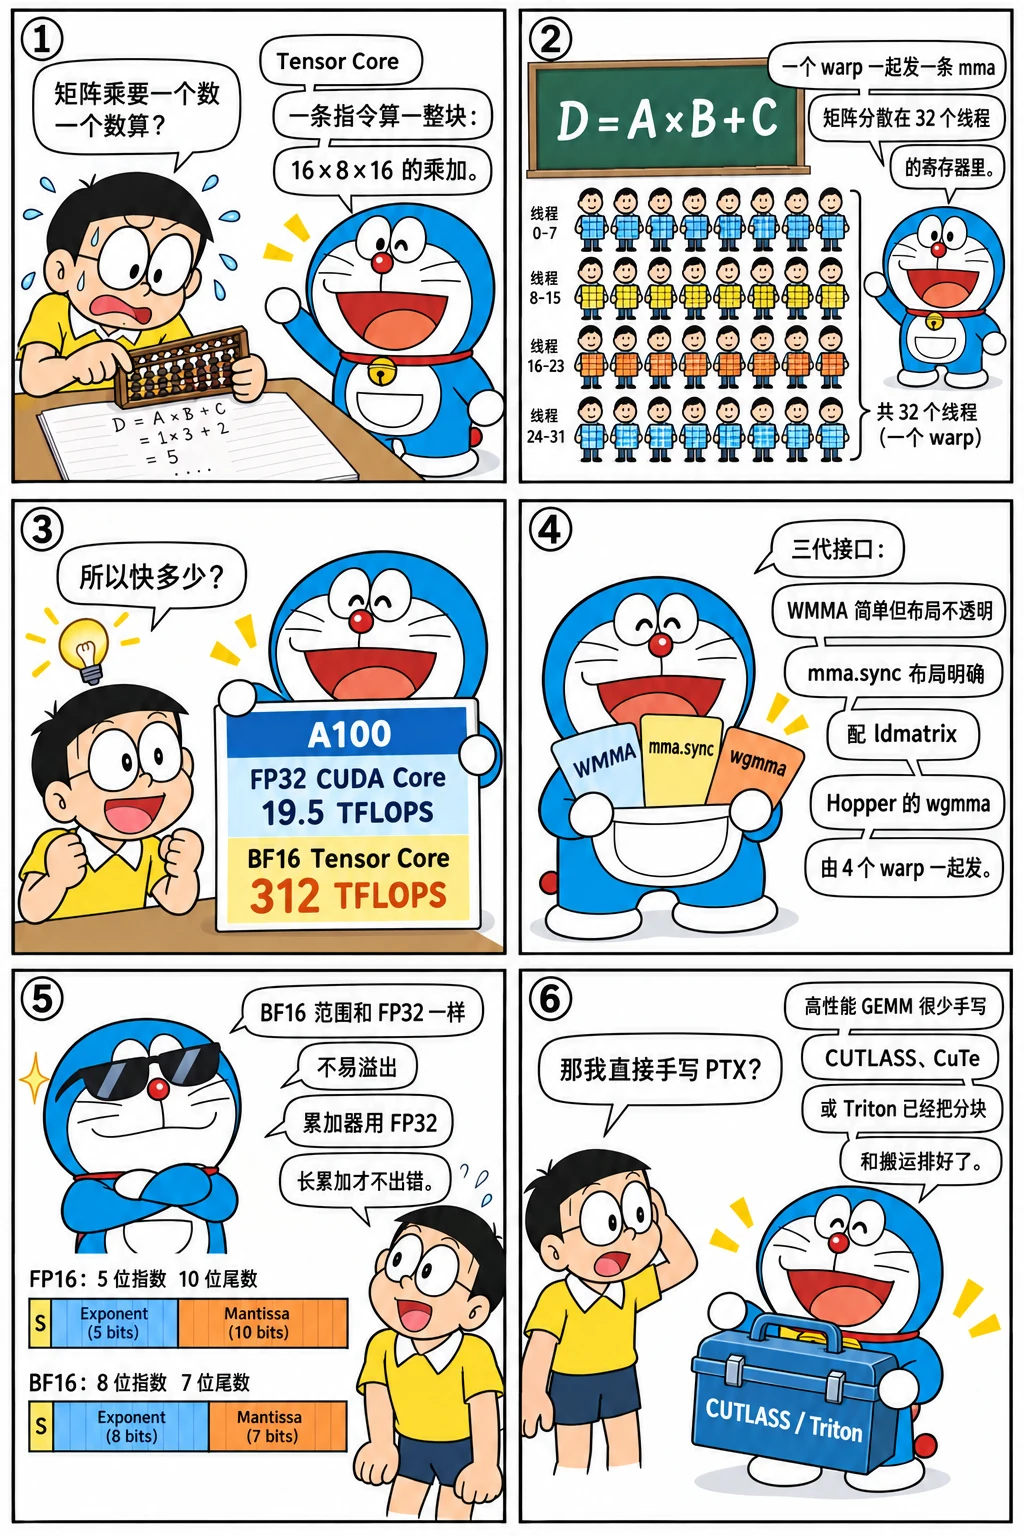
Tensor Core 做什么
Tensor Core 执行的是 D = A × B + C,其中 A、B、C、D 是小矩阵(比如 16×16)。与 CUDA Core 每条指令做一次标量乘加不同,一条 Tensor Core 指令由整个 warp 协作发出,一次完成一个小矩阵乘法,数据分散在 warp 内 32 个线程的寄存器里。
算力对比(NVIDIA 官方规格,稠密):
| GPU | FP32 CUDA Core | TF32 Tensor | BF16/FP16 Tensor | FP8 Tensor |
|---|---|---|---|---|
| A100 | 19.5 TFLOPS | 156 TFLOPS | 312 TFLOPS | — |
| H100 SXM | 67 TFLOPS | 495 TFLOPS | 989 TFLOPS | 1979 TFLOPS |
差距是一个数量级以上。所以任何以 GEMM 为主的计算,只要精度允许,都应该在 Tensor Core 上完成。
各代支持的数据类型:
| 架构 | 新增的 Tensor Core 类型 |
|---|---|
| Volta sm_70 | FP16 |
| Turing sm_75 | INT8、INT4 |
| Ampere sm_80 | BF16、TF32、FP64 |
| Ada sm_89 / Hopper sm_90 | FP8(E4M3、E5M2) |
| Blackwell sm_100 | FP6、FP4(含 NVFP4、MXFP4 等块缩放格式) |
精度:FP16、BF16、TF32、FP8
| 格式 | 符号/指数/尾数 | 特点 |
|---|---|---|
| FP32 | 1/8/23 | 基准 |
| TF32 | 1/8/10 | 不是存储格式,是 Tensor Core 内部计算 FP32 输入时使用的精度 |
| FP16 | 1/5/10 | 精度较好,但范围小(最大约 65504),训练时需要损失缩放 |
| BF16 | 1/8/7 | 范围与 FP32 相同,精度较低;大模型训练和推理的主流格式 |
| FP8 E4M3 | 1/4/3 | 推理和前向计算常用,需要配合缩放因子 |
| FP8 E5M2 | 1/5/2 | 范围更大,训练中的梯度常用 |
矩阵乘法要把 K 个乘积累加起来,低精度累加会随着 K 增大快速积累误差,所以累加器一般用 FP32,输入输出用低精度。Tensor Core 指令本身就支持"FP16/BF16 输入、FP32 累加"。FP8 GEMM 还需要缩放因子(按张量、按行或按块),把数值映射到 FP8 能表示的范围内,DeepSeek-V3 的 FP8 训练就使用了细粒度的分块缩放。
三代编程接口
| 接口 | 架构 | 粒度 | 特点 |
|---|---|---|---|
WMMA(nvcuda::wmma) |
sm_70+ | warp,16×16×16 等 | C++ API,简单;fragment 的布局对程序员不透明 |
| mma.sync(PTX) | sm_80+ 主流用法 | warp,m16n8k16 等 | 寄存器布局明确,配合 ldmatrix 使用,性能最好;Ampere 上高性能库的做法 |
| wgmma(PTX) | sm_90a | warpgroup(4 个 warp),m64nNk16 | 异步执行,操作数可以直接来自共享内存,Hopper 满速必须用它 |
| tcgen05(PTX) | sm_100a | 单线程发起,最多两个 SM 协作 | 结果放在专用的 Tensor Memory 中,Blackwell 专用 |
实际工作中,高性能 GEMM 很少直接手写 PTX,而是用 CUTLASS / CuTe(C++ 模板库)或 Triton,它们封装了这些指令和配套的数据搬运。但理解 WMMA 和 mma.sync 的工作方式,是读懂这些库、做定制化优化的前提。
先把高性能 GEMM 的三级分块画出来:一个 block 负责 C 的一块,沿 K 一段一段累加,block 里按 warp 再分,warp 里每条 mma 指令算一小块。拖动旋转,换几种 tile 大小看共享内存和算术强度怎么变:
WMMA:最简单的 Tensor Core 编程
WMMA 把矩阵分成 16×16 的 fragment。fragment 是一个"分布在 warp 32 个线程上"的对象,你不需要知道每个线程具体拿着哪些元素,只要整个 warp 一起调用下面几个函数:
#include <mma.h>
using namespace nvcuda;

wmma::fragment<wmma::matrix_a, 16, 16, 16, half, wmma::row_major> a;
wmma::fragment<wmma::matrix_b, 16, 16, 16, half, wmma::row_major> b;
wmma::fragment<wmma::accumulator, 16, 16, 16, float> c;

wmma::fill_fragment(c, 0.f);
wmma::load_matrix_sync(a, ptr_a, lda);     // 从内存(全局或共享)加载 16x16,lda 为行跨度
wmma::load_matrix_sync(b, ptr_b, ldb);
wmma::mma_sync(c, a, b, c);                // c = a * b + c
wmma::store_matrix_sync(ptr_c, c, ldc, wmma::mem_row_major);
要求:指针按 32 字节对齐;ldm 对 half 类型必须是 8 的倍数(16 字节)。
下面的程序实现了两个 FP16 输入、FP32 累加的 GEMM:
- v1:每个 warp 负责一个 16×16 的 C 块,直接从全局内存加载 fragment;
- v2:每个 block(4 个 warp)负责 64×64 的 C 块,先把 A、B 的块用 128 位向量化读取搬进共享内存(行末填充 8 个 half 以减少 bank 冲突),每个 warp 再从共享内存加载 fragment,负责 32×32(2×2 个 fragment)的输出。一个 A fragment 被 2 个 B fragment 复用,反之亦然。
// wmma_gemm.cu —— 用 WMMA 调用 Tensor Core:FP16 输入、FP32 累加
// 编译:nvcc -O3 -arch=sm_75 wmma_gemm.cu -o wmma_gemm
// 要求:M、N 是 64 的倍数,K 是 32 的倍数
#include "common.cuh"
#include <cuda_fp16.h>
#include <mma.h>
using namespace nvcuda;

// v1:一个 warp 算一个 16x16 的 C 块,fragment 直接从全局内存加载
__global__ void wmma_v1(int M, int N, int K, const half* __restrict__ A, const half* __restrict__ B,
                        float* __restrict__ C) {
  const int warp = threadIdx.x / 32;
  const int tile_m = blockIdx.y;                  // 第几个 16 行
  const int tile_n = blockIdx.x * 4 + warp;       // 每个 block 4 个 warp,横向排开
  wmma::fragment<wmma::matrix_a, 16, 16, 16, half, wmma::row_major> a;
  wmma::fragment<wmma::matrix_b, 16, 16, 16, half, wmma::row_major> b;
  wmma::fragment<wmma::accumulator, 16, 16, 16, float> acc;
  wmma::fill_fragment(acc, 0.f);
  for (int k = 0; k < K; k += 16) {
    wmma::load_matrix_sync(a, A + tile_m * 16 * K + k, K);
    wmma::load_matrix_sync(b, B + k * N + tile_n * 16, N);
    wmma::mma_sync(acc, a, b, acc);
  }
  wmma::store_matrix_sync(C + tile_m * 16 * N + tile_n * 16, acc, N, wmma::mem_row_major);
}

// v2:block 负责 64x64,4 个 warp 按 2x2 排列,每个 warp 负责 32x32;A、B 先进共享内存
constexpr int BM = 64, BN = 64, BK = 32, PAD = 8;
__global__ void __launch_bounds__(128) wmma_v2(int M, int N, int K, const half* __restrict__ A,
                                               const half* __restrict__ B, float* __restrict__ C) {
  __shared__ __align__(32) half As[BM][BK + PAD];
  __shared__ __align__(32) half Bs[BK][BN + PAD];
  const int tid = threadIdx.x, warp = tid / 32;
  const int warp_m = warp / 2, warp_n = warp % 2;
  const int row0 = blockIdx.y * BM, col0 = blockIdx.x * BN;

  wmma::fragment<wmma::matrix_a, 16, 16, 16, half, wmma::row_major> a[2];
  wmma::fragment<wmma::matrix_b, 16, 16, 16, half, wmma::row_major> b[2];
  wmma::fragment<wmma::accumulator, 16, 16, 16, float> acc[2][2];
#pragma unroll
  for (int i = 0; i < 2; ++i)
#pragma unroll
    for (int j = 0; j < 2; ++j) wmma::fill_fragment(acc[i][j], 0.f);

  for (int k0 = 0; k0 < K; k0 += BK) {
    // 64x32 的 A 块 = 256 个 uint4(每个 8 个 half),128 个线程每人搬 2 个
#pragma unroll
    for (int t = 0; t < 2; ++t) {
      int idx = tid + t * 128, r = idx / 4, c = (idx % 4) * 8;
      *reinterpret_cast<uint4*>(&As[r][c]) = *reinterpret_cast<const uint4*>(&A[(row0 + r) * K + k0 + c]);
    }
    // 32x64 的 B 块同样是 256 个 uint4
#pragma unroll
    for (int t = 0; t < 2; ++t) {
      int idx = tid + t * 128, r = idx / 8, c = (idx % 8) * 8;
      *reinterpret_cast<uint4*>(&Bs[r][c]) = *reinterpret_cast<const uint4*>(&B[(k0 + r) * N + col0 + c]);
    }
    __syncthreads();
#pragma unroll
    for (int kk = 0; kk < BK; kk += 16) {
#pragma unroll
      for (int i = 0; i < 2; ++i) wmma::load_matrix_sync(a[i], &As[warp_m * 32 + i * 16][kk], BK + PAD);
#pragma unroll
      for (int j = 0; j < 2; ++j) wmma::load_matrix_sync(b[j], &Bs[kk][warp_n * 32 + j * 16], BN + PAD);
#pragma unroll
      for (int i = 0; i < 2; ++i)
#pragma unroll
        for (int j = 0; j < 2; ++j) wmma::mma_sync(acc[i][j], a[i], b[j], acc[i][j]);
    }
    __syncthreads();
  }
#pragma unroll
  for (int i = 0; i < 2; ++i)
#pragma unroll
    for (int j = 0; j < 2; ++j) {
      float* dst = C + (row0 + warp_m * 32 + i * 16) * N + col0 + warp_n * 32 + j * 16;
      wmma::store_matrix_sync(dst, acc[i][j], N, wmma::mem_row_major);
    }
}

int main(int argc, char** argv) {
  require_sm(7, 0);
  const int M = argc > 1 ? std::atoi(argv[1]) : 2048, N = M, K = M;
  std::vector<float> fa(static_cast<size_t>(M) * K), fb(static_cast<size_t>(K) * N);
  fill_random(fa, 1);
  fill_random(fb, 2);
  std::vector<half> ha(fa.size()), hb(fb.size());
  for (size_t i = 0; i < fa.size(); ++i) { ha[i] = __float2half(fa[i]); fa[i] = __half2float(ha[i]); }
  for (size_t i = 0; i < fb.size(); ++i) { hb[i] = __float2half(fb[i]); fb[i] = __half2float(hb[i]); }

  // CPU 参考:只检查前 64 行,避免 CPU 计算太久
  const int check_rows = 64;
  std::vector<float> ref(static_cast<size_t>(check_rows) * N, 0.f);
  for (int i = 0; i < check_rows; ++i)
    for (int k = 0; k < K; ++k) {
      float a = fa[static_cast<size_t>(i) * K + k];
      for (int j = 0; j < N; ++j) ref[static_cast<size_t>(i) * N + j] += a * fb[static_cast<size_t>(k) * N + j];
    }

  half *dA, *dB;
  float* dC;
  CUDA_CHECK(cudaMalloc(&dA, ha.size() * sizeof(half)));
  CUDA_CHECK(cudaMalloc(&dB, hb.size() * sizeof(half)));
  CUDA_CHECK(cudaMalloc(&dC, static_cast<size_t>(M) * N * sizeof(float)));
  CUDA_CHECK(cudaMemcpy(dA, ha.data(), ha.size() * sizeof(half), cudaMemcpyHostToDevice));
  CUDA_CHECK(cudaMemcpy(dB, hb.data(), hb.size() * sizeof(half), cudaMemcpyHostToDevice));

  std::vector<float> got(static_cast<size_t>(check_rows) * N);
  const double flops = 2.0 * M * N * K;
  bool ok = true;
  auto bench = [&](const char* name, auto launch) {
    CUDA_CHECK(cudaMemset(dC, 0, static_cast<size_t>(M) * N * sizeof(float)));
    launch();
    CUDA_CHECK_LAST();
    CUDA_CHECK(cudaMemcpy(got.data(), dC, got.size() * sizeof(float), cudaMemcpyDeviceToHost));
    std::printf("%-8s ", name);
    ok &= check_close(got.data(), ref.data(), got.size(), 1e-3f, 1e-2f);
    float ms = time_ms(launch);
    std::printf("%-8s %.3f ms, %.2f TFLOPS\n", "", ms, tflops(flops, ms));
  };
  bench("wmma v1", [&] { wmma_v1<<<dim3(N / 64, M / 16), 128>>>(M, N, K, dA, dB, dC); });
  bench("wmma v2", [&] { wmma_v2<<<dim3(N / BN, M / BM), 128>>>(M, N, K, dA, dB, dC); });
  CUDA_CHECK(cudaFree(dA));
  CUDA_CHECK(cudaFree(dB));
  CUDA_CHECK(cudaFree(dC));
  return ok ? 0 : 1;
}
v2 距离 cuBLAS 还很远:它没有双缓冲流水,每个 warp 的分块偏小,共享内存布局也没有用 swizzle。这些正是 CUTLASS 在做的事情。但它已经展示了 Tensor Core GEMM 的完整层次:全局内存 → 共享内存(block 分块)→ fragment/寄存器(warp 分块)→ Tensor Core 指令。
mma.sync:寄存器布局是明确的
WMMA 的 fragment 布局不公开,因此很难和其他优化配合(比如在寄存器里直接对结果做逐元素运算、把一个 GEMM 的输出直接作为下一个 GEMM 的输入,这正是 FlashAttention 需要的)。PTX 的 mma.sync 指令则明确规定了每个线程持有哪些元素。以最常用的 mma.sync.aligned.m16n8k16.row.col.f32.f16.f16.f32 为例(A 为 16×16,B 为 16×8,C/D 为 16×8):
记 g = lane / 4(组号,0-7),t = lane % 4(组内编号,0-3):
| 操作数 | 每线程寄存器 | 元素位置 (行, 列) |
|---|---|---|
| A(16×16,FP16) | 4 个 32 位寄存器,每个装 2 个 half | a0,a1: (g, 2t), (g, 2t+1);a2,a3: (g+8, 2t), (g+8, 2t+1);a4,a5: (g, 2t+8), (g, 2t+9);a6,a7: (g+8, 2t+8), (g+8, 2t+9) |
| B(16×8,FP16) | 2 个 32 位寄存器 | b0,b1: (2t, g), (2t+1, g);b2,b3: (2t+8, g), (2t+9, g) |
| C/D(16×8,FP32) | 4 个 float | c0,c1: (g, 2t), (g, 2t+1);c2,c3: (g+8, 2t), (g+8, 2t+1) |
下面这个程序用一个 warp 计算一个 16×8 的块,按上表手动把数据装进寄存器,调用 mma.sync,再按上表写回,最后与 CPU 结果对比。它的意义在于让你亲手验证布局:
// mma_sync.cu —— 直接使用 PTX mma.sync.m16n8k16,手动按布局装载寄存器
// 编译:nvcc -O3 -arch=sm_80 mma_sync.cu -o mma_sync
#include "common.cuh"
#include <cuda_fp16.h>
#include <cstdint>

__device__ __forceinline__ uint32_t pack_half2(half lo, half hi) {
  __half2 h = __halves2half2(lo, hi);   // lo 在低 16 位,对应编号较小的元素
  return *reinterpret_cast<uint32_t*>(&h);
}

// A: 16x16 行主序,B: 16x8 行主序,D: 16x8 行主序(FP32)
__global__ void mma_16x8x16(const half* __restrict__ A, const half* __restrict__ B, float* __restrict__ D) {
  const int lane = threadIdx.x % 32, g = lane / 4, t = lane % 4;
  auto a = [&](int r, int c) { return A[r * 16 + c]; };
  auto b = [&](int r, int c) { return B[r * 8 + c]; };
  uint32_t ra[4], rb[2];
  ra[0] = pack_half2(a(g, 2 * t), a(g, 2 * t + 1));
  ra[1] = pack_half2(a(g + 8, 2 * t), a(g + 8, 2 * t + 1));
  ra[2] = pack_half2(a(g, 2 * t + 8), a(g, 2 * t + 9));
  ra[3] = pack_half2(a(g + 8, 2 * t + 8), a(g + 8, 2 * t + 9));
  rb[0] = pack_half2(b(2 * t, g), b(2 * t + 1, g));
  rb[1] = pack_half2(b(2 * t + 8, g), b(2 * t + 9, g));
  float c[4] = {0.f, 0.f, 0.f, 0.f}, d[4];
  asm volatile(
      "mma.sync.aligned.m16n8k16.row.col.f32.f16.f16.f32 "
      "{%0, %1, %2, %3}, {%4, %5, %6, %7}, {%8, %9}, {%10, %11, %12, %13};\n"
      : "=f"(d[0]), "=f"(d[1]), "=f"(d[2]), "=f"(d[3])
      : "r"(ra[0]), "r"(ra[1]), "r"(ra[2]), "r"(ra[3]), "r"(rb[0]), "r"(rb[1]),
        "f"(c[0]), "f"(c[1]), "f"(c[2]), "f"(c[3]));
  D[g * 8 + 2 * t] = d[0];
  D[g * 8 + 2 * t + 1] = d[1];
  D[(g + 8) * 8 + 2 * t] = d[2];
  D[(g + 8) * 8 + 2 * t + 1] = d[3];
}

int main() {
  require_sm(8, 0);
  std::vector<float> fa(16 * 16), fb(16 * 8), ref(16 * 8, 0.f), got(16 * 8);
  fill_random(fa, 1);
  fill_random(fb, 2);
  std::vector<half> ha(fa.size()), hb(fb.size());
  for (size_t i = 0; i < fa.size(); ++i) { ha[i] = __float2half(fa[i]); fa[i] = __half2float(ha[i]); }
  for (size_t i = 0; i < fb.size(); ++i) { hb[i] = __float2half(fb[i]); fb[i] = __half2float(hb[i]); }
  for (int i = 0; i < 16; ++i)
    for (int k = 0; k < 16; ++k)
      for (int j = 0; j < 8; ++j) ref[i * 8 + j] += fa[i * 16 + k] * fb[k * 8 + j];

  half *dA, *dB;
  float* dD;
  CUDA_CHECK(cudaMalloc(&dA, ha.size() * sizeof(half)));
  CUDA_CHECK(cudaMalloc(&dB, hb.size() * sizeof(half)));
  CUDA_CHECK(cudaMalloc(&dD, got.size() * sizeof(float)));
  CUDA_CHECK(cudaMemcpy(dA, ha.data(), ha.size() * sizeof(half), cudaMemcpyHostToDevice));
  CUDA_CHECK(cudaMemcpy(dB, hb.data(), hb.size() * sizeof(half), cudaMemcpyHostToDevice));
  mma_16x8x16<<<1, 32>>>(dA, dB, dD);
  CUDA_CHECK_LAST();
  CUDA_CHECK(cudaMemcpy(got.data(), dD, got.size() * sizeof(float), cudaMemcpyDeviceToHost));
  bool ok = check_close(got.data(), ref.data(), got.size(), 1e-3f, 1e-3f);
  CUDA_CHECK(cudaFree(dA));
  CUDA_CHECK(cudaFree(dB));
  CUDA_CHECK(cudaFree(dD));
  return ok ? 0 : 1;
}
ldmatrix:从共享内存高效装载 fragment
上面的程序从全局内存逐个 half 装载寄存器,只是为了演示。真实的 kernel 会把数据先放进共享内存,再用 ldmatrix 指令装载:一条 ldmatrix.sync.aligned.m8n8.x4.shared.b16 让 warp 从共享内存读出 4 个 8×8 的 half 矩阵,每个线程得到的元素正好符合 mma.sync 的 A 操作数布局。每个线程只需提供一行的起始地址:lane 0-7 提供第 1 个矩阵 8 行的地址,lane 8-15 提供第 2 个,依此类推。
uint32_t smem_addr = static_cast<uint32_t>(__cvta_generic_to_shared(&As[row][col]));
asm volatile("ldmatrix.sync.aligned.m8n8.x4.shared.b16 {%0, %1, %2, %3}, [%4];\n"
             : "=r"(ra[0]), "=r"(ra[1]), "=r"(ra[2]), "=r"(ra[3]) : "r"(smem_addr));
ldmatrix 每次按行读取 16 字节,8 行地址如果映射到相同的 bank 组就会冲突。这就是高性能 kernel 对共享内存做 swizzle(地址按位异或打散)的原因。.trans 修饰符可以在装载时转置,用来装载 B 操作数。
Hopper:wgmma
Hopper 引入了 warpgroup 级的异步矩阵指令 wgmma.mma_async:4 个连续的 warp(128 个线程)共同执行一个 m64nNk16 的矩阵乘(N 最大 256),A 可以来自寄存器或共享内存,B 必须来自共享内存(通过一个 64 位的"矩阵描述符"指定地址和 swizzle 模式)。它是异步的:发出后线程可以继续做别的事,之后用 wgmma.commit_group 和 wgmma.wait_group 等待完成。
配合 TMA(异步地把数据块搬进共享内存)和 warp 专门化(一部分 warp 只负责搬数据,另一部分只负责计算),Hopper 上的 GEMM 和 attention 才能跑到九成以上的峰值。直接手写 wgmma 很繁琐,实践中通过 CUTLASS 3.x / CuTe 或 ThunderKittens 等库使用。FlashAttention-3 就是基于这些特性实现的,见下一章 异步拷贝与 Hopper/Blackwell。
怎么讲清楚
讲 Tensor Core:一条矩阵指令由一个 warp(Hopper 是一个 warpgroup)发出,完成一个小矩阵乘加(如 mma.sync.m16n8k16),算力比 CUDA Core 高一个数量级(A100 BF16 312 TFLOPS 对 FP32 CUDA Core 19.5);输入低精度、FP32 累加。WMMA 简单但布局不透明,mma.sync 布局明确,配合 ldmatrix 和 swizzle 使用;层次是全局 → 共享内存 → 寄存器 fragment → 矩阵指令。Hopper 上用 wgmma + TMA + warp 专门化,实践中通过 CUTLASS / CuTe 使用。
练习
1. 计算题。 用 WMMA 的 16×16×16 fragment,一个 warp 每条 mma_sync 做多少次浮点运算?要在 A100 上跑满 312 TFLOPS,全 GPU 每秒需要执行多少条这样的 warp 级指令?
参考答案
16 × 16 × 16 次乘加 = 4096 次乘加 = 8192 次浮点运算。312e12 / 8192 ≈ 3.8e10 条/秒,平均到 108 个 SM、约 1.41 GHz 的时钟,每个 SM 每个周期约 0.25 条,即每个 SM 每 4 个周期要完成一个 16×16×16 的矩阵乘。要持续达到这个速度,数据供给(共享内存 → 寄存器)必须跟得上,这就是为什么 Tensor Core kernel 对数据搬运的优化要求极高。
2. 读布局。 根据 mma.sync m16n8k16 的布局表,lane 13 持有 C 的哪 4 个元素?
参考答案
lane 13:g = 13 / 4 = 3,t = 13 % 4 = 1。持有 c0 = (3, 2),c1 = (3, 3),c2 = (11, 2),c3 = (11, 3)。同一行的两个元素在同一个线程里连续存放,这使得写回时可以用 float2 一次写 8 字节。
3. 改进 wmma_v2。 列出至少三个能让 wmma_v2 更快的改进方向。
参考答案
- 双缓冲 / cp.async 多级流水:计算当前块时异步加载下一块,见下一章;
- 更大的 warp 分块:每个 warp 负责 64×64(4×4 个 fragment),提高 fragment 复用率;block 负责 128×128 或 128×256;
- 用 mma.sync + ldmatrix 代替 WMMA,并对共享内存做 swizzle 消除 bank 冲突;
- 结果写回优化:先把累加器写到共享内存再用向量化指令合并写出,或者直接转成 BF16 输出,减少写回的字节数;
- 在 Hopper 上改用 TMA + wgmma + warp 专门化。
小结
- Tensor Core 以 warp(Hopper 是 warpgroup)为单位执行小矩阵乘加,算力比 CUDA Core 高一个数量级。
- 低精度输入、FP32 累加;BF16 是大模型主流格式,FP8/FP4 需要缩放因子。
- WMMA 简单但布局不透明;mma.sync 布局明确,配合 ldmatrix 与 swizzle 使用。
- Tensor Core GEMM 的层次:全局 → 共享内存 → 寄存器 fragment → 矩阵指令。
- Hopper 用 wgmma + TMA + warp 专门化;实践中通过 CUTLASS/CuTe 使用。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题