内存层次与访存优化
绝大多数 kernel 的瓶颈不在计算,而在访存。这一章讲清楚全局内存的合并访问、共享内存的 bank 冲突、向量化访存、常量内存和寄存器溢出。它们是后面所有算子优化的基本功,也是面试最高频的考点。
自测:能答上来就可以跳过本章
- 一个 warp 读 32 个连续的 float,最少需要几个 32 字节的扇区(sector)?如果每个线程隔一个元素读一个呢?
- 共享内存有多少个 bank?什么情况下会发生 bank 冲突?什么情况下虽然地址相同却不会冲突?
- 为什么二维共享内存数组经常声明成
[32][33]而不是[32][32]? float4向量化读取有什么好处?有什么前提条件?- 什么是寄存器溢出?怎么发现?
自测参考答案(先自己答,再展开对照)
- 32 个连续的 float 是 128 字节,最少 4 个扇区;隔一个读一个时跨度是 256 字节,要 8 个扇区,有效数据只占一半。
- 32 个 bank,每个 bank 宽 4 字节,地址按 4 字节依次落在各个 bank 上。同一个 warp 的多个线程访问同一个 bank 的不同地址时冲突、要串行;访问同一个地址时广播,不冲突。
- 按列访问
[32][32]时,一列的 32 个元素间隔 32 个 float,全落在同一个 bank 上,32 路冲突;每行多填一个元素([32][33]),一列的元素就错开到 32 个不同的 bank。 - 一条指令读 16 字节,访存指令数减少到 1/4,每个线程的在途数据更多;前提是地址按 16 字节对齐(数组起始地址和下标都要满足),元素个数也要能被 4 整除或单独处理尾部。
- 寄存器不够用时,编译器把一部分变量放到 local memory(实际在显存里,经过 L1),访问变慢。用
-Xptxas -v看编译输出里的 spill stores / loads,或者在 Nsight Compute 里看 local memory 的流量。
先看一个六格小剧场,再读正文:
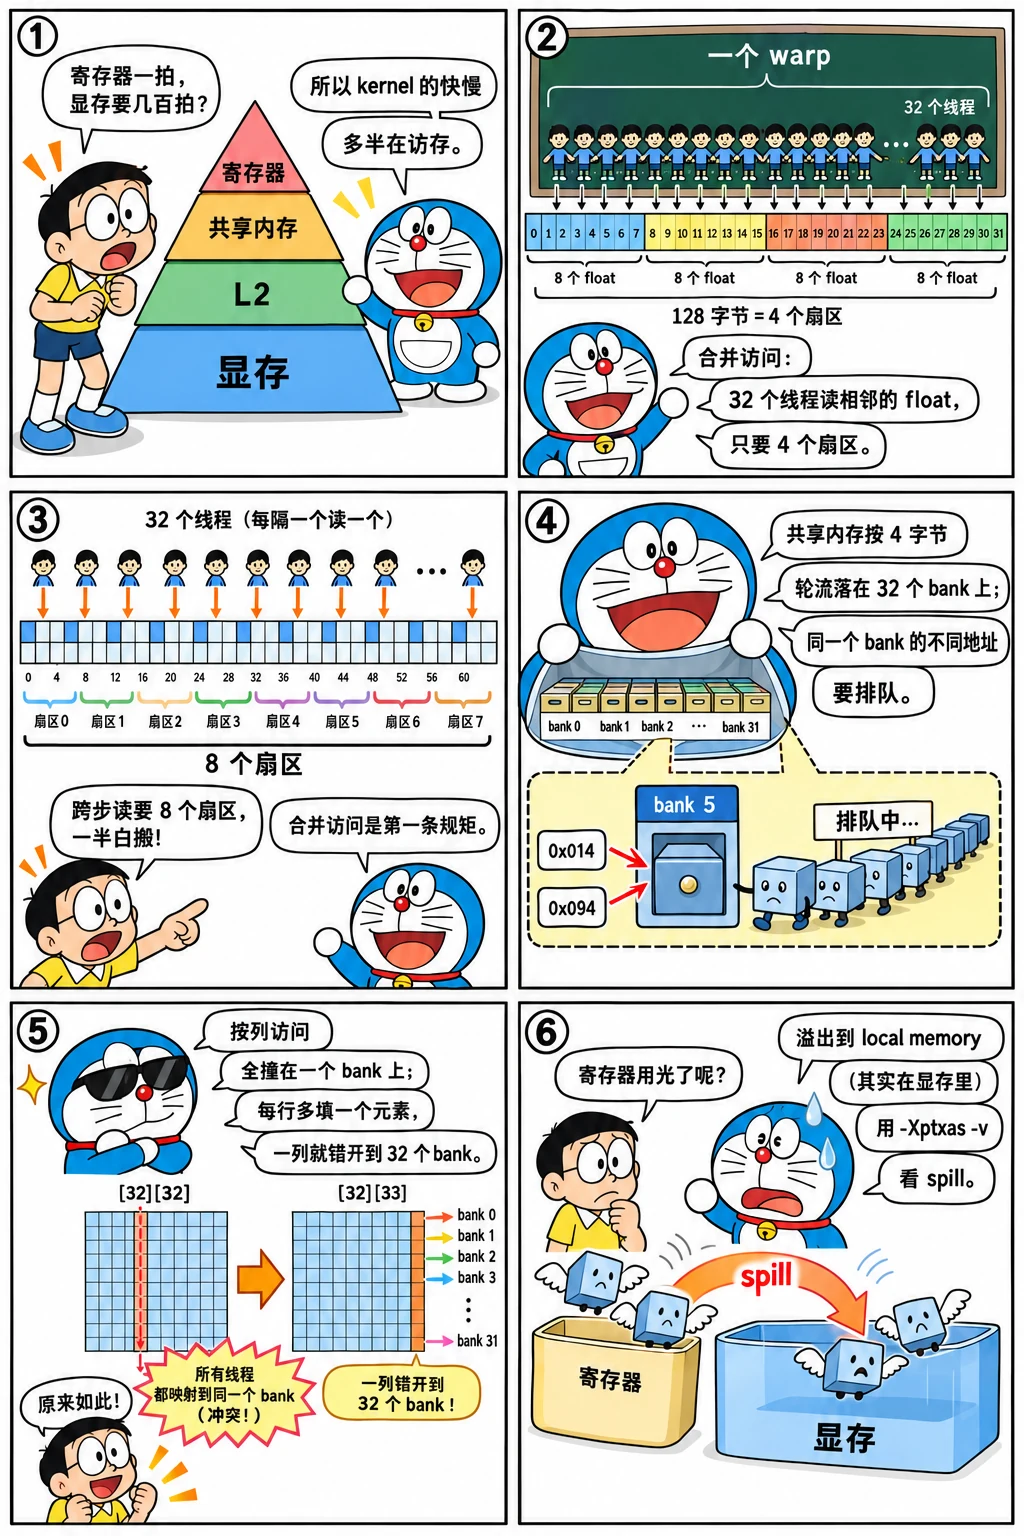
全局内存:合并访问
全局内存(显存)的访问以 32 字节的扇区(sector) 为最小单位。一个 warp 执行一条访存指令时,硬件统计这 32 个线程的地址一共落在多少个不同的扇区里,就发起多少次扇区传输。于是:
| 访问模式(每线程读一个 float) | 涉及的扇区数 | 有效数据占比 |
|---|---|---|
连续且对齐:线程 k 读 a[base + k] |
4 个(128 字节) | 100% |
| 连续但不对齐:起始地址偏移 1 个 float | 5 个 | 80% |
跨步 2:线程 k 读 a[2k] |
8 个 | 50% |
| 跨步 ≥ 8:每个线程落在不同扇区 | 32 个 | 12.5% |
| 所有线程读同一个地址 | 1 个 | 广播,一次传输 |
这就是合并访问(coalescing):让一个 warp 的线程访问连续的地址。规则很简单,但它决定了带宽能用到多少。实践中最常见的违反方式是:二维数据里让 threadIdx.x 沿着"行"方向变化,导致相邻线程访问的地址相差一整行。
换个访问模式,看这 32 个线程会让硬件搬多少字节上来:
下面这个程序测量不同跨步和偏移下的实际带宽,建议在你的 GPU 上跑一遍,亲眼看看差距:
// access_pattern.cu —— 测量跨步访问和非对齐访问对带宽的影响
// 编译:nvcc -O3 -arch=sm_75 access_pattern.cu -o access_pattern
#include "common.cuh"

__global__ void strided_copy(const float* __restrict__ in, float* __restrict__ out, int n, int stride) {
  int i = blockIdx.x * blockDim.x + threadIdx.x;
  if (i < n) out[i] = in[static_cast<size_t>(i) * stride];
}

__global__ void offset_copy(const float* __restrict__ in, float* __restrict__ out, int n, int offset) {
  int i = blockIdx.x * blockDim.x + threadIdx.x;
  if (i < n) out[i] = in[i + offset];
}

int main() {
  const int n = 1 << 22;             // 每次拷贝 4M 个有效元素
  const int max_stride = 32;
  const size_t in_elems = static_cast<size_t>(n) * max_stride + 64;
  std::vector<float> h_in(in_elems);
  for (size_t i = 0; i < in_elems; ++i) h_in[i] = static_cast<float>(i % 1000);

  float *d_in, *d_out;
  CUDA_CHECK(cudaMalloc(&d_in, in_elems * sizeof(float)));
  CUDA_CHECK(cudaMalloc(&d_out, n * sizeof(float)));
  CUDA_CHECK(cudaMemcpy(d_in, h_in.data(), in_elems * sizeof(float), cudaMemcpyHostToDevice));

  const int threads = 256, blocks = (n + threads - 1) / threads;
  std::vector<float> h_out(n), ref(n);
  bool ok = true;

  std::printf("stride  time(ms)  useful GB/s\n");
  for (int stride : {1, 2, 4, 8, 16, 32}) {
    strided_copy<<<blocks, threads>>>(d_in, d_out, n, stride);
    CUDA_CHECK_LAST();
    CUDA_CHECK(cudaMemcpy(h_out.data(), d_out, n * sizeof(float), cudaMemcpyDeviceToHost));
    for (int i = 0; i < n; ++i) ref[i] = h_in[static_cast<size_t>(i) * stride];
    ok &= check_close(h_out.data(), ref.data(), n, 0.f, 0.f);
    float ms = time_ms([&] { strided_copy<<<blocks, threads>>>(d_in, d_out, n, stride); });
    // 只统计"有用"的字节:读 n 个、写 n 个 float
    std::printf("%6d  %8.3f  %10.1f\n", stride, ms, gbps(2.0 * n * sizeof(float), ms));
  }

  std::printf("\noffset  time(ms)  GB/s\n");
  for (int offset : {0, 1, 2, 4, 8, 16, 32}) {
    float ms = time_ms([&] { offset_copy<<<blocks, threads>>>(d_in, d_out, n, offset); });
    std::printf("%6d  %8.3f  %10.1f\n", offset, ms, gbps(2.0 * n * sizeof(float), ms));
  }
  CUDA_CHECK(cudaFree(d_in));
  CUDA_CHECK(cudaFree(d_out));
  return ok ? 0 : 1;
}
你会看到:跨步从 1 增加到 8 左右,有效带宽几乎成倍下降,之后趋于平稳(每个线程已经独占一个扇区);非对齐访问的代价则小得多,因为多出来的只是一两个扇区,而且 L2 缓存能部分弥补。
SoA 与 AoS
结构体数组(AoS,struct Particle { float x, y, z, m; } p[N])让相邻线程访问的字段间隔 16 字节,读 p[i].x 时有效数据只有 25%。改成数组结构体(SoA,float x[N], y[N], z[N], m[N])后,每个字段的访问都是连续的。GPU 上优先使用 SoA 布局。
向量化访存
每个线程一次读一个 float 需要一条 32 位的访存指令;改用 float4 一次读 16 字节,指令数减少到四分之一:
__global__ void copy_vec4(const float4* __restrict__ in, float4* __restrict__ out, int n4) {
  int i = blockIdx.x * blockDim.x + threadIdx.x;
  if (i < n4) out[i] = in[i];   // 编译成 128 位的 LDG.E.128 / STG.E.128 指令
}
好处是减少了指令发射数量和地址计算,在带宽瓶颈的 kernel 里通常能多拿到几个百分点的带宽,在每个线程处理多个元素的 kernel(GEMM、归一化等)里收益更大。前提是:
- 地址必须按 16 字节对齐。
cudaMalloc返回的地址至少 256 字节对齐,但如果从中间某个偏移开始读(比如张量的切片),就不一定对齐了; - 元素数量不是 4 的倍数时,要单独处理剩下的尾部元素。
half 类型对应的是 half2(4 字节)以及 uint4/float4(16 字节,一次搬 8 个 half),写 FP16/BF16 算子时非常常用。
只读数据与 L1 缓存
标记为 const __restrict__ 的指针,编译器知道这块数据在 kernel 执行期间只读,可以使用只读数据路径(LDG 带非一致性缓存提示)。也可以显式用 __ldg(ptr) 读取。现代 GPU 上 L1 和纹理缓存已经合并,差别没有以前大,但写上 const __restrict__ 是好习惯,它还能帮助编译器做其他优化。
共享内存
共享内存是每个 SM 上的一块高速 SRAM,由同一个 block 的所有线程共享,程序员显式地读写它。它有两大用途:
- 数据复用:把全局内存里会被多次使用的数据搬进来,之后从共享内存读,比如 GEMM 的分块;
- 线程间通信:block 内的线程通过它交换数据,比如归约、转置。
两种声明方式:
// 静态大小
__global__ void k1() {
  __shared__ float tile[32][33];
}

// 动态大小:启动时通过第三个执行配置参数指定字节数
__global__ void k2() {
  extern __shared__ float buf[];
}
k2<<<grid, block, smem_bytes>>>();
每个 block 默认最多使用 48 KB 共享内存。要用更多(A100 最多 163 KB,H100 最多 227 KB),必须使用动态共享内存,并在启动前显式申请:
cudaFuncSetAttribute(k2, cudaFuncAttributeMaxDynamicSharedMemorySize, 100 * 1024);
k2<<<grid, block, 100 * 1024>>>();
共享内存和 L1 缓存是同一块物理存储。共享内存用得多,L1 就少,这个比例可以通过 cudaFuncAttributePreferredSharedMemoryCarveout 提示,一般交给驱动根据需要自动选择即可。
bank 冲突
共享内存被划分成 32 个 bank,每个 bank 宽 4 字节。地址按 4 字节的"字"依次分配给各个 bank:第 k 个字属于第 k % 32 个 bank。每个 bank 每个周期只能服务一次访问,所以:
- 一个 warp 的 32 个线程访问 32 个不同的 bank:一次完成,最理想;
- 多个线程访问同一个 bank 的不同地址:这些访问被串行化,叫 bank 冲突。n 个线程撞在同一个 bank 上就是 n 路冲突,耗时变成 n 倍;
- 多个线程访问同一个地址:广播,不算冲突。
最经典的冲突场景是按列访问二维数组:
第 k 行第 0 列的字编号是 32k,所有线程都落在第 0 个 bank,是 32 路冲突。解决办法是填充一列:
__shared__ float tile[32][33];    // 每行 33 个元素
float v = tile[threadIdx.x][0];   // 字编号 33k,对 32 取模是 k,32 个线程落在 32 个不同的 bank
换着选几种模式,看这 32 个线程分别落在哪些 bank 上:
下面的程序测量不同跨步下的共享内存访问速度:
// bank_conflict.cu —— 观察共享内存 bank 冲突的代价
// 编译:nvcc -O3 -arch=sm_75 bank_conflict.cu -o bank_conflict
#include "common.cuh"

constexpr int kWords = 32 * 33;

// 每个线程反复读取 s[lane * STRIDE]
template <int STRIDE>
__global__ void smem_stride(float* out, int iters) {
  __shared__ float s[kWords];
  for (int i = threadIdx.x; i < kWords; i += blockDim.x) s[i] = static_cast<float>(i);
  __syncthreads();

  volatile float* vs = s;  // volatile:强制每次循环都真的去读共享内存
  const int idx = (threadIdx.x % 32) * STRIDE;
  float acc = 0.f;
  for (int k = 0; k < iters; ++k) acc += vs[idx];
  out[blockIdx.x * blockDim.x + threadIdx.x] = acc;
}

template <int STRIDE>
bool run(float* d_out, int blocks, int threads, int iters) {
  smem_stride<STRIDE><<<blocks, threads>>>(d_out, iters);
  CUDA_CHECK_LAST();
  const int n = blocks * threads;
  std::vector<float> h(n), ref(n);
  CUDA_CHECK(cudaMemcpy(h.data(), d_out, n * sizeof(float), cudaMemcpyDeviceToHost));
  for (int t = 0; t < n; ++t) ref[t] = static_cast<float>(iters) * ((t % threads) % 32 * STRIDE);
  std::printf("stride %2d: ", STRIDE);
  bool ok = check_close(h.data(), ref.data(), n, 1e-6f, 0.f);
  float ms = time_ms([&] { smem_stride<STRIDE><<<blocks, threads>>>(d_out, iters); });
  std::printf("           time %.3f ms\n", ms);
  return ok;
}

int main() {
  const int blocks = sm_count() * 4, threads = 256, iters = 4096;
  float* d_out;
  CUDA_CHECK(cudaMalloc(&d_out, blocks * threads * sizeof(float)));
  bool ok = run<1>(d_out, blocks, threads, iters);   // 无冲突
  ok &= run<2>(d_out, blocks, threads, iters);       // 2 路冲突
  ok &= run<4>(d_out, blocks, threads, iters);       // 4 路冲突
  ok &= run<32>(d_out, blocks, threads, iters);      // 32 路冲突
  ok &= run<33>(d_out, blocks, threads, iters);      // 填充后无冲突
  CUDA_CHECK(cudaFree(d_out));
  return ok ? 0 : 1;
}
对 32 位的访问,跨步为 s 时冲突路数是 gcd(s, 32):跨步 2 是 2 路,跨步 32 是 32 路,跨步 33 与 32 互质,所以没有冲突。用 Nsight Compute 看指标 l1tex__data_bank_conflicts_pipe_lsu_mem_shared_op_ld.sum 可以直接数出冲突次数,见性能分析。
填充之外的办法:swizzle
填充会浪费一点共享内存,并且会破坏 16 字节对齐,和向量化访问、ldmatrix、TMA 这些要求对齐的指令冲突。高性能库(CUTLASS、FlashAttention)更常用 swizzle:把列下标和行下标做异或,比如 col ^ (row % 8),打乱数据在 bank 中的分布,不浪费空间也保持对齐。在 Tensor Core 一章会用到。
常量内存
__constant__ 变量存放在显存里,但有专门的常量缓存。它的特点是:一个 warp 的所有线程读同一个地址时是广播,一次完成;读不同地址时被串行化。所以它适合存放所有线程都要读的小参数,比如卷积核权重、多项式系数:
__constant__ float c_weights[64];
cudaMemcpyToSymbol(c_weights, h_weights, 64 * sizeof(float));   // 从主机拷贝
容量只有 64 KB。kernel 的参数本身也是通过常量内存传递的,所以把小结构体按值传给 kernel 也是一种高效的做法。
寄存器与本地内存
每个线程的局部变量优先放在寄存器里。以下情况会放进本地内存(物理上在显存,只是每个线程私有,经过 L1/L2 缓存):
- 寄存器不够用,编译器把一部分变量溢出(spill)到本地内存;
- 局部数组用运行时才知道的下标访问(寄存器不能按下标寻址);
- 很大的局部数组或结构体。
用 -Xptxas -v 编译可以看到每个 kernel 的寄存器用量和溢出字节数:
出现 spill 时,常见的处理办法:减少每个线程同时持有的数据量;用 #pragma unroll 展开循环,让局部数组的下标变成编译期常量;或者用 __launch_bounds__(maxThreads, minBlocks) 告诉编译器目标配置,让它在寄存器分配上做权衡(注意这可能反过来导致更多溢出)。
主机与设备之间的传输
CPU 与 GPU 之间通过 PCIe 传数据,PCIe 4.0 x16 的理论带宽是每方向约 32 GB/s,实际通常能到 20-25 GB/s,比显存带宽低两个数量级。所以:
- 尽量减少主机和设备之间的数据拷贝,让数据一直留在 GPU 上,连续多个 kernel 接力处理;
- 大块传输比很多次小传输效率高;
- 用锁页内存(
cudaMallocHost)作为主机端缓冲区,传输更快,而且是异步传输的前提,见流与并发。
怎么讲清楚
讲访存优化的顺序:全局内存按 32 字节扇区传输,同一个 warp 读 32 个连续的 float 只要 4 个扇区,隔一个读就翻倍——所以要合并访问、优先 SoA 布局;对齐时用 float4 减少访存指令;共享内存有 32 个 bank,同一 bank 的不同地址会冲突、同一地址是广播,二维数组声明成 [32][33] 就是用填充消除冲突(或者用 swizzle);寄存器溢出用 -Xptxas -v 查;主机与设备之间的拷贝要少做、做大块、用锁页内存。
练习
1. 数扇区。 一个 warp 执行 float v = a[threadIdx.x * 3];(a 按 128 字节对齐,threadIdx.x 为 0 到 31),会访问多少个 32 字节扇区?有效数据占比是多少?
参考答案
线程 k 访问字节偏移 12k,范围是 0 到 372。每个扇区 32 字节,覆盖的扇区编号是 floor(12k / 32),从 0 到 11,共 12 个扇区,传输 384 字节,有用的只有 128 字节,占比 33%。
2. 找出 bank 冲突。 下面的代码中,一个 warp 的访问有几路 bank 冲突?怎么修改?
参考答案
double 占 8 字节,即 2 个字。对于 64 位的访问,硬件把一个 warp 的请求分成两个阶段,每个阶段处理 16 个线程,32 个 bank 正好容纳 16 个 double,所以无冲突时需要 2 次传输。
这里线程 k 访问第 4k 和 4k+1 个字。同一阶段的 16 个线程里,线程 k 和 k+8 落在相同的 bank(4k % 32 与 4(k+8) % 32 相同)却访问不同地址,是 2 路冲突,总共需要 4 次传输,是理想情况的 2 倍。
改成 s[threadIdx.x] 后,每个阶段的 16 个线程访问连续的 32 个字,正好覆盖 32 个 bank,没有冲突。所以最直接的修改是让相邻线程访问相邻的 double;如果算法必须跨步访问,可以做填充或者 swizzle。
3. 一维卷积。 实现 y[i] = Σ_{k=-R}^{R} w[k+R] * x[i+k](越界的 x 视为 0),R = 8。要求:权重放在常量内存;每个 block 先把自己需要的输入(包括两侧各 R 个"光环"元素)加载进共享内存,再计算。
参考答案
// conv1d.cu —— 常量内存存权重 + 共享内存缓存带光环的输入块
// 编译:nvcc -O3 -arch=sm_75 conv1d.cu -o conv1d
#include "common.cuh"

constexpr int R = 8;
constexpr int BLOCK = 256;
__constant__ float c_w[2 * R + 1];

__global__ void conv1d(const float* __restrict__ x, float* __restrict__ y, int n) {
  __shared__ float tile[BLOCK + 2 * R];
  const int base = blockIdx.x * BLOCK;
  // 协作加载:BLOCK + 2R 个元素,每个线程可能加载多个
  for (int j = threadIdx.x; j < BLOCK + 2 * R; j += blockDim.x) {
    int g = base + j - R;
    tile[j] = (g >= 0 && g < n) ? x[g] : 0.f;
  }
  __syncthreads();

  int i = base + threadIdx.x;
  if (i < n) {
    float acc = 0.f;
#pragma unroll
    for (int k = 0; k <= 2 * R; ++k) acc += c_w[k] * tile[threadIdx.x + k];
    y[i] = acc;
  }
}

int main() {
  const int n = (1 << 22) + 123;
  std::vector<float> hx(n), hw(2 * R + 1), hy(n), ref(n);
  fill_random(hx, 1);
  fill_random(hw, 2);
  for (int i = 0; i < n; ++i) {
    float acc = 0.f;
    for (int k = -R; k <= R; ++k)
      if (i + k >= 0 && i + k < n) acc += hw[k + R] * hx[i + k];
    ref[i] = acc;
  }

  float *dx, *dy;
  CUDA_CHECK(cudaMalloc(&dx, n * sizeof(float)));
  CUDA_CHECK(cudaMalloc(&dy, n * sizeof(float)));
  CUDA_CHECK(cudaMemcpy(dx, hx.data(), n * sizeof(float), cudaMemcpyHostToDevice));
  CUDA_CHECK(cudaMemcpyToSymbol(c_w, hw.data(), hw.size() * sizeof(float)));

  const int blocks = (n + BLOCK - 1) / BLOCK;
  conv1d<<<blocks, BLOCK>>>(dx, dy, n);
  CUDA_CHECK_LAST();
  CUDA_CHECK(cudaMemcpy(hy.data(), dy, n * sizeof(float), cudaMemcpyDeviceToHost));
  bool ok = check_close(hy.data(), ref.data(), n, 1e-4f, 1e-5f);

  float ms = time_ms([&] { conv1d<<<blocks, BLOCK>>>(dx, dy, n); });
  std::printf("conv1d: %.3f ms, %.1f GB/s\n", ms, gbps(2.0 * n * sizeof(float), ms));
  CUDA_CHECK(cudaFree(dx));
  CUDA_CHECK(cudaFree(dy));
  return ok ? 0 : 1;
}
每个输入元素被 2R+1 个输出使用。放进共享内存后,每个元素只从显存读一次(加上少量光环)。权重在同一时刻被 warp 内所有线程读取同一个地址,正好符合常量内存的广播特性。
小结
- 全局内存按 32 字节扇区传输;让同一 warp 访问连续地址(合并访问),优先使用 SoA 布局。
- 对齐前提下用
float4等向量类型减少访存指令。 - 共享内存有 32 个 bank;同 bank 不同地址会冲突,同地址广播;用填充或 swizzle 消除冲突。
- 常量内存适合 warp 内统一读取的小数据。
- 用
-Xptxas -v检查寄存器用量和溢出。 - 主机与设备间的传输很慢,尽量少做、做大块、用锁页内存。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题