CuTe 的布局代数
写 GEMM、FlashAttention 这类 kernel,最容易出错的往往不是算法,而是下标:这个 block 搬哪一块,这个线程拿哪几个元素,共享内存怎么排才没有 bank 冲突,Tensor Core 的每个寄存器装的是矩阵的哪个位置。CUTLASS 3.x 起的 CuTe 把这些问题统一成一个数学对象——布局(Layout),再给出一套组合布局的运算。这一章先用不到两百行 Python 把每个运算实现一遍(算法与 CUTLASS 自带的 pycute 一致),再编译运行 CUTLASS 里真正的 CuTe 逐行对照,最后用它算出线程划分的访存效率,以及 mma.sync 的寄存器布局。
自测:能答上来就可以跳过本章
- 布局
(4,(2,4)):(2,(1,8))把坐标 (1, 5) 映射到哪个下标?一维坐标 5 呢? coalesce保持什么不变?为什么(4,8):(1,4)能合并成32:1,(4,8):(8,1)却不能?- 复合 A∘B 的形状由谁决定?怎样用复合得到一个行优先矩阵的转置视图?
logical_divide(A, B)是怎样用复合和补集拼出来的?结果的两维分别表示什么?local_tile和local_partition分别切出什么?一个 warp 读一块列优先的 fp32 数据,线程布局应该沿哪个方向排?
自测参考答案(先自己答,再展开对照)
- 坐标 (1, 5):第 0 维贡献 1 × 2 = 2;第 1 维的 5 按形状 (2,4) 拆成 (1, 2),贡献 1 × 1 + 2 × 8 = 17,合计 19。一维坐标 5 先按第 0 维的长度 4 拆成 (1, 1),第 1 维的 1 再拆成 (1, 0),得到 2 + 1 = 3。
- 保持"一维坐标 → 下标"这个函数不变,只换成维数最少的写法。
(4,8):(1,4)的第 0 维走完 4 步正好到下标 4,等于第 1 维的步长,两维首尾相接,合起来就是连续的 32 个元素;(4,8):(8,1)的第 0 维走完是 32,不等于第 1 维的步长 1,接不上——它作为一维坐标的函数本来就不是 i ↦ i。 - 由 B 决定:R(c) = A(B(c)),R 的定义域就是 B 的定义域,形状和 B 相同。行优先的 4×8 矩阵
(4,8):(8,1)复合(8,4):(4,1)得到(8,4):(1,8),满足 R(i, j) = A(j, i),没有搬动任何数据。 - A ⊘ B = A ∘ (B, B*),其中 B* = complement(B, size(A)) 描述 B 没有覆盖的下标怎样排。(B, B*) 把 A 的全部一维坐标重排成两维:第 0 维是 B 选中的元素(块内),第 1 维是第几块。
- 两者都先
zipped_divide成 ((块内), (块号))。local_tile用 CTA 的坐标固定块号,得到这个 CTA 负责的整块;local_partition用线程在线程布局里的坐标固定块内那一维,得到这个线程在每一块里的那个元素。线程布局的快维应该沿内存连续的方向:列优先的数据配 (16,2) 列优先的线程布局,32 个线程一条指令读连续的 128 字节(4 个扇区,利用率 100%);每个线程拿一个 2×2 小块而又不用向量指令时,只有 50%。
先看一个六格小剧场,再读正文:
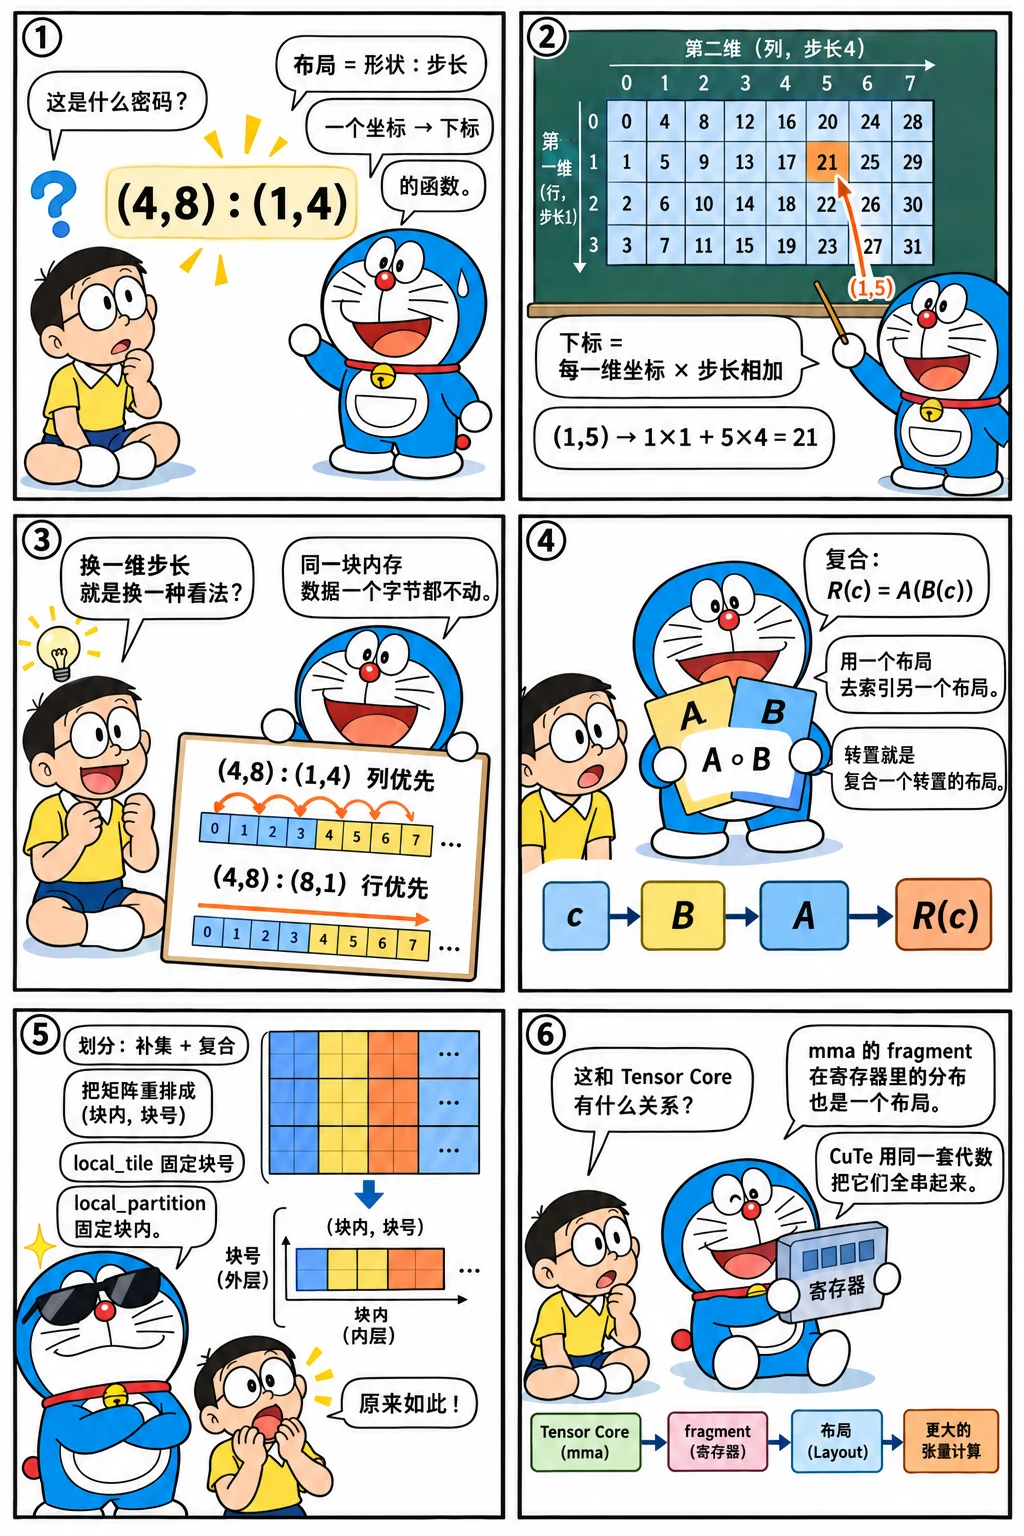
为什么需要布局代数
回顾 GEMM 优化之路:从全局内存搬一块 A 进共享内存、每个线程从共享内存取自己那 8×8 个元素、最后写回 C,每一步都有一个手写的下标公式。这些公式彼此耦合:改块大小、换数据类型、加向量化、加 swizzle,都要把一串公式重新推一遍,错一个就是静默的错误结果。
仔细看会发现,这些公式其实是同一类东西——从逻辑坐标到内存下标的函数:
- 数据怎么放:行优先、列优先、分块存放、swizzle 过的共享内存;
- 谁处理哪一块:CTA 负责 C 的哪一块,主循环沿 K 取第几块;
- 线程拿哪些元素:拷贝时每个线程搬哪几个,MMA 时每个线程的寄存器装矩阵的哪几个位置;
- 一条指令的形状:一条
cp.async搬 16 字节,一条mma.sync算 16×8×16。
CuTe 把它们都表示成布局(Layout),张量就是"指针 + 布局"。分块、按线程划分、换一种视图,都是布局之间的运算,这套运算就叫布局代数。形状和步长写成编译期常量时,这些运算在编译期完成:非法的划分直接编译报错,生成的下标计算和手写的一样精简。
生态一章已经用 CuTe 打印过几个布局。这一章把它背后的代数讲透:先用 Python 实现一遍,每个运算都能单步跟踪;最后编译运行 CUTLASS 里真正的 CuTe,确认两边的结果逐行一致。
布局:形状与步长
先拨一拨:同一个形状配不同的步长,坐标落到内存的哪里:
布局由形状(Shape)和步长(Stride)组成,写作 形状:步长。两者是结构相同的(可以嵌套的)元组,每一个位置叫一个维(mode):
(4,8):(1,4):4 × 8,第 0 维步长 1,第 1 维步长 4,就是列优先;(4,8):(8,1)是行优先;(4,(2,4)):(2,(1,8)):第 1 维本身又是一个 (2,4) 的布局,这叫层次化布局。
布局是一个函数:下标 = 坐标与步长的内积。它接受三种坐标:
- 一维坐标:0 到 size − 1 的整数,按"第 0 维变化最快"的顺序(colexicographic,和列优先的顺序一致)拆成多维坐标;
- 顶层坐标:每个顶层维给一个整数,落在嵌套维上的整数再按同样的规则拆开,比如 (1, 5);
- 完全展开的坐标:和形状的嵌套结构一一对应,比如 (1, (1, 2))。
另外几个常用的量:size 是坐标的个数(形状各维之积),cosize 是最大下标 + 1(布局用到的存储空间),rank 是顶层有几维。下面是本章的实现,第一个文件是布局本身,外加最简单的运算"合并":
"""layout_core.py —— CuTe 的布局:形状 + 步长,坐标到下标的映射,以及合并(coalesce)。

布局 = 形状(Shape): 步长(Stride),两者都可以是嵌套的元组。布局是一个函数:把坐标映射成一维下标。
一维坐标按"第 0 维变化最快"(colexicographic,和列优先一致)拆成多维坐标,这是 CuTe 的约定。
打印格式和 CuTe 的 print 相同(只是不区分编译期常量)。
"""

from math import prod


def is_tuple(x):
    return isinstance(x, tuple)


def flatten(t):
    return sum((flatten(x) for x in t), ()) if is_tuple(t) else (t,)


def size(shape):
    return prod(flatten(shape))


def unflatten(flat, like):
    """按 like 的嵌套结构把扁平的元组重新分组,返回 (结果, 剩下的元素)"""
    if not is_tuple(like):
        return flat[0], flat[1:]
    out = []
    for x in like:
        y, flat = unflatten(flat, x)
        out.append(y)
    return tuple(out), flat


def crd2idx(crd, shape, stride):
    if is_tuple(crd):                                         # 元组坐标:逐维映射再相加
        return sum(crd2idx(c, s, d) for c, s, d in zip(crd, shape, stride))
    if is_tuple(shape):                                       # 整数坐标落在多维的一维上:先拆开(第 0 维变化最快)
        idx = 0
        for s, d in zip(shape[:-1], stride[:-1]):
            idx += crd2idx(crd % size(s), s, d)
            crd //= size(s)
        return idx + crd2idx(crd, shape[-1], stride[-1])     # 最后一维不取余:超出范围的坐标沿最后一维延伸
    return crd * stride


def fmt(t):
    return "(" + ",".join(fmt(x) for x in t) + ")" if is_tuple(t) else str(t)


class Layout:
    def __init__(self, shape, stride=None):
        if stride is None:                                    # 默认步长:列优先的紧凑布局
            flat, acc = [], 1
            for n in flatten(shape):
                flat.append(acc)
                acc *= n
            stride = unflatten(tuple(flat), shape)[0]
        self.shape, self.stride = shape, stride

    def __call__(self, coord):
        """坐标 → 下标。coord 可以是整数(一维坐标),也可以是和形状对应的(嵌套)元组"""
        return crd2idx(coord, self.shape, self.stride)

    def size(self):                                           # 定义域的大小:有多少个坐标
        return size(self.shape)

    def cosize(self):                                         # 值域的大小:最大下标 + 1
        return self(self.size() - 1) + 1

    def __len__(self):                                        # 秩:顶层有几维(mode)
        return len(self.shape) if is_tuple(self.shape) else 1

    def __getitem__(self, i):                                 # 第 i 维单独拿出来,也是一个布局
        return Layout(self.shape[i], self.stride[i]) if is_tuple(self.shape) else self

    def __eq__(self, other):
        return (self.shape, self.stride) == (other.shape, other.stride)

    def __repr__(self):
        return f"{fmt(self.shape)}:{fmt(self.stride)}"


def make_layout(*layouts):
    """把几个布局并排成一个多维布局"""
    return Layout(tuple(l.shape for l in layouts), tuple(l.stride for l in layouts))


def coalesce(layout):
    """合并:把"接得上"的相邻维(形状 × 步长 = 下一维的步长)并成一维,去掉长度为 1 的维;一维坐标上的函数不变"""
    shape, stride = [1], [0]
    for n, d in zip(flatten(layout.shape), flatten(layout.stride)):
        if n == 1:
            continue
        if shape[-1] == 1:
            shape[-1], stride[-1] = n, d
        elif shape[-1] * stride[-1] == d:
            shape[-1] *= n
        else:
            shape.append(n)
            stride.append(d)
    return Layout(shape[0], stride[0]) if len(shape) == 1 else Layout(tuple(shape), tuple(stride))
把三个布局画成表格(第 i 行第 j 列是坐标 (i, j) 映射到的下标):
from layout_core import Layout, coalesce


def show(layout, rows, cols):
    """把二维布局画成表格:第 i 行第 j 列是坐标 (i, j) 映射到的下标"""
    print(layout)
    for i in range(rows):
        print("  " + " ".join(f"{layout((i, j)):3d}" for j in range(cols)))


col = Layout((4, 8))                                 # 默认步长:列优先,(4,8):(1,4)
show(col, 4, 8)
show(Layout((4, 8), (8, 1)), 4, 8)                   # 行优先
h = Layout((4, (2, 4)), (2, (1, 8)))                 # 列这一维拆成 (2,4):两列一组,组内相邻,组间隔 8
show(h, 4, 8)
print("h((1,5)) =", h((1, 5)), " h((1,(1,2))) =", h((1, (1, 2))), " h(5) =", h(5))
print("一维坐标 0..7 →", [h(i) for i in range(8)])
print("size =", h.size(), " cosize =", h.cosize(), " rank =", len(h), " h[1] =", h[1])
print("coalesce((2,(1,6)):(1,(6,2))) =", coalesce(Layout((2, (1, 6)), (1, (6, 2)))))
print("coalesce((4,8):(1,4)) =", coalesce(col), " coalesce((4,8):(8,1)) =", coalesce(Layout((4, 8), (8, 1))))
(4,8):(1,4)
    0   4   8  12  16  20  24  28
    1   5   9  13  17  21  25  29
    2   6  10  14  18  22  26  30
    3   7  11  15  19  23  27  31
(4,8):(8,1)
    0   1   2   3   4   5   6   7
    8   9  10  11  12  13  14  15
   16  17  18  19  20  21  22  23
   24  25  26  27  28  29  30  31
(4,(2,4)):(2,(1,8))
    0   1   8   9  16  17  24  25
    2   3  10  11  18  19  26  27
    4   5  12  13  20  21  28  29
    6   7  14  15  22  23  30  31
h((1,5)) = 19  h((1,(1,2))) = 19  h(5) = 3
一维坐标 0..7 → [0, 2, 4, 6, 1, 3, 5, 7]
size = 32  cosize = 32  rank = 2  h[1] = (2,4):(1,8)
coalesce((2,(1,6)):(1,(6,2))) = 12:1
coalesce((4,8):(1,4)) = 32:1  coalesce((4,8):(8,1)) = (4,8):(8,1)
几点值得注意:
Layout((4, 8))不给步长时默认是列优先的(4,8):(1,4):一维坐标本来就按第 0 维最快的顺序展开,列优先让一维坐标和下标完全一致。- 第三个布局里,每两列一组:组内的两列相邻(步长 1),一列内相邻两行差 2,组与组之间差 8。4 行 × 2 列这 8 个元素在内存里连续,按行排列。这正是"分块存放":形状仍是 4×8,逻辑坐标不变,变的只是步长。
- 一维坐标 0..7 映射到 0, 2, 4, 6, 1, 3, 5, 7:先走完第 0 维(4 行),再走第 1 维。布局不一定单调,也不一定一一对应(步长为 0 的维会把多个坐标映射到同一个下标,常用来表示广播)。
合并:同一个函数的最简写法
coalesce 把布局展平,去掉长度为 1 的维,再把首尾相接的相邻两维并成一维:第 k 维的"形状 × 步长"正好等于第 k+1 维的步长时,走完第 k 维恰好接上第 k+1 维的起点,两维可以写成一维。它保持的是一维坐标上的函数:对任何 i,合并前后的 L(i) 相同。
(2,(1,6)):(1,(6,2)):去掉长度为 1 的维后是(2,6):(1,2),2 × 1 = 2 等于下一维的步长,合并成12:1;(4,8):(1,4)合并成32:1:列优先的整块就是一段连续内存;(4,8):(8,1)不能合并:4 × 8 = 32 ≠ 1。
合并的一个直接用处是判断能不能向量化:一个线程要搬的那几个元素,合并后如果第 0 维是 n:1,这 n 个元素就是连续的,可以用一条 8 字节或 16 字节的指令一次搬完。CuTe 的 copy 正是这样做的:它用 max_common_vector(src, dst) 求出源和目的布局共同的连续元素个数,自动选择向量宽度(最多 128 位)。
复合:在布局上再套一层布局
复合(composition)的定义很简单:R = A ∘ B,R(c) = A(B(c))。B 的输出是 A 的一维坐标,所以 B 决定"从 A 里取哪些元素、按什么顺序",R 的形状就是 B 的形状。
当 B 只有一维 n:d 时,A ∘ B 是"在 A 的一维坐标上每隔 d 个取一个,取 n 个"。算法是先跳过 d,再取出 n:从 A(先合并)的第 0 维开始,形状能被 d 整除就把这一维的形状除以 d、步长乘以 d;不够除,就说明这一维已经被跳过,把余下的 d 带到下一维;跳完再从剩下的形状里取出 n 个。B 有多维时,每一维分别和 A 复合再并排。实现如下,补集和划分也在这个文件里:
"""layout_algebra.py —— 布局代数:复合、补集、逻辑划分。算法与 CUTLASS 自带的 pycute 一致,另外像 CuTe 一样检查整除条件。"""

from layout_core import Layout, coalesce, flatten, is_tuple, make_layout


def composition(a, b):
    """复合:R(c) = A(B(c)),R 的形状就是 B 的形状。B 也可以是逐维作用的元组(每一维一个布局)"""
    if isinstance(b, tuple):                                  # 逐维复合:A 的第 i 维和 B 的第 i 维复合
        return make_layout(*[composition(a[i], b[i]) for i in range(len(b))], *[a[i] for i in range(len(b), len(a))])
    if is_tuple(b.shape):                                     # B 有多个维:每一维分别和 A 复合
        return make_layout(*[composition(a, b[i]) for i in range(len(b))])
    if b.stride == 0:
        return Layout(b.shape, 0)
    rest_n, rest_d = b.shape, b.stride                        # B = n:d —— 在 A 里每隔 d 个取一个,一共取 n 个
    shape, stride = [], []
    fa = coalesce(a)
    fn, fd = flatten(fa.shape), flatten(fa.stride)
    for n, d in zip(fn[:-1], fd[:-1]):                        # 逐维"先跳过 d,再取出 n"
        assert n % rest_d == 0 or rest_d % n == 0, "步长不整除,复合没有定义"
        take = min(max(1, n // rest_d), rest_n)
        assert rest_n % take == 0, "形状不整除,复合没有定义"
        if take != 1:
            shape.append(take)
            stride.append(rest_d * d)
        rest_n //= take
        rest_d = -(-rest_d // n)
    if rest_n != 1 or not shape:                              # A 的最后一维可以无限延伸
        shape.append(rest_n)
        stride.append(rest_d * fd[-1])
    return Layout(shape[0], stride[0]) if len(shape) == 1 else Layout(tuple(shape), tuple(stride))


def complement(layout, max_idx=1):
    """补集:A 没有覆盖的下标怎么排。(A, 补集) 合起来恰好把 [0, max_idx) 每个下标覆盖一次"""
    shape, stride, cur = [], [], 1
    for d, n in sorted(zip(flatten(layout.stride), flatten(layout.shape))):
        if d == 0 or n == 1:
            continue
        assert d % cur == 0, "A 的各维互相交叠,补集没有定义"
        shape.append(d // cur)
        stride.append(cur)
        cur = n * d
    shape.append(-(-max_idx // cur))
    stride.append(cur)
    return coalesce(Layout(tuple(shape), tuple(stride)))


def logical_divide(a, b):
    """逻辑划分:按 B 把 A 切成块。第 0 维是块内(B 选中的元素),第 1 维是第几块。B 可以是逐维作用的元组"""
    if isinstance(b, tuple):
        return make_layout(*[logical_divide(a[i], b[i]) for i in range(len(b))], *[a[i] for i in range(len(b), len(a))])
    return composition(a, make_layout(b, complement(b, a.size())))


def zipped_divide(a, tiler):
    """逐维划分之后重新分组:((块内的各维), (块号的各维))"""
    d = logical_divide(a, tiler)
    return make_layout(make_layout(*[d[i][0] for i in range(len(tiler))]),
                       make_layout(*[d[i][1] for i in range(len(tiler))]))
以 A = (6,2):(8,2)、B = (4,3):(3,1) 为例,手算一遍:
- B 的第 0 维
4:3:在 A 里每隔 3 个取 1 个,取 4 个。A 的第 0 维有 6 个元素,每隔 3 个取 1 个剩 6 / 3 = 2 个,步长 3 × 8 = 24;还差 4 / 2 = 2 个,从 A 的第 1 维接着取(步长 2),得到(2,2):(24,2); - B 的第 1 维
3:1:取 A 的前 3 个元素,都在 A 的第 0 维里,得到3:8; - 合起来 R =
((2,2),3):((24,2),8),下面的程序逐个核对 R(i) = A(B(i))。
复合最常见的用途是不搬数据、换一种视图:
from layout_algebra import composition, complement, logical_divide
from layout_core import Layout, make_layout

a = Layout((6, 2), (8, 2))
b = Layout((4, 3), (3, 1))
r = composition(a, b)
print("A =", a, " B =", b, " A∘B =", r)
print("逐个核对 R(i) == A(B(i)):", all(r(i) == a(b(i)) for i in range(b.size())))
for bad in (Layout(4, 2), Layout(4, 4)):                 # 不满足整除条件的复合
    try:
        composition(a, bad)
    except AssertionError as e:
        print(f"A∘{bad}:{e}")

m = Layout((4, 8), (8, 1))                           # 4×8 的行优先矩阵
t = composition(m, Layout((8, 4), (4, 1)))
print("转置视图:", t, " t((5,2)) =", t((5, 2)), " m((2,5)) =", m((2, 5)))
e = composition(m, Layout((2, 8), (2, 4)))
print("只取偶数行:", e, " 第 1 行 =", [e((1, j)) for j in range(8)])

c = complement(Layout(4, 2), 24)
print("complement(4:2, 24) =", c, " 拼起来:", make_layout(Layout(4, 2), c),
      " 覆盖 0..23 各一次:", sorted(make_layout(Layout(4, 2), c)(i) for i in range(24)) == list(range(24)))
print("complement((2,2):(1,6), 24) =", complement(Layout((2, 2), (1, 6)), 24))

d = logical_divide(Layout(24), Layout(4, 2))
print("logical_divide(24:1, 4:2) =", d)
for k in range(d[1].size()):
    print(f"  第 {k} 块:", [d((i, k)) for i in range(4)])
A = (6,2):(8,2)  B = (4,3):(3,1)  A∘B = ((2,2),3):((24,2),8)
逐个核对 R(i) == A(B(i)): True
A∘4:2:形状不整除,复合没有定义
A∘4:4:步长不整除,复合没有定义
转置视图: (8,4):(1,8)  t((5,2)) = 21  m((2,5)) = 21
只取偶数行: (2,8):(16,1)  第 1 行 = [16, 17, 18, 19, 20, 21, 22, 23]
complement(4:2, 24) = (2,3):(1,8)  拼起来: (4,(2,3)):(2,(1,8))  覆盖 0..23 各一次: True
complement((2,2):(1,6), 24) = (3,2):(2,12)
logical_divide(24:1, 4:2) = (4,(2,3)):(2,(1,8))
  第 0 块: [0, 2, 4, 6]
  第 1 块: [1, 3, 5, 7]
  第 2 块: [8, 10, 12, 14]
  第 3 块: [9, 11, 13, 15]
  第 4 块: [16, 18, 20, 22]
  第 5 块: [17, 19, 21, 23]
- 转置视图:行优先的 4×8 矩阵 m =
(4,8):(8,1),复合(8,4):(4,1)得到(8,4):(1,8),t(5, 2) = m(2, 5) = 21。 - 只取偶数行:复合
(2,8):(2,4),每隔一行取一行,得到(2,8):(16,1),它的第 1 行就是原矩阵的第 2 行。 - 生态一章里的 swizzle 也是复合:
composition(Swizzle<2,0,3>{}, tile)在布局算出的下标上再套一个异或函数。 - 复合不是总有定义。仍以 A =
(6,2):(8,2)为例:∘4:2在 A 的第 0 维上每隔 2 个取 1 个,只能取出 3 个,要取的 4 个没法按"每维取整数个"拆开;∘4:4的第 3 个元素是 A 的一维坐标 8,落在第 1 列的中间,也没法用一个步长表示。本章的实现对这两种情况都直接报错(输出的第 3、4 行)。CuTe 在编译期检查它能判断的部分:前者是一条 "Shape Divisibility Condition" 的static_assert编译错误;后者用 CUTLASS 4.8 却能编译通过,得到的(_2,_2):(_32,_2)并不满足 R(i) = A(B(i))(R(2) = 2,而 A(8) = 18)。所以给 CuTe 写块大小和 tiler 时,要自己保证整除关系成立。
补集与划分:把数据切成块
补集(complement)回答的问题是:布局 A 只覆盖了一部分下标,剩下的"空隙"怎么排?complement(A, M) 返回一个布局 A*,使 (A, A*) 合起来恰好把 [0, M) 的每个下标覆盖一次。上面的输出里,4:2 覆盖 {0, 2, 4, 6},它在 24 以内的补集是 (2,3):(1,8):先偏移 0 或 1 填上奇数位置,再以 8 为周期重复 3 次;拼起来的 (4,(2,3)):(2,(1,8)) 恰好覆盖 0..23 各一次。
有了补集,逻辑划分(logical_divide)只是一行:
(B, B*) 把 A 的一维坐标重排成两维:第 0 维是 B 选中的元素(块内),第 1 维是第几块。logical_divide(24:1, 4:2) 把 24 个元素分成 6 块,每块是间隔 2 的 4 个元素:块 0 是 0, 2, 4, 6,块 1 是 1, 3, 5, 7,块 2 从 8 开始……B 不一定是连续的一段,所以"块"可以是任意规则的一组元素。
二维以上时,划分的参数是一个逐维的元组(CuTe 叫 tiler):第 0 维按第一个布局划分,第 1 维按第二个布局划分。zipped_divide 再把结果重新分组成 ((块内的各维), (块号的各维)),这是最常用的形式。CuTe 还有 tiled_divide、flat_divide,内容相同,只是块号各维的分组方式不同。与划分对偶的是乘积:logical_product、blocked_product、raked_product 把一个小布局按另一个布局复制多份,后面构造线程划分时会用到。
从块到线程:local_tile 与 local_partition
有了 zipped_divide,kernel 里的两级划分都是"划分,再固定其中一维"(cute/tensor_impl.hpp):
local_tile(tensor, tiler, coord):按 tiler 划分,用 CTA 的坐标固定块号那一维,剩下这个 CTA 负责的整块;local_partition(tensor, thr_layout, tid):按线程布局的形状划分,用线程在线程布局里的坐标固定块内那一维,剩下的块号那一维就是这个线程的各个值——线程 tid 在每一块里都拿同一个位置的元素。
CuTe 教程 examples/cute/tutorial/sgemm_1.cu 的主体就是这几行(节选,中文注释是本书加的):
Tensor gA = local_tile(mA, cta_tiler, cta_coord, Step<_1, X,_1>{});  // (BLK_M,BLK_K,k):这个 CTA 的 A
Tensor tAgA = local_partition(gA, tA, threadIdx.x);                  // (THR_M,THR_K,k):这个线程从全局内存搬的部分
Tensor tAsA = local_partition(sA, tA, threadIdx.x);                  // (THR_M,THR_K):  它在共享内存里对应的位置
copy(tAgA(_,_,k_tile), tAsA);                                        // 形状相同的两个张量,逐元素拷贝
线程布局怎么选,直接决定访存效率。下面用一块 16×8 的列优先 fp32 数据,比较两种分给 32 个线程的方法:一种是每个线程拿一个 2×2 的小块(块号就是线程号),一种是 local_partition 配 (16,2) 的线程布局。按内存一章的模型,一条访存指令的代价是 32 个线程的地址落在多少个 32 字节扇区里:
from layout_algebra import zipped_divide
from layout_core import Layout

tile = Layout((16, 8))                               # 16×8 的 fp32 块,列优先:同一列的 16 个元素相邻
print("tile =", tile)


def blocked(val_shape):
    """每个线程拿一个 val_shape 的小块:按小块划分,"块号"那一维就是线程号"""
    d = zipped_divide(tile, tuple(Layout(n) for n in val_shape))
    print(f"每个线程一个 {val_shape[0]}×{val_shape[1]} 的小块:", d)
    return lambda t, v: d((v, t))


def local_partition(thr):
    """CuTe 的 local_partition:按线程布局的形状划分,线程在块里的坐标固定"块内"那一维,剩下的"块号"是它的各个值"""
    d = zipped_divide(tile, tuple(Layout(n) for n in thr.shape))
    print(f"按线程布局 {thr} 划分:", d)
    pos = [thr(j) for j in range(thr.size())]
    return lambda t, v: d((pos.index(t), v))


def request(part, values):
    """一条访存指令:32 个线程各读自己编号为 values 的值,数一数落在几个 32 字节扇区里"""
    addr = sorted(part(t, v) for t in range(32) for v in values)
    sectors = len({a * 4 // 32 for a in addr})
    print(f"  读编号 {values} 的值:地址 {addr[:6]}…,{sectors} 个扇区,利用率 {len(addr) * 4 / (sectors * 32):.0%}")


p = blocked((2, 2))
print("  线程 0、1、8 的值:", [[p(t, v) for v in range(4)] for t in (0, 1, 8)])
request(p, [0])                                      # 每个线程读 4 字节
request(p, [0, 1])                                   # 前两个值在内存里相邻:一条 8 字节的向量指令读完
q = local_partition(Layout((16, 2)))
print("  线程 0、1、16 的值:", [[q(t, v) for v in range(4)] for t in (0, 1, 16)])
request(q, [0])
tile = (16,8):(1,16)
每个线程一个 2×2 的小块: ((2,2),(8,4)):((1,16),(2,32))
  线程 0、1、8 的值: [[0, 1, 16, 17], [2, 3, 18, 19], [32, 33, 48, 49]]
  读编号 [0] 的值:地址 [0, 2, 4, 6, 8, 10]…,8 个扇区,利用率 50%
  读编号 [0, 1] 的值:地址 [0, 1, 2, 3, 4, 5]…,8 个扇区,利用率 100%
按线程布局 (16,2):(1,16) 划分: ((16,2),(1,4)):((1,16),(0,32))
  线程 0、1、16 的值: [[0, 32, 64, 96], [1, 33, 65, 97], [16, 48, 80, 112]]
  读编号 [0] 的值:地址 [0, 1, 2, 3, 4, 5]…,4 个扇区,利用率 100%
- 每个线程一个 2×2 小块:线程号那一维是
(8,4):(2,32),相邻线程的地址差 2,一条读 4 字节的指令只用到每个扇区的一半,利用率 50%——正是内存一章表格里"跨步 2"那一行。 - 但这个线程的值那一维是
(2,2):(1,16),前两个值在内存里相邻。用一条 8 字节的向量指令同时读这两个值,同样 8 个扇区装满有用的数据,利用率回到 100%。向量化和线程排布是两个互补的手段,CuTe 的copy会根据布局自动选向量宽度。 local_partition配 (16,2) 的线程布局:块内那一维(16,2):(1,16)由线程号索引,相邻线程的地址差 1,32 个线程一条指令读连续的 128 字节,4 个扇区,利用率 100%。规则是:线程布局的快维要沿着数据在内存里连续的方向。
实际的 CuTe kernel 很少手写这些划分,而是用 make_tiled_copy(copy_atom, thr_layout, val_layout) 描述"每个线程一次搬 val_layout 这么多、线程按 thr_layout 排",CuTe 用 raked_product(thr_layout, val_layout) 和 right_inverse 算出 TV 布局:(线程号, 值编号) → 块内坐标。CuTe 教程 sgemm_sm80.cu 拷贝 A 的配置是 128 个线程排成 (16,8):(8,1)(K 方向相邻)、每个线程 (1,8) 个 half(一条 16 字节的 cp.async),它的 TV 布局在本章最后的 C++ 程序里打印出来,练习 2 请你读懂它。
Tensor Core 的寄存器布局也是一个布局
Tensor Core 一章列了一张表:mma.sync.m16n8k16 的 A、B、C 每个线程持有哪些元素。在 CuTe 里,这张表就是一个 TV 布局,写在 cute/atom/mma_traits_sm80.hpp 的 MMA_Traits 里:
template <>
struct MMA_Traits<SM80_16x8x16_F16F16F16F16_TN>   // FP32 累加的 SM80_16x8x16_F32F16F16F32_TN 继承它,只改值类型
{
  using ValTypeD = half_t;
  using ValTypeA = half_t;
  using ValTypeB = half_t;
  using ValTypeC = half_t;

  using Shape_MNK = Shape<_16,_8,_16>;
  using ThrID   = Layout<_32>;
  using ALayout = Layout<Shape <Shape < _4,_8>,Shape < _2,_2,  _2>>,
                         Stride<Stride<_32,_1>,Stride<_16,_8,_128>>>;
  using BLayout = Layout<Shape <Shape < _4,_8>,Shape <_2, _2>>,
                         Stride<Stride<_16,_1>,Stride<_8,_64>>>;
  using CLayout = SM80_16x8_Row;
};
其中 SM80_16x8_Row 是 ((_4,_8),(_2,_2)):((_32,_1),(_16,_8))。
三个布局都把 (线程号, 值编号) 映射到块内的列优先下标:A 是 M×K(16×16,下标 = 行 + 16 × 列),B 是 N×K(8×16,下标 = n + 8k),C 是 M×N(16×8)。以 A 为例,线程号这一维 (4,8):(32,1) 把 lane 拆成 (lane % 4, lane / 4),也就是表里的 t 和 g:g 走行(步长 1),t 每加 1 右移两列(步长 32 = 2 × 16);值那一维 (2,2,2):(16,8,128) 依次是"右边一列""下面 8 行""右边 8 列"。用本章的实现把三个布局展开,和表格逐项核对:
from layout_core import Layout

# CUTLASS 的 cute/atom/mma_traits_sm80.hpp:SM80_16x8x16_F32F16F16F32_TN(mma.sync.m16n8k16)的 TV 布局,
# 把 (线程号, 值编号) 映射到块内的列优先下标
A = Layout(((4, 8), (2, 2, 2)), ((32, 1), (16, 8, 128)))    # A:16×16 的 M×K
B = Layout(((4, 8), (2, 2)), ((16, 1), (8, 64)))            # B:8×16 的 N×K,下标 = n + 8k
C = Layout(((4, 8), (2, 2)), ((32, 1), (16, 8)))            # C:16×8 的 M×N


def rc(idx):
    return idx % 16, idx // 16                       # 列优先下标 → (行, 列)


def ptx_a(lane, i):                                  # PTX 文档的表(Tensor Core 一章抄过):g = lane / 4,t = lane % 4
    g, t = lane // 4, lane % 4
    return g + 8 * (i // 2 % 2), 2 * t + i % 2 + 8 * (i // 4)


def ptx_b(lane, i):                                  # B 按 (k, n) 给出
    g, t = lane // 4, lane % 4
    return 2 * t + i % 2 + 8 * (i // 2), g


def ptx_c(lane, i):
    g, t = lane // 4, lane % 4
    return g + 8 * (i // 2), 2 * t + i % 2


for lane in (0, 1, 4):
    print(f"lane {lane}:A 的 8 个值在", [rc(A((lane, i))) for i in range(8)])
print("A 与 PTX 的表一致:", all(rc(A((l, i))) == ptx_a(l, i) for l in range(32) for i in range(8)))
print("B 与 PTX 的表一致:", all((B((l, i)) // 8, B((l, i)) % 8) == ptx_b(l, i) for l in range(32) for i in range(4)))
print("C 与 PTX 的表一致:", all(rc(C((l, i))) == ptx_c(l, i) for l in range(32) for i in range(4)))
owner = {rc(C((l, i))): l for l in range(32) for i in range(4)}
print("C 的每个元素归哪个线程(行 0~3):")
for r in range(4):
    print("  " + " ".join(f"{owner[(r, c)]:2d}" for c in range(8)))
lane 0:A 的 8 个值在 [(0, 0), (0, 1), (8, 0), (8, 1), (0, 8), (0, 9), (8, 8), (8, 9)]
lane 1:A 的 8 个值在 [(0, 2), (0, 3), (8, 2), (8, 3), (0, 10), (0, 11), (8, 10), (8, 11)]
lane 4:A 的 8 个值在 [(1, 0), (1, 1), (9, 0), (9, 1), (1, 8), (1, 9), (9, 8), (9, 9)]
A 与 PTX 的表一致: True
B 与 PTX 的表一致: True
C 与 PTX 的表一致: True
C 的每个元素归哪个线程(行 0~3):
   0  0  1  1  2  2  3  3
   4  4  5  5  6  6  7  7
   8  8  9  9 10 10 11 11
  12 12 13 13 14 14 15 15
一个布局就把整张表说清楚了,而且可以参与运算:make_tiled_mma(mma_atom, Layout<Shape<_2,_2,_1>>{}) 用乘积把一个 warp 的 MMA 复制到 2×2 个 warp;thr_mma.partition_A(sA)、partition_fragment_C(...) 用 TV 布局从共享内存和寄存器里划出每个线程的那一份。ldmatrix、wgmma、tcgen05 的布局也是这样写在各自的 traits 里,读 CUTLASS 的 kernel 时不必再去翻 PTX 文档的表。
和真正的 CuTe 对照
下面的程序用 CUTLASS 自带的 CuTe 重做本章的每个例子,只在主机端运行,不需要 GPU。形状和步长写成编译期常量 _N(即 Int<N>{}),打印时带下划线:
// cute_algebra.cu —— 用 CUTLASS 里真正的 CuTe 核对本章的布局代数:只在主机端运行,不需要 GPU
// 编译:nvcc -std=c++17 -arch=sm_80 -I${CUTLASS_DIR}/include cute_algebra.cu -o cute_algebra
#include <cstdio>
#include <cute/tensor.hpp>
#include <cute/atom/copy_atom.hpp>
#include <cute/atom/mma_atom.hpp>
using namespace cute;

template <class T>
void show(const char* name, T const& x) {
  printf("%-20s", name);
  print(x);
  printf("\n");
}

int main() {
  // 1. 布局代数:形状、步长都用编译期常量 _N(即 Int<N>{}),化简才能在编译期完成
  show("coalesce", coalesce(make_layout(make_shape(_2{}, make_shape(_1{}, _6{})),
                                        make_stride(_1{}, make_stride(_6{}, _2{})))));
  show("coalesce (int)", coalesce(make_layout(make_shape(2, make_shape(1, 6)),   // 普通 int:只能展平
                                              make_stride(1, make_stride(6, 2)))));
  auto a = make_layout(make_shape(_6{}, _2{}), make_stride(_8{}, _2{}));
  auto b = make_layout(make_shape(_4{}, _3{}), make_stride(_3{}, _1{}));
  show("composition", composition(a, b));
  auto m = make_layout(make_shape(_4{}, _8{}), LayoutRight{});                 // 4x8 行优先
  show("transpose view", composition(m, make_layout(make_shape(_8{}, _4{}), LayoutRight{})));
  show("even rows", composition(m, make_layout(make_shape(_2{}, _8{}), make_stride(_2{}, _4{}))));
  show("complement", complement(make_layout(_4{}, _2{}), _24{}));
  show("logical_divide", logical_divide(make_layout(_24{}), make_layout(_4{}, _2{})));
  auto tile = make_layout(make_shape(_16{}, _8{}));                             // 16x8 列优先
  show("zipped_divide 2x2", zipped_divide(tile, make_shape(_2{}, _2{})));
  show("zipped_divide 16x2", zipped_divide(tile, make_shape(_16{}, _2{})));

  // 2. 线程划分:CuTe 教程 sgemm_sm80.cu 里 A 的拷贝,128 个线程按 16x8(k 方向相邻)排,每个线程 8 个 half
  using CopyA = decltype(make_tiled_copy(Copy_Atom<SM80_CP_ASYNC_CACHEALWAYS<uint128_t>, half_t>{},
                                         Layout<Shape<_16, _8>, Stride<_8, _1>>{}, Layout<Shape<_1, _8>>{}));
  show("TiledCopy tile", typename CopyA::Tiler_MN{});
  show("TiledCopy TV", typename CopyA::TiledLayout_TV{});

  // 3. Tensor Core:mma.sync.m16n8k16 的寄存器布局,(线程, 值) -> 块内列优先下标
  using Traits = MMA_Traits<SM80_16x8x16_F32F16F16F32_TN>;
  show("MMA A (thr,val)", typename Traits::ALayout{});
  show("MMA B (thr,val)", typename Traits::BLayout{});
  show("MMA C (thr,val)", typename Traits::CLayout{});
  return 0;
}
用 CUTLASS 4.8 编译运行(nvcc 12.9 与 13.4 结果相同):
coalesce            _12:_1
coalesce (int)      (2,1,6):(1,6,2)
composition         ((_2,_2),_3):((_24,_2),_8)
transpose view      (_8,_4):(_1,_8)
even rows           (_2,_8):(_16,_1)
complement          (_2,_3):(_1,_8)
logical_divide      (_4,(_2,_3)):(_2,(_1,_8))
zipped_divide 2x2   ((_2,_2),(_8,_4)):((_1,_16),(_2,_32))
zipped_divide 16x2  ((_16,_2),(_1,_4)):((_1,_16),(_0,_32))
TiledCopy tile      (_16,_64)
TiledCopy TV        ((_8,_16),_8):((_128,_1),_16)
MMA A (thr,val)     ((_4,_8),(_2,_2,_2)):((_32,_1),(_16,_8,_128))
MMA B (thr,val)     ((_4,_8),(_2,_2)):((_16,_1),(_8,_64))
MMA C (thr,val)     ((_4,_8),(_2,_2)):((_32,_1),(_16,_8))
除了下划线,每一行都和前面 Python 的结果相同。只有第二行不同:同一个布局用普通 int 构造时,coalesce 只做了展平,没有合并。原因是 CuTe 的布局类型在编译期就要确定,普通 int 的值到运行时才知道,哪一维是 1、哪两维接得上,编译期无从判断。所以 CuTe kernel 里的块大小、线程布局几乎都写成 _128{}、Int<N>{} 这样的常量:化简、整除检查都在编译期完成,生成的代码里只剩最后的乘加。只有矩阵的 M、N、K 这类运行时才知道的量用普通整数。
CUTLASS 4.x 的 CuTe DSL 用 Python 写 kernel,函数名和这里一一对应:cute.make_layout、cute.coalesce、cute.composition、cute.complement、cute.logical_divide、cute.zipped_divide、cute.local_tile、cute.local_partition、cute.make_tiled_copy_tv。理解了布局代数,C++ 和 Python 两套接口读起来是一样的。
继续学 CuTe 的顺序建议:CUTLASS 仓库 media/docs/cpp/cute/ 下的 01_layout.md、02_layout_algebra.md(本章内容的原始出处)、03_tensor.md、0t_mma_atom.md;再读 examples/cute/tutorial/ 的 sgemm_1.cu(只用 local_tile / local_partition)、sgemm_sm80.cu(TiledCopy + TiledMMA + cp.async);最后读 Hopper、Blackwell 的例子(TMA、wgmma、tcgen05)。遇到看不懂的布局,就用 print / print_layout 在主机端打印出来,或者像本章一样用 pycute 算一遍。
怎么讲清楚
讲"CuTe 的 Layout 是什么、为什么要用它":布局 = 形状 : 步长,是从(可以嵌套的)逻辑坐标到一维下标的函数,下标是坐标与步长的内积;张量 = 指针 + 布局。数据的摆放、CTA 分块、线程划分、MMA 的寄存器布局都用布局表示,靠一套代数组合:coalesce 化简(函数不变),复合 A∘B 换视图(形状取自 B),补集填空隙,logical_divide = A∘(B, complement(B))、zipped_divide 得到 ((块内), (块号));local_tile 固定块号给 CTA,local_partition 固定块内位置给线程;MMA atom 的 TV 布局把 (线程, 值) 映射到块内坐标。形状写成编译期常量时,化简和整除检查都在编译期完成。能举一个线程布局影响合并访问的例子(相邻线程步长 1 才能一条指令读满 128 字节),会加分。
练习
1. 隔一列取一列。 从 8×8 的行优先矩阵 A = (8,8):(8,1) 里取出第 0、2、4、6 列组成 8×4 的视图,B 应该是什么?A∘B 等于多少?
参考答案
视图的坐标 (i, j) 对应原矩阵的 (i, 2j),它在 A 里的一维坐标(第 0 维变化最快)是 i + 8 × 2j = i + 16j,所以 B = (8,4):(1,16)。复合时,B 的第 0 维 8:1 取 A 的前 8 个元素,正好是 A 的整个第 0 维,得到 8:8;B 的第 1 维 4:16 每隔 16 个取一个:A 的第 0 维只有 8 个元素,被整个跳过,余下的 16 / 8 = 2 带到 A 的第 1 维(步长 1),在那里每隔 2 个取一个、取 4 个,得到 4:2。结果是 (8,4):(8,2),即 R(i, j) = 8i + 2j = A(i, 2j)。
2. 读懂一个 TiledCopy。 本章最后的程序打印出 sgemm_sm80.cu 拷贝 A 的配置:块是 (_16,_64),TV 布局是 ((_8,_16),_8):((_128,_1),_16)(值是 16×64 块内的列优先下标,half 类型,K 方向在内存里连续)。线程 9 拷贝哪些元素?一个 warp 的 32 个线程覆盖哪几行?为什么每行正好 8 个线程?
参考答案
线程号那一维 (8,16):(128,1) 把 t 拆成 (t % 8, t / 8),下标 = 128 × (t % 8) + t / 8;值那一维 8:16 每个值加 16。下标 = 行 + 16 × 列,所以线程 t 负责第 t / 8 行、第 8 × (t % 8) 到 8 × (t % 8) + 7 列。线程 9 负责第 1 行的第 8~15 列。一个 warp 是线程 0~31,覆盖第 0~3 行,每行 64 个 half。每行 8 个线程 × 8 个 half × 2 字节 = 128 字节,正好是一整行、一个完整的 128 字节段:相邻线程沿 K 方向(内存连续的方向)排,一个 warp 的一条 16 字节 cp.async 读 4 个完整的 128 字节段,没有浪费。这就是线程布局写成 (16,8):(8,1)(K 方向相邻)的原因。
3. C 的一个元素。 用 CLayout = ((4,8),(2,2)):((32,1),(16,8)) 算出 lane 5 的第 3 个值(c3)在 C 的哪个位置,再用 PTX 的表核对。
参考答案
lane 5 拆成 (5 % 4, 5 / 4) = (1, 1),贡献 32 × 1 + 1 × 1 = 33;值 3 拆成 (1, 1),贡献 16 + 8 = 24。下标 57 = 9 + 16 × 3,即第 9 行第 3 列。PTX 的表:g = 5 / 4 = 1,t = 5 % 4 = 1,c3 在 (g + 8, 2t + 1) = (9, 3),一致。
小结
- 布局 = 形状 : 步长,是从(可嵌套的)坐标到下标的函数;一维坐标按第 0 维最快展开,默认步长是列优先;张量 = 指针 + 布局。
-
coalesce保持一维坐标上的函数不变,把首尾相接的维合并;合并后的连续维决定能用多宽的向量指令。 - 复合 R = A∘B 的形状取自 B,用来换视图(转置、跨步取行)、叠加 swizzle,不搬数据。
- 补集填上布局没覆盖的下标;
logical_divide= A∘(B, complement(B)),zipped_divide得到 ((块内), (块号))。 -
local_tile固定块号给 CTA,local_partition固定块内位置给线程;线程布局的快维要沿内存连续的方向。 - MMA atom 的 TV 布局就是 PTX 文档里的寄存器表;形状写成编译期常量,化简和检查都在编译期完成。
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题