链表、栈与哈希:把结构用对
这一章的三个结构在推理引擎里都能直接找到对应:KV 块池的空闲链表、调度器的请求队列、前缀缓存的哈希表、块分配器的 LRU。面试里它们也是最稳定的考点——链表考指针操作是否扎实,单调栈考"什么时候该把旧元素丢掉",哈希表考"用什么当键"。这一章把虚拟头节点、快慢指针、单调栈、单调队列和 LRU 这几个模板写清楚,每个都配了能跑的代码。
自测:能答上来就可以跳过本章
- 虚拟头节点(dummy node)解决了什么问题?
- 快慢指针除了找中点,还能做什么?
- 单调栈为什么是 O(n),哪怕代码里有嵌套的
while? - 实现一个 O(1) 的 LRU 缓存需要哪两个结构?各负责什么?
- 用哈希表按某种等价关系分组时,关键是什么?
自测参考答案(先自己答,再展开对照)
- 删除或插入头节点时不用特判。有了虚拟头,所有节点都有前驱,"删掉 prev.next"这一套逻辑对头节点也成立,代码短一半、错误少一半。
- 判环(快指针追上慢指针)、找环的入口(相遇后一个指针回到头,两个同速再走)、找倒数第 k 个节点(快指针先走 k 步)、判断回文链表(找中点 + 反转后半段)。
- 因为每个元素最多进栈一次、出栈一次,总操作数是 2n。嵌套的
while执行的总次数由"一共能弹出多少元素"约束,不是每个位置都要弹 n 次。滑动窗口和单调队列也是同一个论证。 - 哈希表(key → 节点,负责 O(1) 定位)+ 双向链表(负责维护使用顺序,O(1) 摘除和插入)。Python 里
OrderedDict已经把两者合在一起了,move_to_end和popitem(last=False)正好对应。 - 设计规范形式当键:互为异位词的词排序后相同、同一前缀的 token 序列哈希后相同、同一个块的内容哈希相同。等价关系一旦能算出一个确定的键,分组就是一次遍历。
先看一个六格小剧场,再读正文:
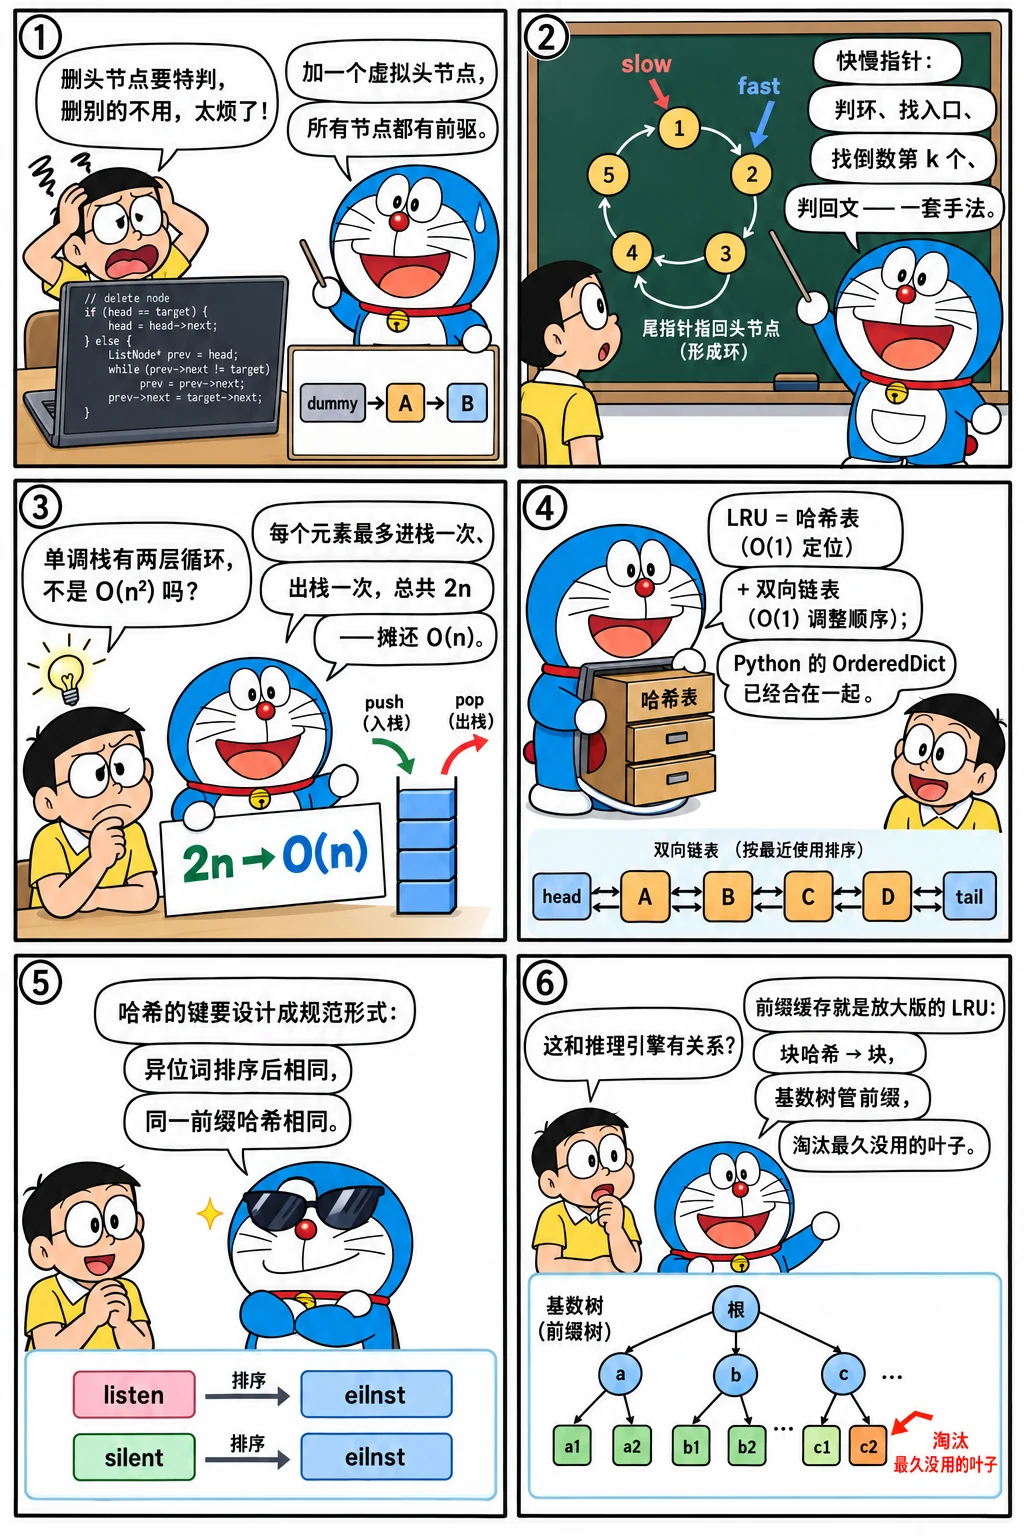
链表:虚拟头、快慢指针、原地反转
# 链表的三板斧:虚拟头节点、快慢指针、原地反转
class Node:
    def __init__(self, val, nxt=None):
        self.val, self.next = val, nxt


def build(vals):
    head = None
    for v in reversed(vals):
        head = Node(v, head)
    return head


def to_list(head):
    out = []
    while head:
        out.append(head.val)
        head = head.next
    return out


def remove_all(head, target):
    """删除所有值为 target 的节点:虚拟头节点让"删除头节点"不用特判"""
    dummy = Node(None, head)
    prev = dummy
    while prev.next:
        if prev.next.val == target:
            prev.next = prev.next.next         # 跳过它,prev 不动
        else:
            prev = prev.next
    return dummy.next


def middle(head):
    """快慢指针:快指针一次两步,慢指针一次一步,快到头时慢正好在中点"""
    slow = fast = head
    while fast and fast.next:
        slow, fast = slow.next, fast.next.next
    return slow.val if slow else None


def has_cycle(head):
    """判环:有环时快指针一定会追上慢指针"""
    slow = fast = head
    while fast and fast.next:
        slow, fast = slow.next, fast.next.next
        if slow is fast:
            return True
    return False


def reverse(head):
    """原地反转:三个指针,prev 是新的后继"""
    prev = None
    while head:
        head.next, prev, head = prev, head, head.next
    return prev


print("删除所有 2:", to_list(remove_all(build([2, 1, 2, 3, 2]), 2)))
print("删除头节点:", to_list(remove_all(build([1, 1, 1]), 1)), "(虚拟头节点省掉了特判)")
print("中间节点:", middle(build([1, 2, 3, 4, 5])), "(偶数个时取靠后的:", middle(build([1, 2, 3, 4])), ")")
print("反转:", to_list(reverse(build([1, 2, 3, 4, 5]))))

loop = build([1, 2, 3, 4])
tail = loop
while tail.next:
    tail = tail.next
tail.next = loop.next                          # 4 -> 2,成环
print("有环吗:", has_cycle(loop), ";无环的链表:", has_cycle(build([1, 2, 3])))
删除所有 2: [1, 3]
删除头节点: [] (虚拟头节点省掉了特判)
中间节点: 3 (偶数个时取靠后的: 3 )
反转: [5, 4, 3, 2, 1]
有环吗: True ;无环的链表: False
三件事:
- 虚拟头节点:只要可能删除或插入头节点,就先建一个
dummy,返回dummy.next。 - 快慢指针:找中点、判环、找倒数第 k 个、判回文。快指针一次两步时,循环条件要写
while fast and fast.next,顺序不能反(短路求值)。 - 原地反转:三指针
prev / cur / next,Python 里可以写成一行head.next, prev, head = prev, head, head.next,但面试时展开成三行更安全,也更好讲。
链表题在 Python 里优先写迭代:默认递归深度只有 1000,链表上万就会 RecursionError。
推理引擎里的链表:KV 块池的空闲块链表(O(1) 取出与归还)、请求的等待队列、CUDA 缓存分配器的空闲块链表(见缓存分配器)。真实系统里常用"数组 + 下标"代替指针(缓存更友好、可以直接序列化),道理是一样的。
栈与单调栈
栈的基本用途是"配对":括号匹配、表达式求值、撤销操作、递归转迭代(手动维护栈)。更值得练的是单调栈和单调队列:
# 单调栈与单调队列:一遍扫描解决"下一个更大元素"和"滑动窗口最大值"
from collections import deque


def next_greater(a):
    """每个元素右边第一个比它大的元素,没有就是 -1"""
    out = [-1] * len(a)
    stack = []                                 # 存下标,对应的值从栈底到栈顶递减
    for i, x in enumerate(a):
        while stack and a[stack[-1]] < x:      # 新元素比栈顶大:栈顶找到了答案
            out[stack.pop()] = x
        stack.append(i)
    return out


def largest_rectangle(heights):
    """柱状图里最大的矩形:每根柱子向左右扩展到第一个更矮的柱子"""
    stack, best = [], 0
    for i, h in enumerate(heights + [0]):      # 末尾补一个 0,把栈里剩下的全部弹出
        while stack and heights[stack[-1]] >= h:
            height = heights[stack.pop()]
            left = stack[-1] + 1 if stack else 0
            best = max(best, height * (i - left))
        stack.append(i)
    return best


def sliding_max(a, k):
    """滑动窗口最大值:双端队列里存下标,值单调递减"""
    dq, out = deque(), []
    for i, x in enumerate(a):
        while dq and a[dq[-1]] <= x:           # 比新元素小的都不可能再当最大值
            dq.pop()
        dq.append(i)
        if dq[0] <= i - k:                     # 队首滑出窗口
            dq.popleft()
        if i >= k - 1:
            out.append(a[dq[0]])
    return out


a = [2, 1, 2, 4, 3]
print("数组:", a)
print("下一个更大元素:", next_greater(a))
print("最大矩形(柱状图 [2,1,5,6,2,3]):", largest_rectangle([2, 1, 5, 6, 2, 3]))
print("滑动窗口最大值(k=3):", sliding_max([1, 3, -1, -3, 5, 3, 6, 7], 3))
print()
print("共同点:每个下标进栈/进队一次、出一次,所以是 O(n),哪怕代码里有嵌套的 while。")
数组: [2, 1, 2, 4, 3]
下一个更大元素: [4, 2, 4, -1, -1]
最大矩形(柱状图 [2,1,5,6,2,3]): 10
滑动窗口最大值(k=3): [3, 3, 5, 5, 6, 7]

共同点:每个下标进栈/进队一次、出一次,所以是 O(n),哪怕代码里有嵌套的 while。
判断一道题能不能用单调栈,看它是不是在问"每个元素左边/右边第一个比它大/小的元素",或者"以每个元素为最值的最大区间"。柱状图最大矩形、接雨水、每日温度、股票跨度都是这一类。
写的时候定三件事:栈里存下标还是值(存下标通常更灵活,能算距离)、栈内单调递增还是递减、弹出时结算什么。末尾补一个哨兵值(比如 0 或无穷大)可以省掉"循环结束后清空栈"的重复代码。
单调队列(双端队列)解决的是滑动窗口里的最值:队首是当前窗口的最大值,新元素进来时把队尾所有比它小的弹掉,队首滑出窗口时弹掉。它和单调栈的区别只在"两端都能弹"。
哈希表:键的设计
哈希表在题目里的三种常见用法:
| 用法 | 例子 | 键是什么 |
|---|---|---|
| 查"出现过没有" | 两数之和、最长无重复子串 | 元素值 |
| 计数 | 字母异位词、出现次数 Top-K | 元素值 |
| 按等价关系分组 | 异位词分组、按前缀分组 | 规范形式 |
第三种最需要动脑:等价关系要能算出一个确定的键。异位词用排序后的字符串或字母计数元组;同一条直线上的点用约分后的斜率元组;前缀缓存用"前缀 token 的滚动哈希"。
工程上还要注意:
- 哈希冲突和最坏复杂度。Python 的 dict 平均 O(1),但精心构造的键可能退化。服务端要处理不可信输入时,这是一个真实的攻击面(哈希碰撞攻击),解决办法是带随机盐的哈希(Python 默认开启
PYTHONHASHSEED随机化)。 - 键的内容要完整。推理系统里 vLLM 的块哈希不仅包含本块的 token,还包含父块的哈希、多模态输入的哈希、LoRA ID 和用于多租户隔离的
cache_salt——少一样就可能把内容不同的请求错误地共享(见前缀缓存)。 - 不可变才能当键。列表不行,转成元组;自定义对象要实现
__hash__和__eq__,并保证两者一致。
LRU:哈希表 + 双向链表
# LRU 缓存:哈希表定位 + 双向链表维护顺序。这里用 OrderedDict,再手写一遍对照
from collections import OrderedDict


class LRUEasy:
    def __init__(self, capacity):
        self.cap, self.d = capacity, OrderedDict()

    def get(self, key):
        if key not in self.d:
            return -1
        self.d.move_to_end(key)                # 变成最近使用
        return self.d[key]

    def put(self, key, value):
        if key in self.d:
            self.d.move_to_end(key)
        self.d[key] = value
        if len(self.d) > self.cap:
            self.d.popitem(last=False)         # 弹出最久没用的


class LRU:
    """手写版:双向链表的每个节点是 [key, value, prev, next],头是最久没用的"""

    def __init__(self, capacity):
        self.cap, self.map = capacity, {}
        self.head, self.tail = ["#head", None, None, None], ["#tail", None, None, None]
        self.head[3], self.tail[2] = self.tail, self.head

    def _unlink(self, node):
        node[2][3], node[3][2] = node[3], node[2]

    def _append(self, node):                   # 接到尾部(最近使用)
        node[2], node[3] = self.tail[2], self.tail
        self.tail[2][3] = node
        self.tail[2] = node

    def get(self, key):
        node = self.map.get(key)
        if node is None:
            return -1
        self._unlink(node)
        self._append(node)
        return node[1]

    def put(self, key, value):
        node = self.map.get(key)
        if node is not None:
            node[1] = value
            self._unlink(node)
            self._append(node)
            return
        node = [key, value, None, None]
        self.map[key] = node
        self._append(node)
        if len(self.map) > self.cap:
            oldest = self.head[3]
            self._unlink(oldest)
            del self.map[oldest[0]]


for cls in (LRUEasy, LRU):
    c = cls(2)
    c.put(1, 1)
    c.put(2, 2)
    got = [c.get(1)]                           # 访问 1,让 2 变成最久没用的
    c.put(3, 3)                                # 淘汰 2
    got += [c.get(2), c.get(3)]
    c.put(4, 4)                                # 淘汰 1
    got += [c.get(1), c.get(3), c.get(4)]
    print(f"{cls.__name__:8s} 依次得到 {got}(-1 表示已被淘汰)")
print()
print("两种写法都是 O(1):哈希表负责定位,双向链表负责维护顺序。")
print("推理引擎的 KV 块池用的是同一套结构:块哈希 -> 块,空闲块按 LRU 排队等待复用。")
LRUEasy  依次得到 [1, -1, 3, -1, 3, 4](-1 表示已被淘汰)
LRU      依次得到 [1, -1, 3, -1, 3, 4](-1 表示已被淘汰)

两种写法都是 O(1):哈希表负责定位,双向链表负责维护顺序。
推理引擎的 KV 块池用的是同一套结构:块哈希 -> 块,空闲块按 LRU 排队等待复用。
面试里问 LRU,要能说清三点:为什么要双向链表(摘除任意节点要 O(1),单向链表找不到前驱)、为什么要哈希表(否则定位是 O(n))、边界怎么处理(容量为 0、重复 put、get 未命中不能插入)。
推理引擎里的变体:
- vLLM 的块池用"空闲队列 + 块哈希表",没有哈希的块按 LIFO 放到队头(利于 GPU 局部性),有哈希的按 LRU 放到队尾;
- SGLang 的 Radix Cache 是带引用计数的叶子 LRU:正在被请求使用的节点锁住不许淘汰,淘汰从叶子开始;
- LFU(按使用频率)在缓存命中分布很偏时更好,但实现复杂、对突发流量反应慢,实践中用得少。
这一章的题在考什么
| 看到这些字眼 | 往哪个模板想 |
|---|---|
| 链表、删除、插入、头节点 | 虚拟头节点 |
| 中点、环、倒数第 k 个、回文链表 | 快慢指针 |
| 括号、匹配、撤销、表达式 | 栈 |
| 下一个更大、左边第一个更小、最大矩形、接雨水 | 单调栈 |
| 滑动窗口的最大值/最小值 | 单调队列 |
| 缓存、淘汰、O(1) 的 get 和 put | 哈希表 + 双向链表 |
| 分组、去重、出现次数 | 哈希表(关键是键的设计) |
怎么讲清楚
讲链表先说两个工具:"我会用虚拟头节点省掉头节点的特判,用快慢指针定位中点或判环",然后强调迭代写法(Python 递归深度只有 1000)。单调栈要主动证明复杂度:"每个下标进栈一次出栈一次,所以是 O(n)",并说清楚栈里存下标、单调方向、弹出时结算什么。LRU 直接给结构:"哈希表定位 + 双向链表维护顺序,都是 O(1)",再补一句真实系统的做法(vLLM 的空闲队列、SGLang 带引用计数的叶子 LRU)。哈希表的关键是键的设计,能举出"块哈希要包含父块哈希和 cache_salt"这种工程例子会加分。
小结
- 虚拟头节点省掉头节点特判;快慢指针解决中点、判环、倒数第 k 个、回文。
- 链表题在 Python 里优先写迭代,递归深度上限只有 1000。
- 单调栈解决"下一个更大/更小",单调队列解决滑动窗口最值;每个元素进出各一次,所以是 O(n)。
- LRU = 哈希表 + 双向链表;推理引擎的块池和 Radix Cache 是它的变体。
- 哈希表分组的关键是规范形式;键的内容要完整(块哈希要带父块、LoRA、salt)。
本章练习题(12 道)
在浏览器里直接写代码、跑测试;也可以在本地用 python practice/judge.py 判题。
- 250. 第一个不重复的元素(简单)
- 251. 最小栈(简单)
- 252. 反转链表(简单)
- 253. 用两个栈实现队列(简单)
- 254. 有效的括号(简单)
- 255. KV 块池:分配、归还与前缀复用(中等)
- 256. 环形链表与入环点(中等)
- 257. LRU 缓存(中等)
- 258. 合并 k 个有序链表(中等)
- 259. 单调栈:每日温度与接雨水(中等)
- 260. LFU 缓存(困难)
- 261. 滑动窗口最大值(困难)
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题