线程、进程与 GIL
并发是 Python 里最容易"写出来能跑、上线就出事"的领域。这一章先讲清楚 GIL 到底限制了什么,然后讲线程、进程和 concurrent.futures 的正确用法,最后给出一张选型表。
自测:能答上来就可以跳过本章
- GIL 是什么?为什么多线程下载文件能变快,多线程算素数却不能?
counter += 1在多线程下安全吗?ProcessPoolExecutor要求任务函数和参数满足什么条件?- 为什么多进程代码要放在
if __name__ == "__main__":里? executor.map和submit+as_completed有什么区别?
自测参考答案(先自己答,再展开对照)
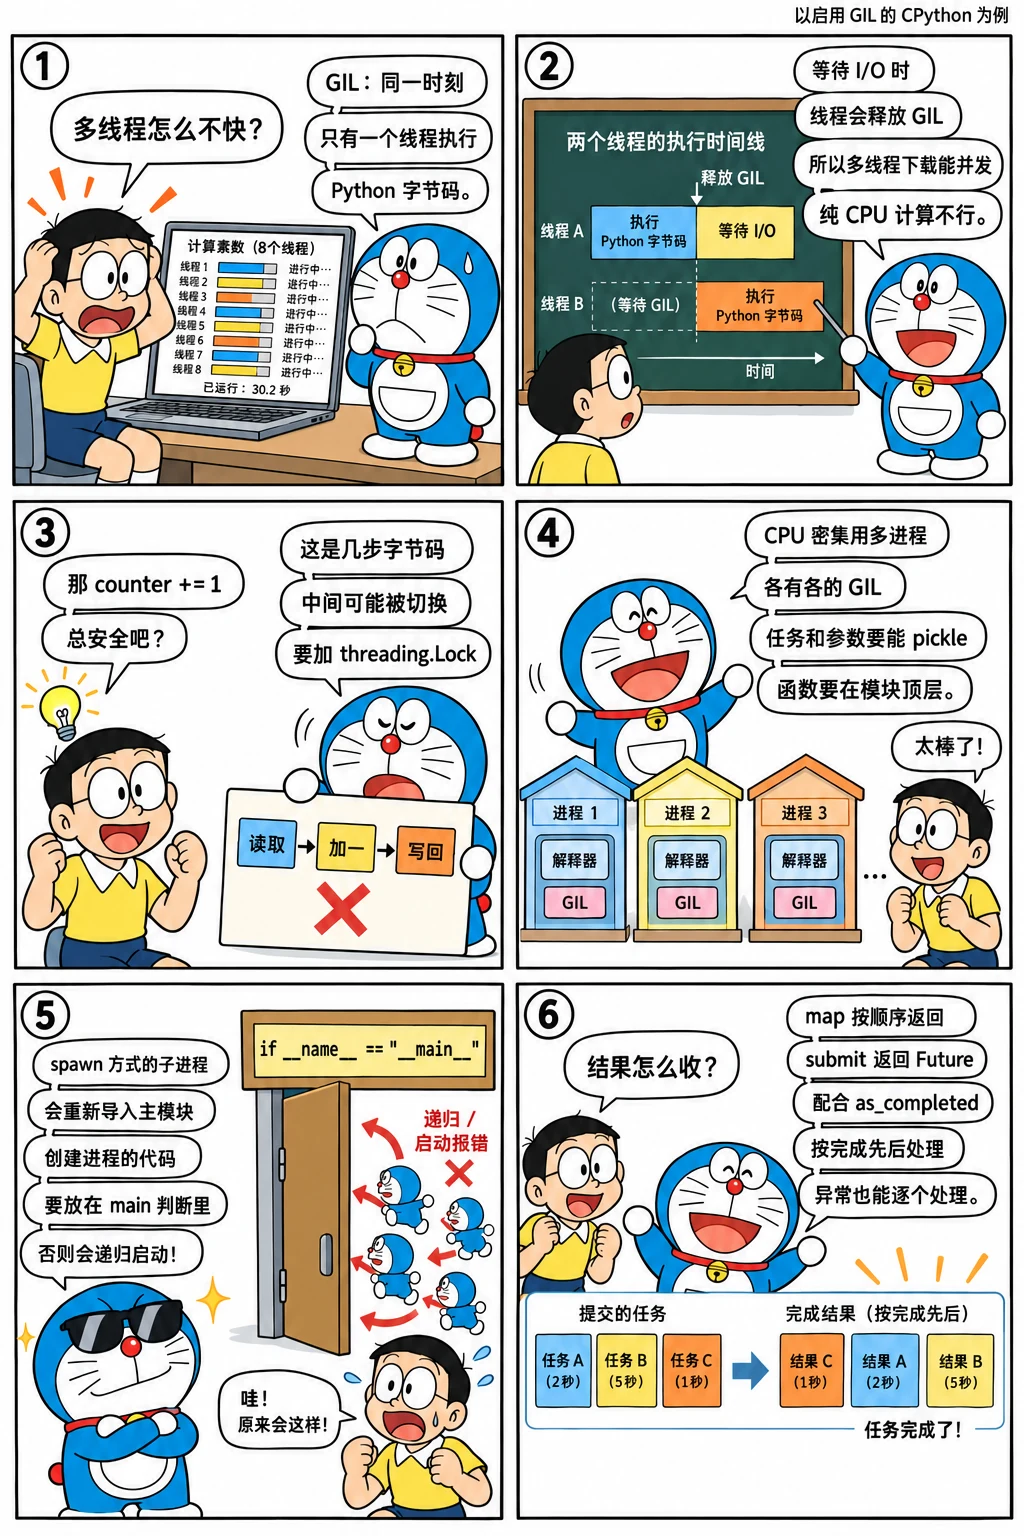
- 全局解释器锁:同一时刻只有一个线程执行 Python 字节码。等待 I/O(网络、磁盘)时线程会释放 GIL,所以多线程下载能并发;算素数是纯 Python 的 CPU 计算,线程只能轮流执行,不会变快。
- 不安全:它是"读取、加一、写回"几步字节码,线程可能在中间被切换,丢失更新。要用
threading.Lock保护。 - 任务函数和参数都要能被 pickle 序列化(传给子进程),所以函数要定义在模块的顶层,不能是 lambda 或嵌套函数。
- 在 spawn 方式(Windows、macOS 的默认)下,子进程会重新导入主模块;如果创建进程的代码不在这个判断里,子进程又会去创建子进程,无限递归。
map按输入的顺序返回结果,某个任务抛出的异常在取到它的结果时才抛出;submit返回Future,配合as_completed按完成的先后处理结果,能逐个处理异常、显示进度。
先看一个六格小剧场,再读正文:
先分清两类任务
| I/O 密集型 | CPU 密集型 | |
|---|---|---|
| 时间花在哪 | 等网络、等磁盘、等数据库 | 计算:解析、压缩、图像处理、数值运算 |
| 例子 | 爬虫、调用 API、读写文件 | 算哈希、训练模型、大规模数据转换 |
| 适合的并发方式 | 线程、asyncio | 多进程、C 扩展(NumPy 等)、自由线程版 Python |
GIL:全局解释器锁
CPython 有一把全局解释器锁(GIL):同一时刻只有一个线程在执行 Python 字节码。所以:
- CPU 密集型任务:多线程不会更快,线程之间只是轮流执行,还多了切换的开销。
- I/O 密集型任务:线程在等待 I/O(
socket.recv、time.sleep、读文件)时会释放 GIL,别的线程可以继续运行。所以多线程对 I/O 任务依然非常有效。 - NumPy、zlib、hashlib 等 C 扩展在做大量计算时也会释放 GIL。
自由线程版 Python
3.13 起提供了可选的自由线程(free-threaded)构建版本,去掉了 GIL,3.14 起它已经是官方正式支持的版本(PEP 779),但仍然不是默认版本。用 uv 可以安装它:uv python install 3.14t,解释器叫 python3.14t。它能让纯 Python 的 CPU 密集型代码真正并行,代价是单线程性能略有下降,部分 C 扩展还没适配。在它成为默认之前,下面讲的规则依然适用。
线程基础
import threading
import time

def download(name, seconds, results):
    time.sleep(seconds)                       # 模拟网络等待,会释放 GIL
    results[name] = f"{name} done"

results = {}
start = time.perf_counter()
threads = [
    threading.Thread(target=download, args=(f"file{i}", 0.2, results))
    for i in range(5)
]
for t in threads:
    t.start()
for t in threads:
    t.join()                                  # 等待所有线程结束
elapsed = time.perf_counter() - start

assert len(results) == 5
assert elapsed < 0.5                          # 5 个 0.2 秒的任务并发执行,总共约 0.2 秒
实际代码里很少直接创建 Thread,通常用下面讲的线程池。
竞态条件与锁
counter += 1 不是原子操作:它是"读取、加一、写回"三步,线程可能在中间被切换,导致更新丢失。多个线程修改共享的可变状态时,必须加锁:
import threading

class Counter:
    def __init__(self):
        self.value = 0
        self._lock = threading.Lock()

    def increment(self):
        with self._lock:                      # 同一时刻只有一个线程能进入
            self.value += 1

counter = Counter()

def work():
    for _ in range(10_000):
        counter.increment()

threads = [threading.Thread(target=work) for _ in range(8)]
for t in threads:
    t.start()
for t in threads:
    t.join()
assert counter.value == 80_000
不要依赖 GIL 来保证线程安全
有 GIL 时,没加锁的代码"好像"也常常能得到正确结果,但这只是运气。在自由线程版 Python 里,数据竞争会频繁得多。共享可变状态就加锁,或者更好的做法是:不共享状态,用队列传递消息。
其他同步原语:
| 工具 | 用途 |
|---|---|
Lock |
互斥锁 |
RLock |
可重入锁:同一个线程可以多次获取 |
Event |
一个线程通知其他线程"某件事发生了"(比如停止信号) |
Semaphore(n) |
最多允许 n 个线程同时进入(限流) |
Condition |
等待某个条件成立,比较底层 |
queue.Queue |
线程安全的队列,首选的线程通信方式 |
生产者-消费者:用队列传递数据
import queue
import threading

tasks: queue.Queue = queue.Queue()
results = []
results_lock = threading.Lock()

def worker():
    while True:
        item = tasks.get()
        if item is None:                      # 约定的结束信号
            tasks.task_done()
            break
        with results_lock:
            results.append(item * item)
        tasks.task_done()

workers = [threading.Thread(target=worker) for _ in range(3)]
for w in workers:
    w.start()
for n in range(10):
    tasks.put(n)
for _ in workers:
    tasks.put(None)                           # 每个 worker 一个结束信号
tasks.join()                                  # 等待所有任务被处理
for w in workers:
    w.join()

assert sorted(results) == [n * n for n in range(10)]
concurrent.futures:用线程池和进程池
concurrent.futures 提供了统一的高层接口。绝大多数并发需求用它就够了:
import time
from concurrent.futures import ThreadPoolExecutor, as_completed

def fetch(url):
    time.sleep(0.1)                           # 模拟网络请求
    if "bad" in url:
        raise ConnectionError(f"cannot reach {url}")
    return f"<html of {url}>"

urls = ["a.com", "b.com", "bad.com", "c.com"]

# 方式一:map,结果顺序和输入一致;遇到异常时,在取到那个结果时抛出
with ThreadPoolExecutor(max_workers=4) as pool:
    it = pool.map(fetch, ["a.com", "b.com"])
    assert list(it) == ["<html of a.com>", "<html of b.com>"]

# 方式二:submit + as_completed,谁先完成先处理谁,并且能逐个处理异常
ok, failed = {}, {}
with ThreadPoolExecutor(max_workers=4) as pool:
    futures = {pool.submit(fetch, url): url for url in urls}
    for fut in as_completed(futures):
        url = futures[fut]
        try:
            ok[url] = fut.result()
        except ConnectionError as e:
            failed[url] = str(e)

assert set(ok) == {"a.com", "b.com", "c.com"}
assert failed == {"bad.com": "cannot reach bad.com"}
with块结束时会等待所有任务完成并关闭线程池。- 任务里的异常不会自动打印,会存在
Future里,直到你调用result()才抛出。只submit不取结果,异常就被悄悄吞掉了。 fut.result(timeout=5)可以设置等待的超时。- 线程池大小:I/O 任务可以开到几十,默认值是
min(32, CPU 数 + 4)。
多进程:真正的并行计算
每个进程有自己的解释器和 GIL,所以多进程能让 CPU 密集型任务利用多个核心。ProcessPoolExecutor 和线程池的接口完全一样:
import math
import time
from concurrent.futures import ProcessPoolExecutor

def count_primes(limit):
    count = 0
    for n in range(2, limit):
        if all(n % d for d in range(2, math.isqrt(n) + 1)):
            count += 1
    return count

def main():
    jobs = [60_000] * 4

    start = time.perf_counter()
    serial = [count_primes(n) for n in jobs]
    t_serial = time.perf_counter() - start

    start = time.perf_counter()
    with ProcessPoolExecutor(max_workers=4) as pool:
        parallel = list(pool.map(count_primes, jobs))
    t_parallel = time.perf_counter() - start

    assert serial == parallel == [6057] * 4
    print(f"serial {t_serial:.2f}s, 4 processes {t_parallel:.2f}s")

if __name__ == "__main__":
    main()
在 4 核以上的机器上,并行版本通常能快 2 到 4 倍。使用多进程要注意:
- 必须有
if __name__ == "__main__":保护。 子进程会重新导入主模块,没有保护的话,子进程又会去创建进程池,无限套娃。 - 任务函数和参数都要能被 pickle。 函数必须定义在模块顶层(不能是 lambda 或嵌套函数),参数和返回值要能序列化。
- 进程间通信有开销。 参数和结果都要序列化后跨进程传输,所以每个任务的计算量要足够大,别把几百万个小任务逐个提交(用
map的chunksize参数分批)。 - 启动方式。 Linux 上 3.14 起默认的启动方式从
fork改成了forkserver,行为和 macOS/Windows 的spawn更接近:子进程不会继承父进程的全局状态。
3.14 的新选择:InterpreterPoolExecutor
3.14 新增了 concurrent.futures.InterpreterPoolExecutor:在同一个进程里运行多个子解释器,每个子解释器有自己的 GIL,能真正并行,启动和通信的开销比多进程小。它还比较新,部分 C 扩展不支持子解释器,可以先在非关键场景尝试。
选型表
| 场景 | 推荐方案 |
|---|---|
| 少量 I/O 任务并发(调几十个 API、下载一批文件) | ThreadPoolExecutor |
| 大量 I/O 并发(上千个连接)、长连接、WebSocket | asyncio(见下一章) |
| CPU 密集型,纯 Python 代码 | ProcessPoolExecutor;或尝试自由线程版 Python |
| CPU 密集型,数值计算 | NumPy / Polars 等向量化库(内部释放 GIL 并使用多核) |
| 在 asyncio 程序里调用阻塞函数 | asyncio.to_thread |
| 后台定时任务、需要可靠重试和持久化的任务 | 任务队列:Celery、RQ、Dramatiq 等 |
怎么讲清楚
讲 GIL:同一时刻只有一个线程执行 Python 字节码,但 I/O 等待和很多 C 扩展(NumPy、PyTorch 的算子)会释放 GIL,所以多线程能加速下载、不能加速纯 Python 的计算;counter += 1 是"读—改—写"多条字节码,不是原子的,共享状态要加锁或改成用 queue.Queue 传消息。CPU 密集用多进程:任务函数和参数要能被 pickle(函数定义在模块顶层),启动代码放在 if __name__ == "__main__": 里(spawn 方式会重新导入主模块)。推理框架正是因此把分词、调度、GPU 执行拆成多个进程,用 ZMQ 传消息(见 SGLang 的多进程结构)。
练习
1. 并发抓取并限流。 用 ThreadPoolExecutor 并发"抓取" 20 个 URL(用 time.sleep(0.05) 模拟),要求同一时刻最多 5 个请求在进行,并统计最大并发数来验证。
参考答案
import threading
import time
from concurrent.futures import ThreadPoolExecutor

active = 0
peak = 0
lock = threading.Lock()

def fetch(url):
    global active, peak
    with lock:
        active += 1
        peak = max(peak, active)
    try:
        time.sleep(0.05)
        return url.upper()
    finally:
        with lock:
            active -= 1

urls = [f"site{i}.com" for i in range(20)]
with ThreadPoolExecutor(max_workers=5) as pool:     # 线程池大小本身就是并发上限
    pages = list(pool.map(fetch, urls))

assert pages[0] == "SITE0.COM" and len(pages) == 20
assert peak <= 5
如果多个线程池共享同一个下游服务,想做全局限流,可以用一个共享的 threading.Semaphore(5),在 fetch 里 with sem:。
2. 线程安全的单次初始化。 改写装饰器一章练习里的 @once,让它在多线程下也只执行一次。用 16 个线程同时调用来验证。
参考答案
import functools
import threading
import time

def once(func):
    lock = threading.Lock()
    done = False
    result = None

    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        nonlocal done, result
        if done:                         # 快速路径:初始化完成后不再加锁
            return result
        with lock:
            if not done:                 # 双重检查:拿到锁后再确认一次
                result = func(*args, **kwargs)
                done = True
        return result
    return wrapper

calls = []

@once
def init():
    time.sleep(0.05)                     # 放大竞态窗口
    calls.append(1)
    return "ready"

threads = [threading.Thread(target=init) for _ in range(16)]
for t in threads:
    t.start()
for t in threads:
    t.join()
assert calls == [1] and init() == "ready"
小结
- GIL 让同一时刻只有一个线程执行 Python 字节码,但 I/O 等待时会释放。
- I/O 密集用线程或 asyncio;CPU 密集用多进程或向量化库。
- 共享可变状态必须加锁;更好的做法是用
queue.Queue传递消息。 - 优先使用
concurrent.futures;记得调用result(),否则异常会被吞掉。 - 多进程代码放在
if __name__ == "__main__":里,任务函数定义在模块顶层。
本章练习题(1 道)
在浏览器里直接写代码、跑测试;也可以在本地用 python practice/judge.py 判题。
- 17. 用 Condition 实现有界阻塞队列(中等,需要本地 Python)
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题