值语义、对象生命周期与 RAII
C++ 和 Python、Java 最大的区别不在语法,而在对象模型:变量就是对象本身,赋值就是拷贝,对象在确定的时刻被销毁。把"资源的释放"绑在"对象的销毁"上,就是 RAII——C++ 管理显存、文件、锁、通信句柄的统一方式。
自测:能答上来就可以跳过本章
std::vector<int> b = a;之后修改b,a会变吗?Python 里的b = a呢?- 一个作用域里先后构造了
x、y、z,离开作用域时按什么顺序析构? - 函数返回的临时对象什么时候被销毁?绑定到
const T&上会怎样? - 构造函数抛出异常时,析构函数会被调用吗?已经构造好的成员呢?
- 什么是"零法则"和"五法则"?一个类里有裸指针成员时,默认的拷贝构造函数会做什么?
自测参考答案(先自己答,再展开对照)
- 不会:
b是a的一份独立拷贝。Python 的b = a只是让两个名字指向同一个列表,修改b就是修改a。 - 按构造的相反顺序:先
z,再y,最后x。 - 在整个完整表达式(通常就是这一条语句)结束时销毁。绑定到
const T&(或T&&)局部引用上时,临时对象的生命周期被延长到这个引用的作用域结束(只延长一层)。 - 不会:对象没有构造完成,它的析构函数不会被调用。但已经构造好的成员和基类会按相反的顺序被析构——所以每个资源都要由一个 RAII 成员持有,而不是在构造函数体里手动获取。
- 零法则:类不直接管理资源,全部交给 RAII 成员,五个特殊成员函数都用编译器生成的;五法则:直接管理资源的类要自己定义(或删除)析构、拷贝构造、拷贝赋值、移动构造、移动赋值。有裸指针成员时,默认的拷贝构造只复制指针(浅拷贝),两个对象析构时就会重复释放。
先看一个六格小剧场,再读正文:
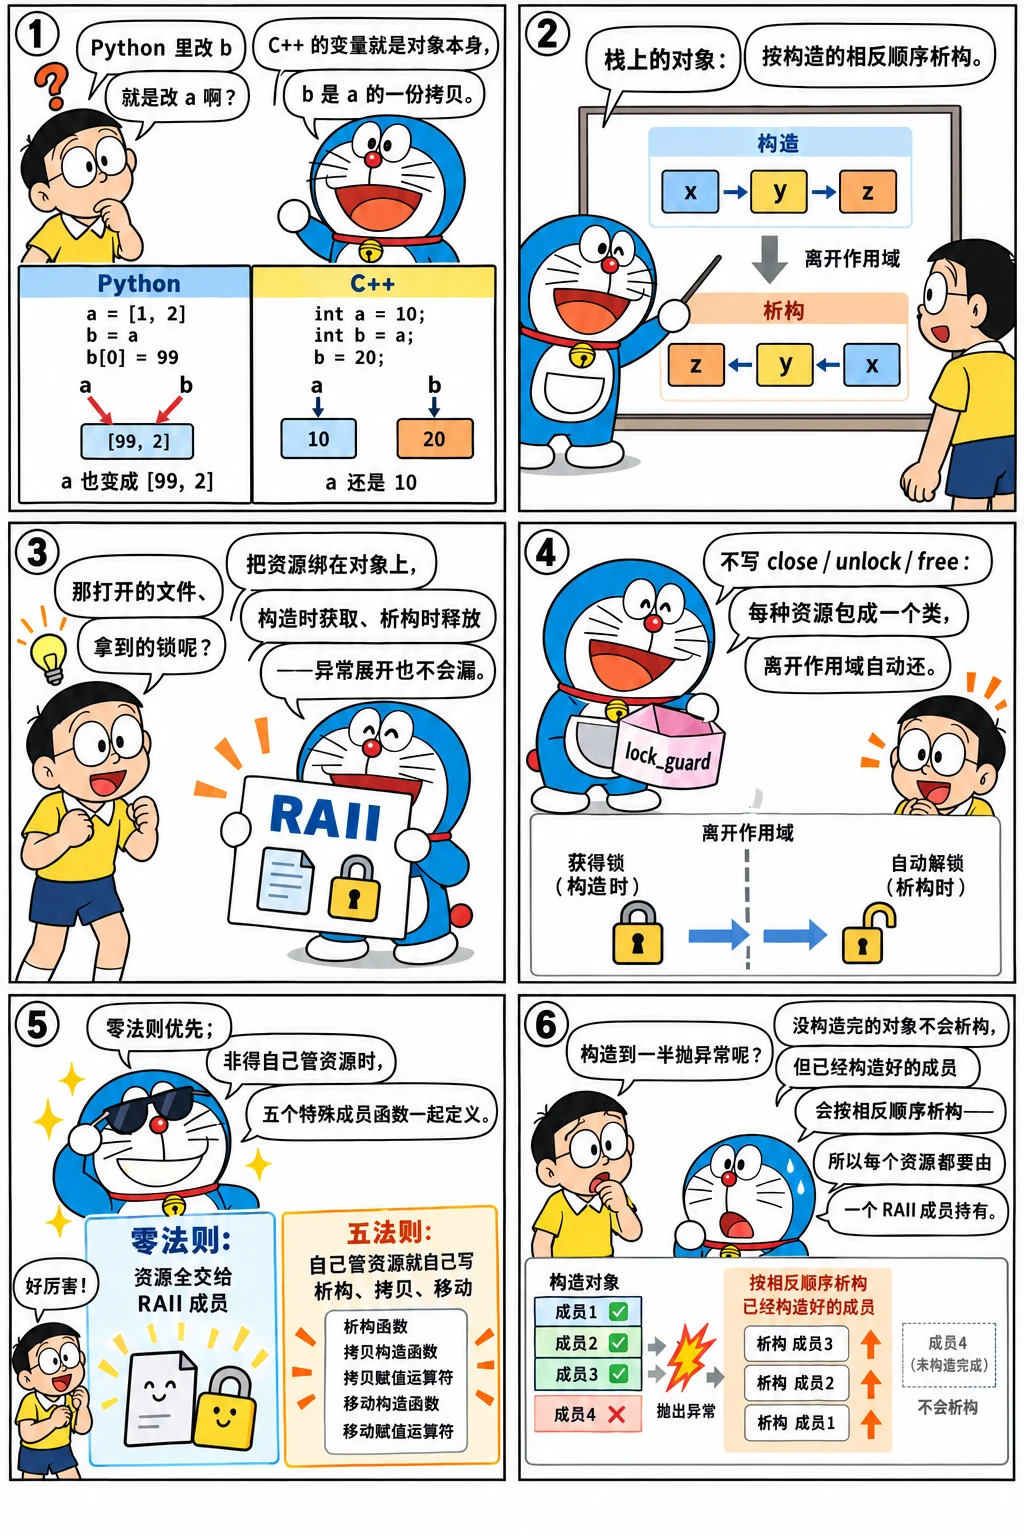
值语义:变量就是对象
Python 里的变量是贴在对象上的标签,b = a 让两个标签贴在同一个列表上。C++ 里的变量就是对象本身,b = a 会把 a 的内容拷贝一份到 b:
#include <cstdio>
#include <vector>

int main() {
  std::vector<int> a = {1, 2, 3};
  std::vector<int> b = a;    // 拷贝:b 有自己的一份元素
  b.push_back(4);
  std::vector<int>& r = a;   // 引用:r 是 a 的另一个名字,不是新对象
  r[0] = 100;
  std::printf("a.size=%zu a[0]=%d b.size=%zu b[0]=%d\n", a.size(), a[0], b.size(), b[0]);
}
值语义的好处是局部推理:拿到一个值,就不用担心别处有人悄悄改它。代价是拷贝可能很贵——拷贝一个装了 100 万个 token 的 vector 就是 4 MB 的内存复制。所以函数参数的约定是:
| 参数写法 | 什么时候用 |
|---|---|
T x(按值) |
小对象(int、指针、std::string_view、std::span),或者函数本来就要保存一份(配合移动,见下一章) |
const T& x |
只读的大对象 |
T& x |
要修改调用者的对象(输出参数),尽量少用,返回值通常更清楚 |
T* x |
可以为空的、"可选的"参数,或者 C 风格接口 |
对象的生命周期
对象从构造函数执行完开始存在,到析构函数开始执行时结束。什么时候析构,由对象的存储期决定:
- 自动存储期(局部变量):离开作用域时析构,按构造的相反顺序;
- 动态存储期(
new出来的):delete时析构——这正是容易出错的地方,下一节用 RAII 把它变成自动的; - 静态存储期(全局变量、
static局部变量):程序结束时析构; - 临时对象:在所在的完整表达式(通常就是那一条语句)结束时析构;如果绑定到一个
const T&或T&&局部引用上,寿命延长到引用离开作用域。
用一个会打印构造和析构的类看得最清楚:
#include <cstdio>
#include <string>
#include <utility>

struct Tracer {
  std::string name;
  explicit Tracer(std::string n) : name(std::move(n)) { std::printf("构造 %s\n", name.c_str()); }
  ~Tracer() { std::printf("析构 %s\n", name.c_str()); }
};

Tracer make(const char* n) { return Tracer(n); }

int main() {
  Tracer a("a");
  {
    Tracer b("b");
    Tracer c("c");
  }                                      // 离开作用域:先析构 c,再析构 b
  make("临时对象");                       // 返回值没人接:这条语句结束时就析构
  const Tracer& r = make("被引用延长");    // 绑定到 const 引用:活到 r 离开作用域
  std::printf("main 结束 %s\n", r.name.c_str());
}
注意 make 里的 return Tracer(n); 只构造了一次:C++17 起,用同类型的临时对象初始化另一个对象时保证省略拷贝,返回值直接构造在调用者的位置上。
寿命延长只延长一层
const T& r = f(); 能延长 f() 返回的临时对象,但 const std::string& name = make("x").name; 这种"临时对象的成员"、
或者一个函数把参数引用原样返回(const T& id(const T& x) { return x; },再写 const T& r = id(T{});),都不会延长,r 立刻悬垂。
最常见的坑是范围 for 循环:for (auto& tok : get_request().tokens) 在 C++23 之前,get_request() 返回的临时对象在循环开始前就已经销毁了。
RAII:把资源绑在对象上
RAII(Resource Acquisition Is Initialization,资源获取即初始化):在构造函数里获取资源,在析构函数里释放资源。因为析构的时机是确定的——正常离开作用域、return、抛出异常都会触发——资源就不会泄漏。
推理系统里的资源几乎都这样管理:显存(cudaMalloc / cudaFree)、CUDA stream 和 event、NCCL 通信器、文件描述符、mmap 出来的权重文件、互斥锁、注册给 RDMA 网卡的内存。
下面用一对假的 fake_malloc / fake_free 代替 cudaMalloc / cudaFree,并统计还有多少块没释放:
#include <cstdio>
#include <cstdlib>
#include <stdexcept>

static int live = 0;   // 模拟"还没释放的显存块"数量
void* fake_malloc(std::size_t n) { ++live; return std::malloc(n); }
void fake_free(void* p) { --live; std::free(p); }

class DeviceBuffer {
 public:
  explicit DeviceBuffer(std::size_t bytes) : ptr_(fake_malloc(bytes)), bytes_(bytes) {}
  ~DeviceBuffer() { fake_free(ptr_); }
  DeviceBuffer(const DeviceBuffer&) = delete;              // 独占的资源:禁止拷贝
  DeviceBuffer& operator=(const DeviceBuffer&) = delete;

  void* get() const { return ptr_; }
  std::size_t size() const { return bytes_; }

 private:
  void* ptr_;
  std::size_t bytes_;
};

void forward_step(bool fail) {
  DeviceBuffer hidden(1 << 20);
  DeviceBuffer logits(1 << 16);
  if (fail) throw std::runtime_error("kernel 启动失败");
  std::printf("  前向完成,当前未释放 %d 块\n", live);
}

int main() {
  forward_step(false);
  std::printf("正常返回后:%d 块\n", live);
  try {
    forward_step(true);
  } catch (const std::exception& e) {
    std::printf("捕获异常:%s,%d 块\n", e.what(), live);
  }
}
forward_step 里没有一行释放代码,但无论正常返回还是中途抛异常,两块"显存"都被释放了。对比 C 风格的写法:每个 return 前都要记得释放、每个出错分支都要 goto cleanup,漏一处就泄漏。
= delete 那两行很重要:DeviceBuffer 独占一块资源,被拷贝就会出现"两个对象释放同一块内存"。禁止拷贝之后,想转移所有权就用移动(下一章)。
默认拷贝的陷阱
如果忘了禁止拷贝,编译器生成的默认拷贝构造函数会逐个成员拷贝——对裸指针来说,就是只拷贝地址。这个程序有 bug:
#include <cstdlib>

struct Buffer {
  float* data;
  explicit Buffer(int n) : data(static_cast<float*>(std::malloc(n * sizeof(float)))) {}
  ~Buffer() { std::free(data); }
};

int main() {
  Buffer a(1024);
  Buffer b = a;   // 默认拷贝:只拷贝了指针,a 和 b 指向同一块内存
}                 // b 先析构释放一次,a 再析构释放同一个指针
==12345==ERROR: AddressSanitizer: attempting double-free on 0x625000002100 in thread T0:
    #1 in Buffer::~Buffer() double_free.cpp:6
零法则与五法则
这就引出了 C++ 里管理资源的两条规则:
- 五法则:如果一个类需要自定义析构函数(说明它直接管理资源),那它几乎一定也要自定义(或删除)拷贝构造、拷贝赋值、移动构造、移动赋值这另外四个;
- 零法则:更好的做法是让类不直接管理资源,把资源交给已经写好的 RAII 成员(
std::vector、std::unique_ptr、std::string、自己写的DeviceBuffer),然后一个特殊成员函数都不写,编译器生成的就是对的。
实际工程里,只有少数"最底层的句柄类"(包一个 cudaStream_t、一个文件描述符、一个 NCCL 通信器)需要按五法则手写;其余的类都应该遵守零法则。
构造函数失败时
构造函数抛出异常时,这个对象的析构函数不会被调用(对象从来没有完整存在过),但已经构造好的成员和基类会被析构。
所以一个类要持有多个资源时,让每个资源各自是一个 RAII 成员,而不是在构造函数里依次 malloc 两个裸指针——第二个失败时第一个就漏了。本章练习 2 就是这个场景。
作用域守卫:自定义的"离开时做什么"
有些清理动作不值得专门写一个类,比如"如果后面的步骤失败,就把刚才预留的 KV 块还回去"。可以写一个通用的作用域守卫,析构时执行一个函数,成功时调用 dismiss() 取消:
#include <cstdio>
#include <utility>

template <class F>
class ScopeExit {
 public:
  explicit ScopeExit(F f) : f_(std::move(f)) {}
  ~ScopeExit() {
    if (active_) f_();
  }
  void dismiss() { active_ = false; }
  ScopeExit(const ScopeExit&) = delete;
  ScopeExit& operator=(const ScopeExit&) = delete;

 private:
  F f_;
  bool active_ = true;
};

bool schedule(bool prefill_ok) {
  std::printf("预留 KV 块\n");
  ScopeExit rollback([] { std::printf("回滚:释放预留的 KV 块\n"); });
  if (!prefill_ok) return false;       // 提前返回:守卫自动回滚
  std::printf("prefill 成功,提交\n");
  rollback.dismiss();                  // 成功:取消回滚
  return true;
}

int main() {
  schedule(false);
  schedule(true);
}
这和 Go 的 defer、Rust 的 Drop 是同一个思想。std::lock_guard / std::scoped_lock(离开作用域时解锁)、std::unique_ptr(离开作用域时释放)都是标准库里现成的 RAII 类。
怎么讲清楚
讲值语义与 RAII:C++ 的变量就是对象本身,b = a 是拷贝(Python 的 b = a 只是多了一个名字);局部对象离开作用域时按构造的相反顺序析构,临时对象在完整表达式结束时析构,绑定到 const T& 能延长一层寿命。RAII 把资源绑在对象上:构造时获取、析构时释放,正常返回、提前返回、异常都会释放——锁、文件、CUDA 流和事件都这样管理。构造函数抛异常时析构函数不会被调用,但已经构造好的成员会被析构,所以多个资源要分别交给 RAII 成员。直接管理资源的类按"五法则"处理拷贝和移动(通常禁止拷贝),其余的类遵守"零法则"。
练习
-
下面的程序会按什么顺序打印?先写下你的答案,再看参考答案。
参考答案
成员按声明的顺序构造,与初始化列表里写的顺序无关;析构顺序相反。g++ -Wall 会对这种写法给出 -Wreorder 警告,因为如果 model 的初始化依赖 cache,就会用到一个还没构造的成员。
#include <cstdio>

struct Log {
  const char* n;
  explicit Log(const char* s) : n(s) { std::printf("构造 %s\n", n); }
  ~Log() { std::printf("析构 %s\n", n); }
};

struct Engine {
  Log scheduler{"scheduler"};
  Log cache;
  Log model;
  Engine() : model("model"), cache("cache") {}   // 这里的顺序不决定构造顺序
};

int main() { Engine e; }
- 一个类要同时持有一块"锁页内存"和一块"显存",第二次分配可能失败抛出
std::bad_alloc。写出一个不会泄漏的版本,并用计数器证明:构造失败时没有未释放的块,构造成功时有 2 块,离开作用域后回到 0。
参考答案
让每块内存各自是一个 RAII 成员。第二个成员构造失败时,第一个成员已经构造完成,会被自动析构:
#include <cstdio>
#include <cstdlib>
#include <new>

static int live = 0;

struct Block {
  void* p = nullptr;
  explicit Block(std::size_t n, bool fail = false) {
    if (fail) throw std::bad_alloc();
    p = std::malloc(n);
    ++live;
  }
  ~Block() {
    std::free(p);
    --live;
  }
  Block(const Block&) = delete;
  Block& operator=(const Block&) = delete;
};

struct PinnedPair {        // 每个资源都是一个 RAII 成员,类本身遵守零法则
  Block host;
  Block device;
  PinnedPair(std::size_t n, bool fail) : host(n), device(n, fail) {}
};

int main() {
  try {
    PinnedPair p(1024, true);
  } catch (const std::bad_alloc&) {
    std::printf("构造失败,未释放 %d 块\n", live);
  }
  {
    PinnedPair p(1024, false);
    std::printf("构造成功,%d 块\n", live);
  }
  std::printf("离开作用域,%d 块\n", live);
}
如果写成 PinnedPair(n) { host = malloc(n); device = alloc_or_throw(n); } 这种在构造函数体里依次分配裸指针的写法,第二步抛异常时 PinnedPair 的析构函数不会运行,host 就泄漏了。
小结
- C++ 变量就是对象本身,赋值是拷贝;大对象按
const T&传递,要保存一份时按值传递再移动。 - 局部对象离开作用域时按构造的相反顺序析构;临时对象在语句结束时析构,绑定到
const T&可以延长一层。 - RAII:构造时获取资源,析构时释放。正常返回、提前返回、异常都会释放,是 C++ 管理一切资源的方式。
- 直接管理资源的类要按五法则处理拷贝和移动(通常是禁止拷贝);其余的类遵守零法则,把资源交给 RAII 成员。
- 构造函数失败时,已经构造好的成员会被析构,所以多个资源要分别用 RAII 成员持有。
本章练习题(1 道)
C++ 题在本地判题:python practice/judge.py test <题号> 用 g++ / clang++ 编译,并在 sanitizer 下运行。
- 25. RAII 文件描述符(简单,C++ 本地判题)
发现错误或有更好的写法?在 GitHub 上编辑此页提交问题